上一篇文章将一句原则落实成了工程实践:只解码一次,在内存中流式处理,只编码一次。水印、字幕烧录和多片段 TTS 混音全部放入同一个 Complex Filtergraph。CPU 利用率提高了,中间文件消失了,渲染时间也缩短了。
但这种方案也有代价。Filtergraph 速度快,是因为它把过去存放在磁盘上的中间数据变成了内存中的原始帧队列。输入不断累积且视频越来越长时,图的工作集可能撑爆进程。在内存受限的环境中,例如单个渲染进程或容器 cgroup,通常会以 OOM 告终。
这个问题在 VMEG 视频翻译导出流水线中很快就会出现:长视频需要烧录多语言字幕、叠加水印,并将数十乃至数百个 TTS 片段混合到同一条时间线上。峰值内存必须保持可预测,同时每个分段仍然只能解码一次、编码一次。
真正的问题:OOM 与文件大小无关
很多人认为,内存激增是因为“视频文件太大”。FFmpeg 并不会把整个 mp4 加载到内存中。真正占用内存的是已经解码、但尚未被下游滤镜消费的数据:视频对应 YUV 帧,音频对应 PCM 数据。
Filtergraph 的峰值内存大致为:
peak ≈ concurrent decoded streams × frame (or PCM block) size × filter queue depth因此,可调节的因素有三个:
- 流数量:同时有多少个 TTS 片段进入 amix?主画面上同时存在多少个叠加流?
- 帧大小:也就是分辨率。4K 帧的像素数是 720p 的 9 倍,因此在队列深度相同时,内存占用也接近 9 倍。
- 图的生命周期:如果一段两小时的视频始终通过同一张图处理,这些队列会一直存活到编码结束。
上一篇文章提出的“将所有处理合并到一条命令中”,适用于输入较少的短片。当流数量和生命周期同时失控时,这套加速方案就会变成制造 OOM 的机器。
❌ 反面做法:用一张图处理整段视频
import ffmpeg

# 2-hour output + 200 TTS clips + hundreds of subtitle overlays, all in one graph
inputs = [ffmpeg.input(f"tts_{i}.wav").audio for i in range(200)]
mixed = ffmpeg.filter(inputs, "amix", inputs=200, duration="longest")
# Same on the video side: main picture, stickers, and subtitles all overlaid together
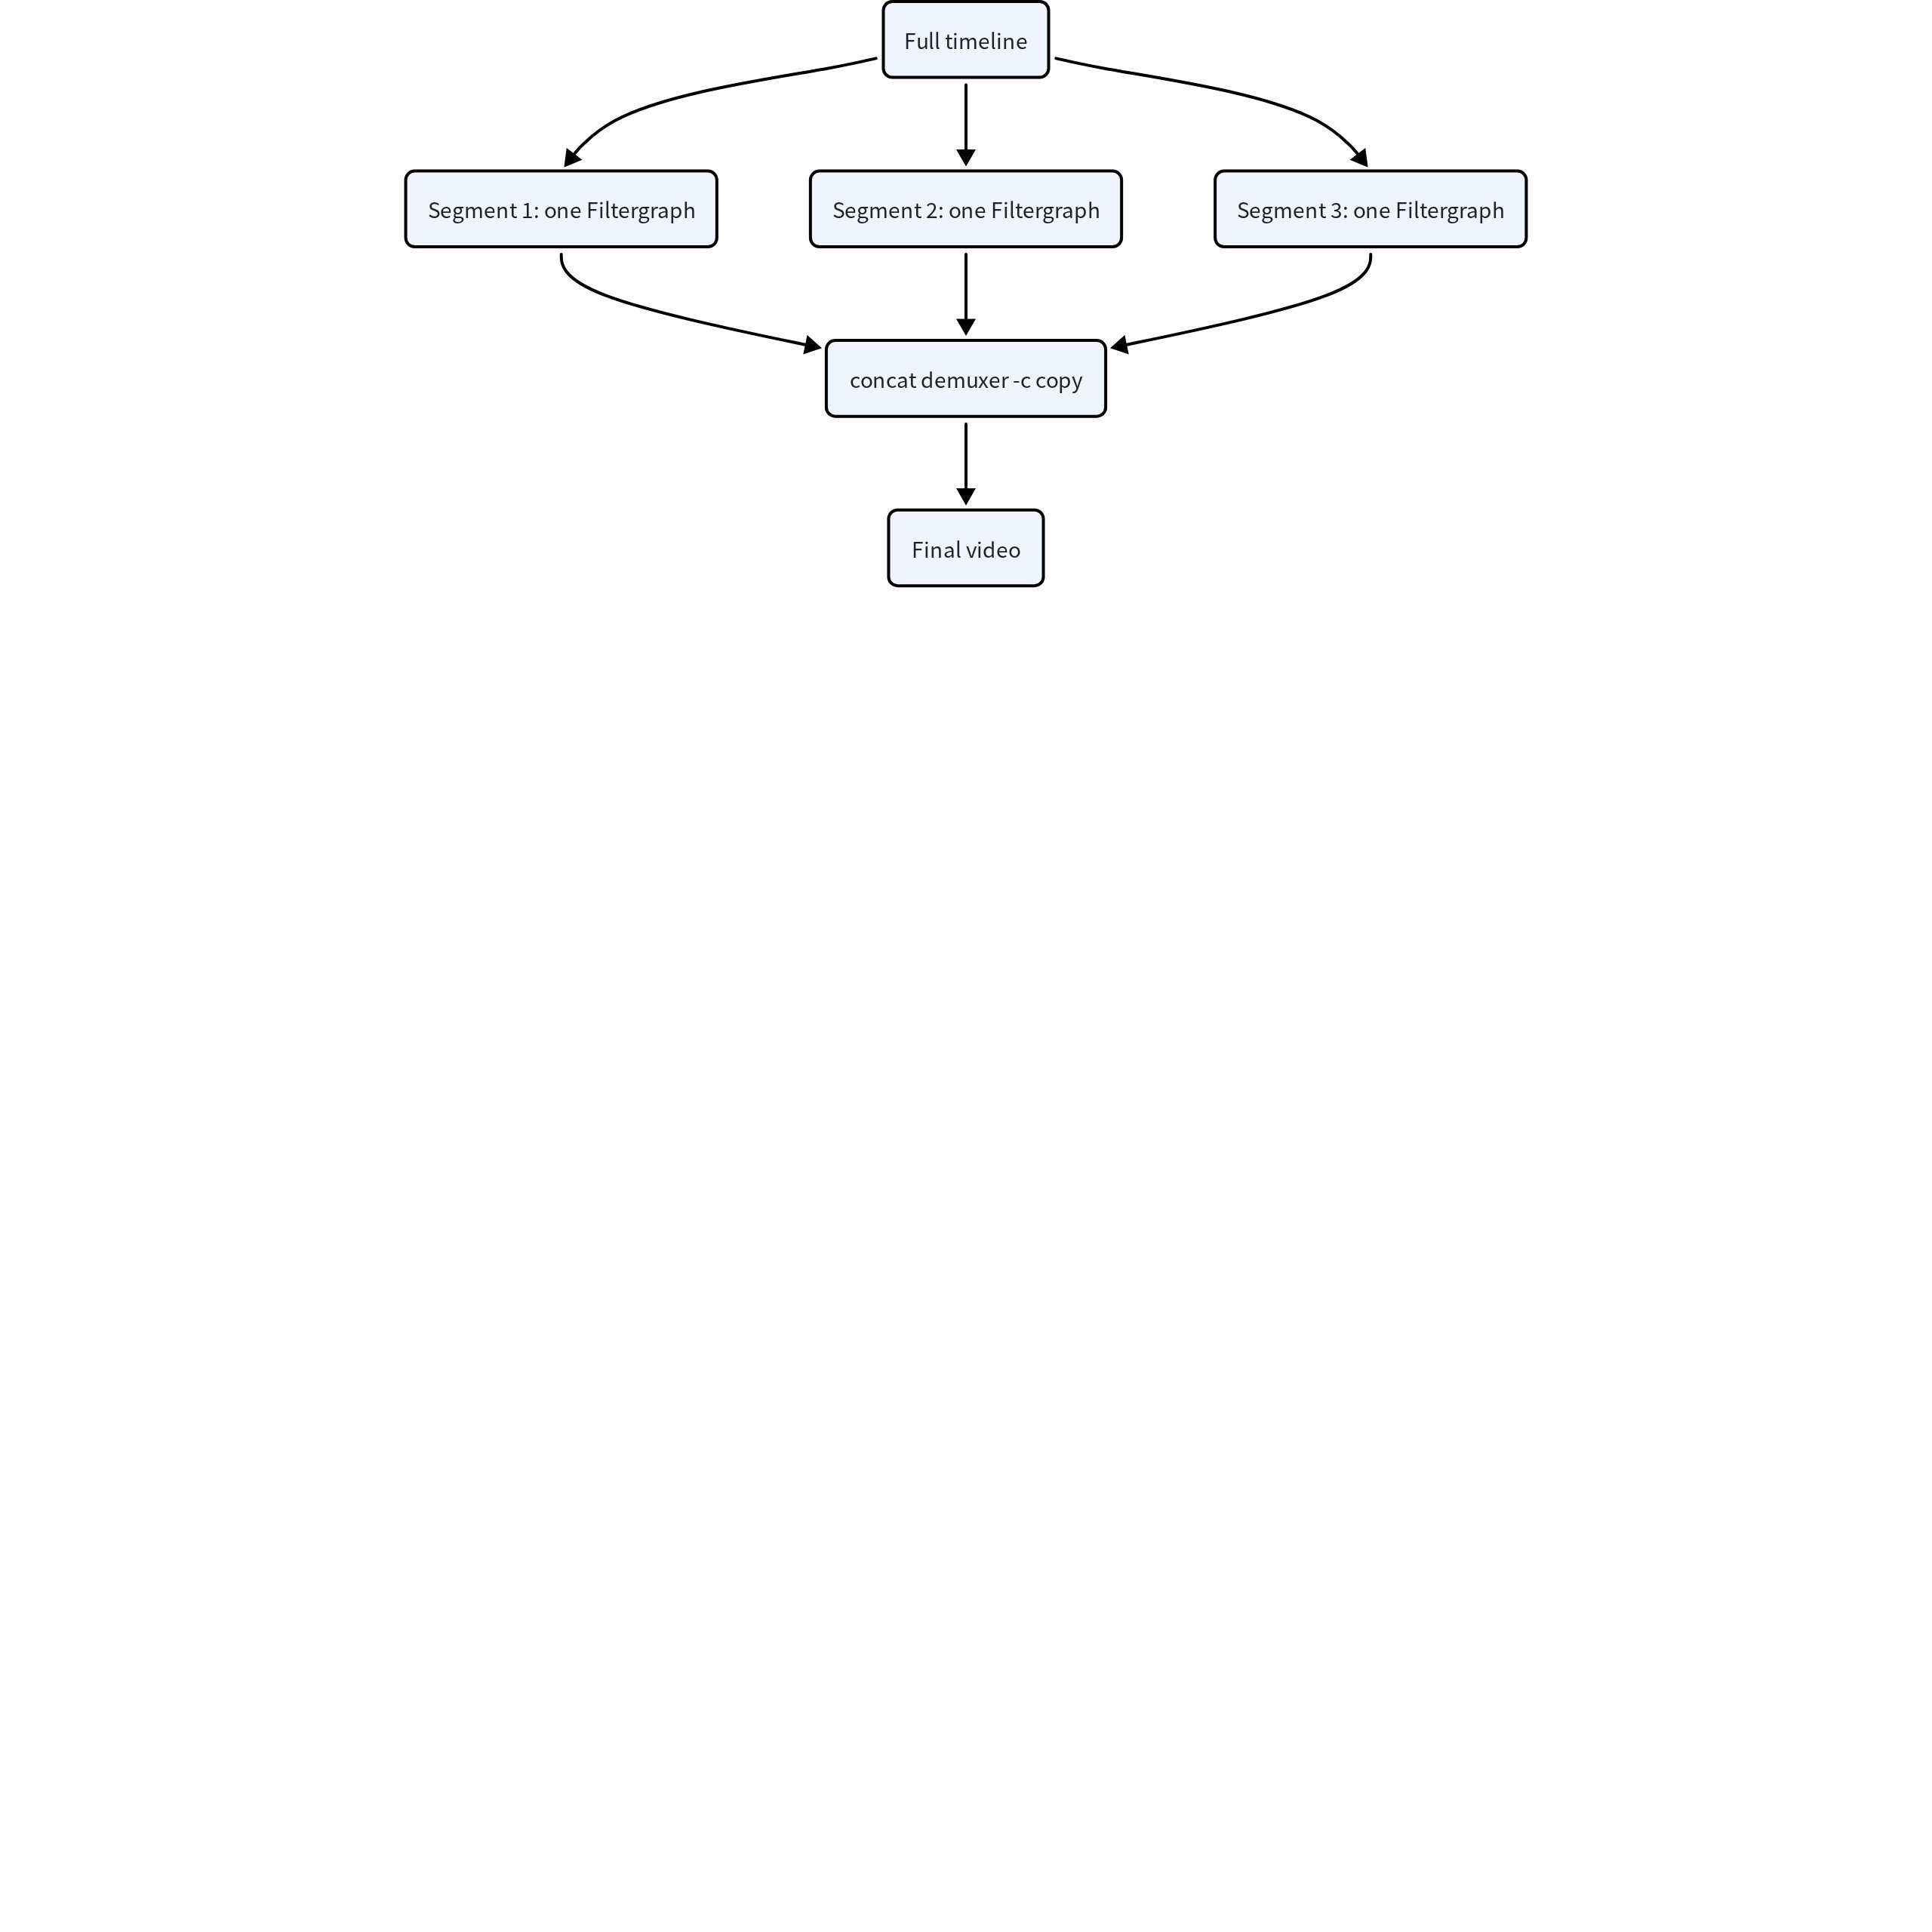
# The process queues decoded data and memory climbs解决办法很明确:为工作量设定上限。不必退回到每个处理步骤执行一条命令的串行脚本,而是将大型图拆成一系列小图。每个分段内部仍然只解码一次、在内存中流式处理、只编码一次。分段之间则使用体积较小的中间文件连接。
切分方式一:按像素秒切分视频,不使用固定时长
单张图不能无限期运行。两小时的 1080p 视频和两分钟的 720p 片段对应的工作集并不相同。
如果始终按 60 秒切分,对 720p 来说往往过于保守,对 4K 来说却仍可能撑爆内存。更稳定的预算方式是让每个分段的像素总量大致保持一致:
segment duration = base duration × base pixel count / current pixel count以 720p(1280×720)和 90 秒为基准:
| 分辨率 | 相对于 720p 的像素数 | 分段时长(限制在 10–300 秒,并与帧对齐) |
|---|---|---|
| 720p | 1× | ≈ 90 秒 |
| 1080p | 2.25× | ≈ 40 秒 |
| 4K | 9× | 达到下限,约 10 秒 |
分辨率越高,帧越大,因此必须缩短分段,才能压低峰值内存。分段时长还应与帧周期对齐,即 round(duration * fps) / fps。否则切点会落在两帧之间,concat 后就会出现重复帧或丢帧。
还有一个容易忽略的上限:每个分段中的叠加节点数量。字幕烧录由一连串 overlay 滤镜组成。节点数量会随字幕数量增加,每条字幕还会挂载一张图片或一个字幕流。我们将每个分段的字幕数量限制在几十条以内。达到上限后,切点会向后移动到下一条字幕的起始位置,避免单张图无限增长。
切分后,时长不足约 1 秒的片段会合并到前一个分段。极短片段对降低内存几乎没有帮助,却会增加 concat 步骤,并让编码器反复冷启动。
每个分段内部仍然使用上一篇文章中的复合图:主画面、字幕和水印全部在内存中处理完毕,只执行一次编码。分段之间先写入普通视频文件,再通过 concat demuxer 和 -c copy 拼接。复制过程不会重新编码,因此增加的编码次数等于分段数量,而不是“分段数量 × 处理步骤数量”。
切分方式二:音频的内存特性不同,不要把所有内容都送入 amix
视频工作集主要由帧大小决定。音频的故障模式有所不同:amix 会保留每一路输入,直到时长最长的输入结束。视频本地化通常会产生数十乃至数百个 TTS 片段。将它们全部送入同一个 amix,意味着要同时解码并缓冲所有 PCM 数据。
处理方法很简单:每张图只对数量受限的流执行 amix,写入一个中间文件,再由 concat 按时间顺序拼接各个分块。分段时长无须预先固定,直接取这组片段在时间线上覆盖的区间。语音密集时,分段较短;语音稀疏时,分段较长。峰值取决于“同时混合多少路流”,而不是“这个分块持续多少秒”。
❌ 用一个 amix 混合 200 路流
streams = [ffmpeg.input(f"tts_{i}.wav").audio.filter("adelay", delays=str(i * 1000), all=True) for i in range(200)]
out = ffmpeg.filter(streams, "amix", inputs=200, duration="longest")
✅ 分批限制 amix 的输入数量,再执行 concat
MAX_MIX = 50
chunks = []
for i in range(0, len(tts_items), MAX_MIX):
    group = tts_items[i : i + MAX_MIX]
    start, end = group[0].start, max(item.end for item in group)
    duration = end - start
    streams = [shifted(item, origin=start) for item in group]
    # Silent bed fills [start, end] so concat can tile the timeline
    base = ffmpeg.input("aevalsrc=0", f="lavfi", t=duration).audio
    mixed = ffmpeg.filter(streams + [base], "amix", inputs=len(streams) + 1, normalize=0)
    path = f"/tmp/mix_{i}.m4a"
    ffmpeg.output(mixed, path, acodec="aac").overwrite_output().run()
    chunks.append(path)

# Chunks are already AAC; concat demuxer -c copy builds the full track
工作流对比:
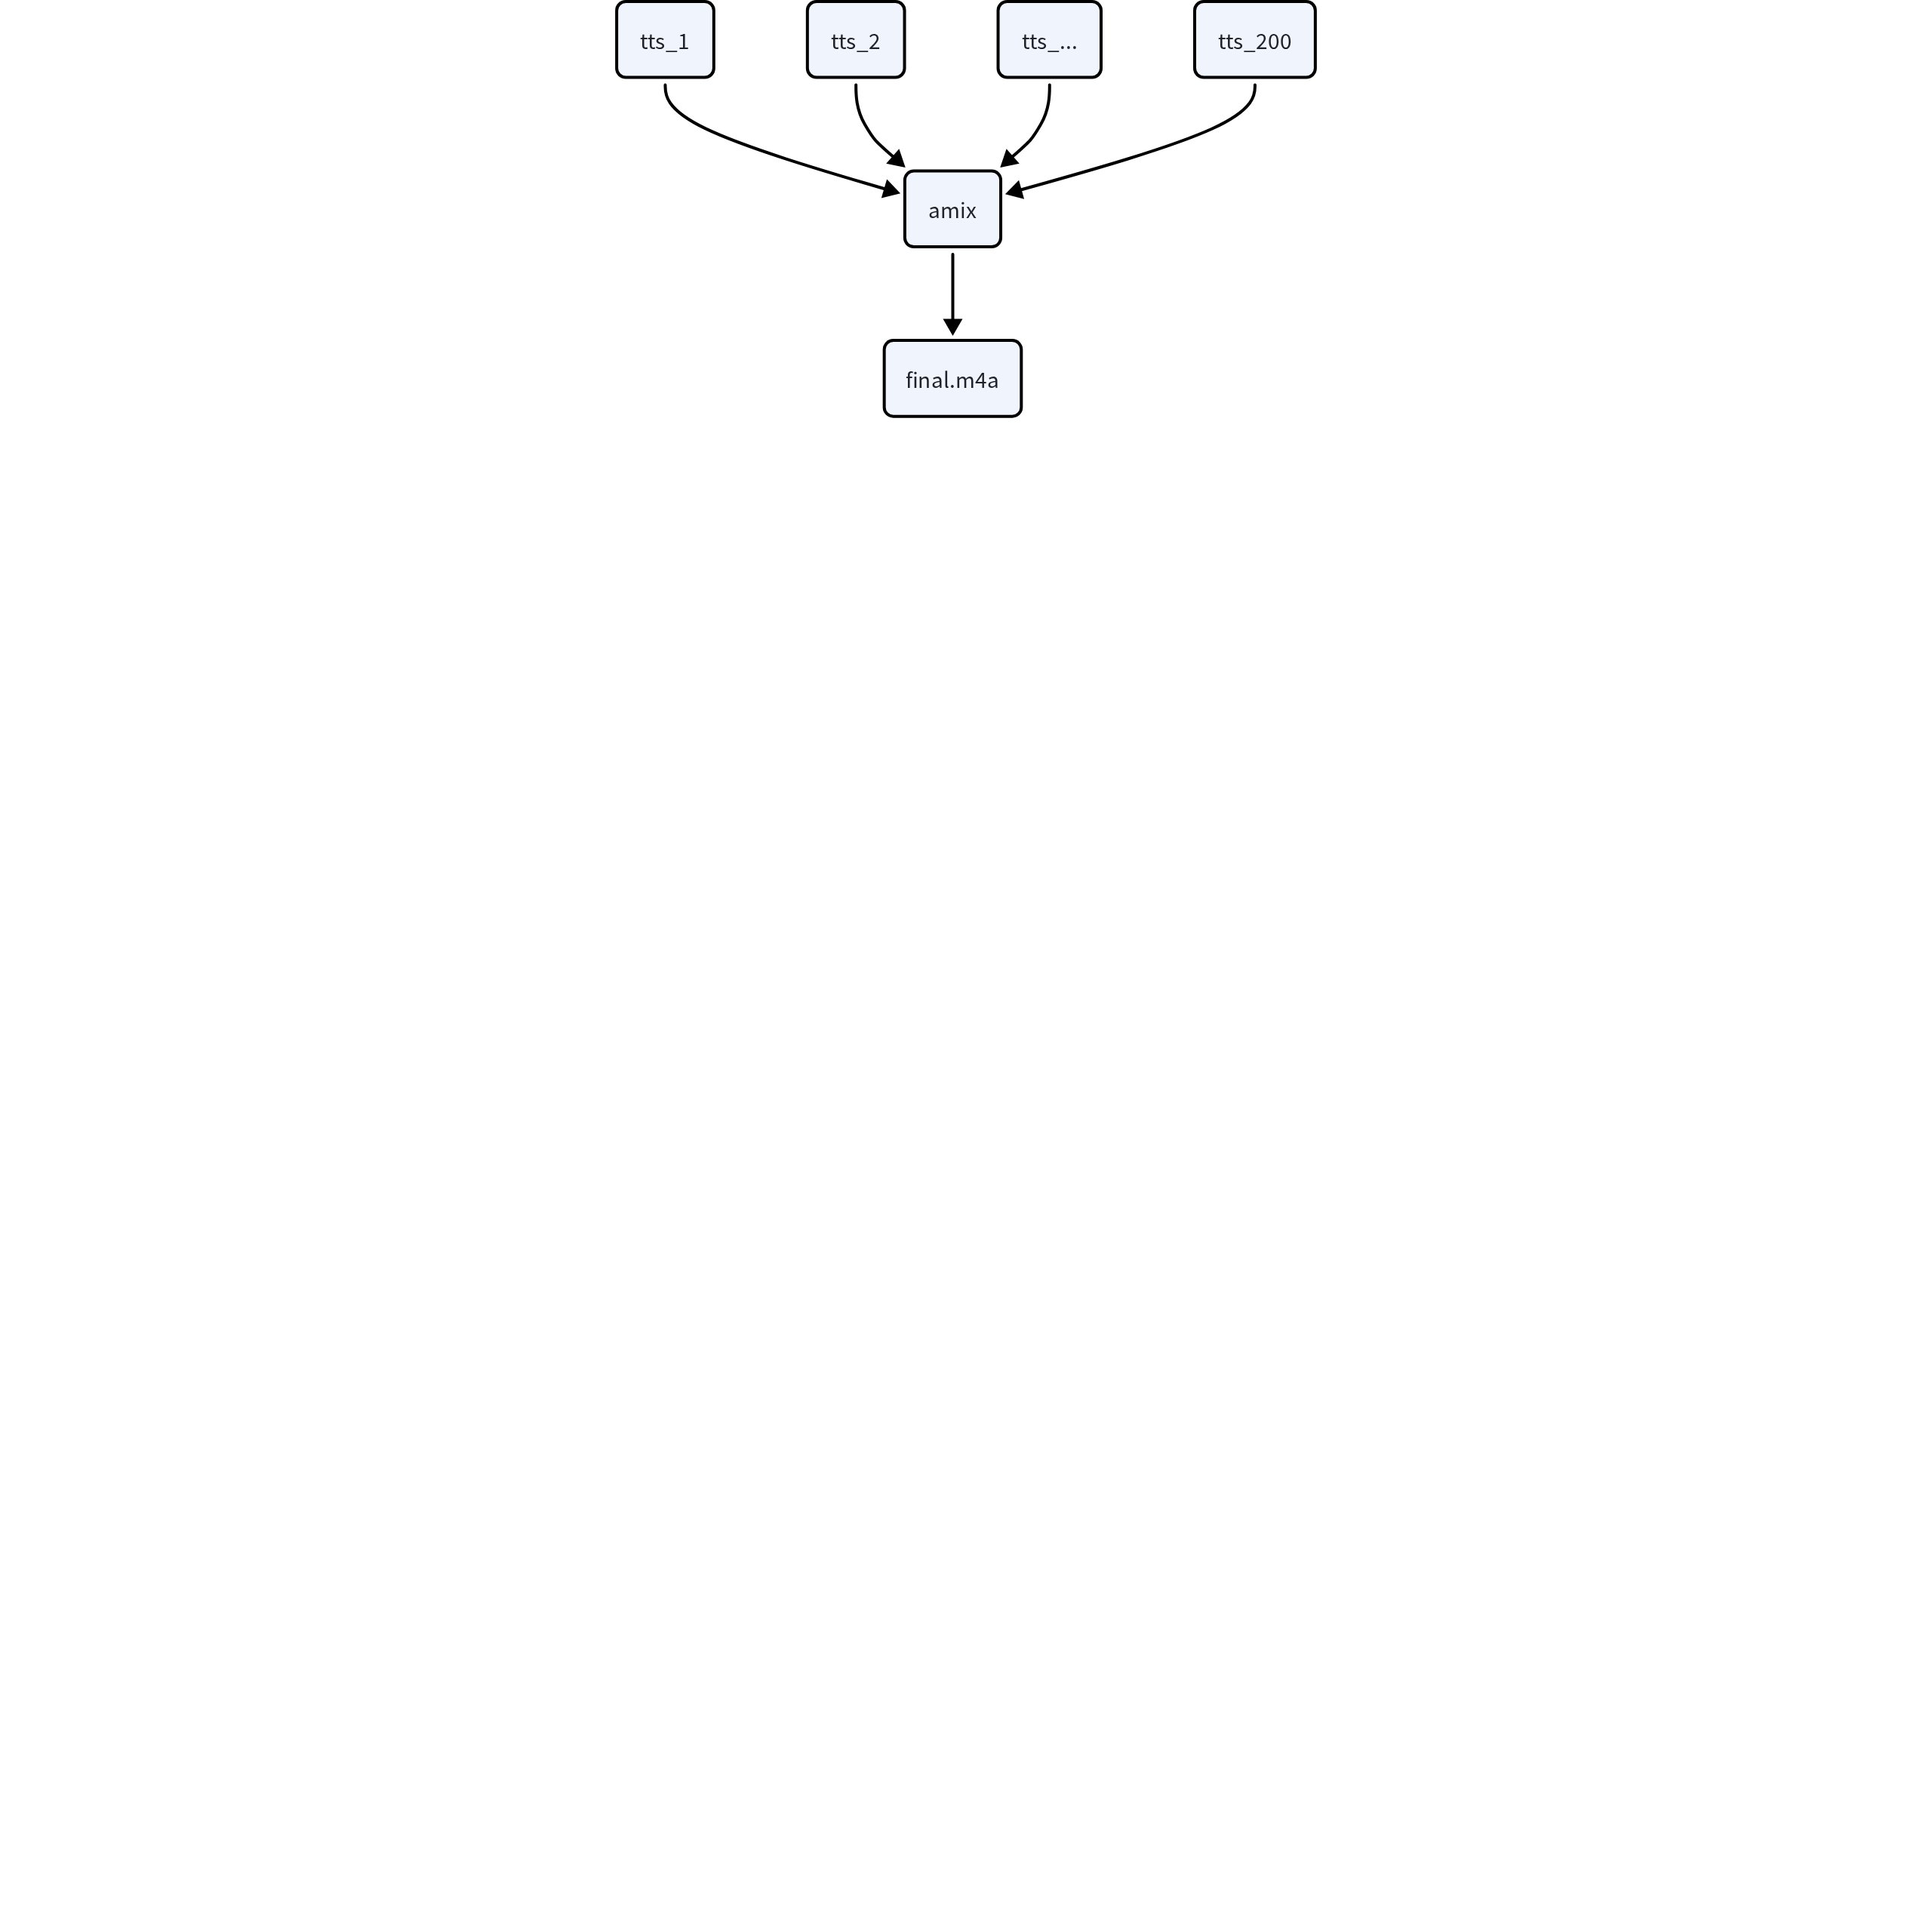
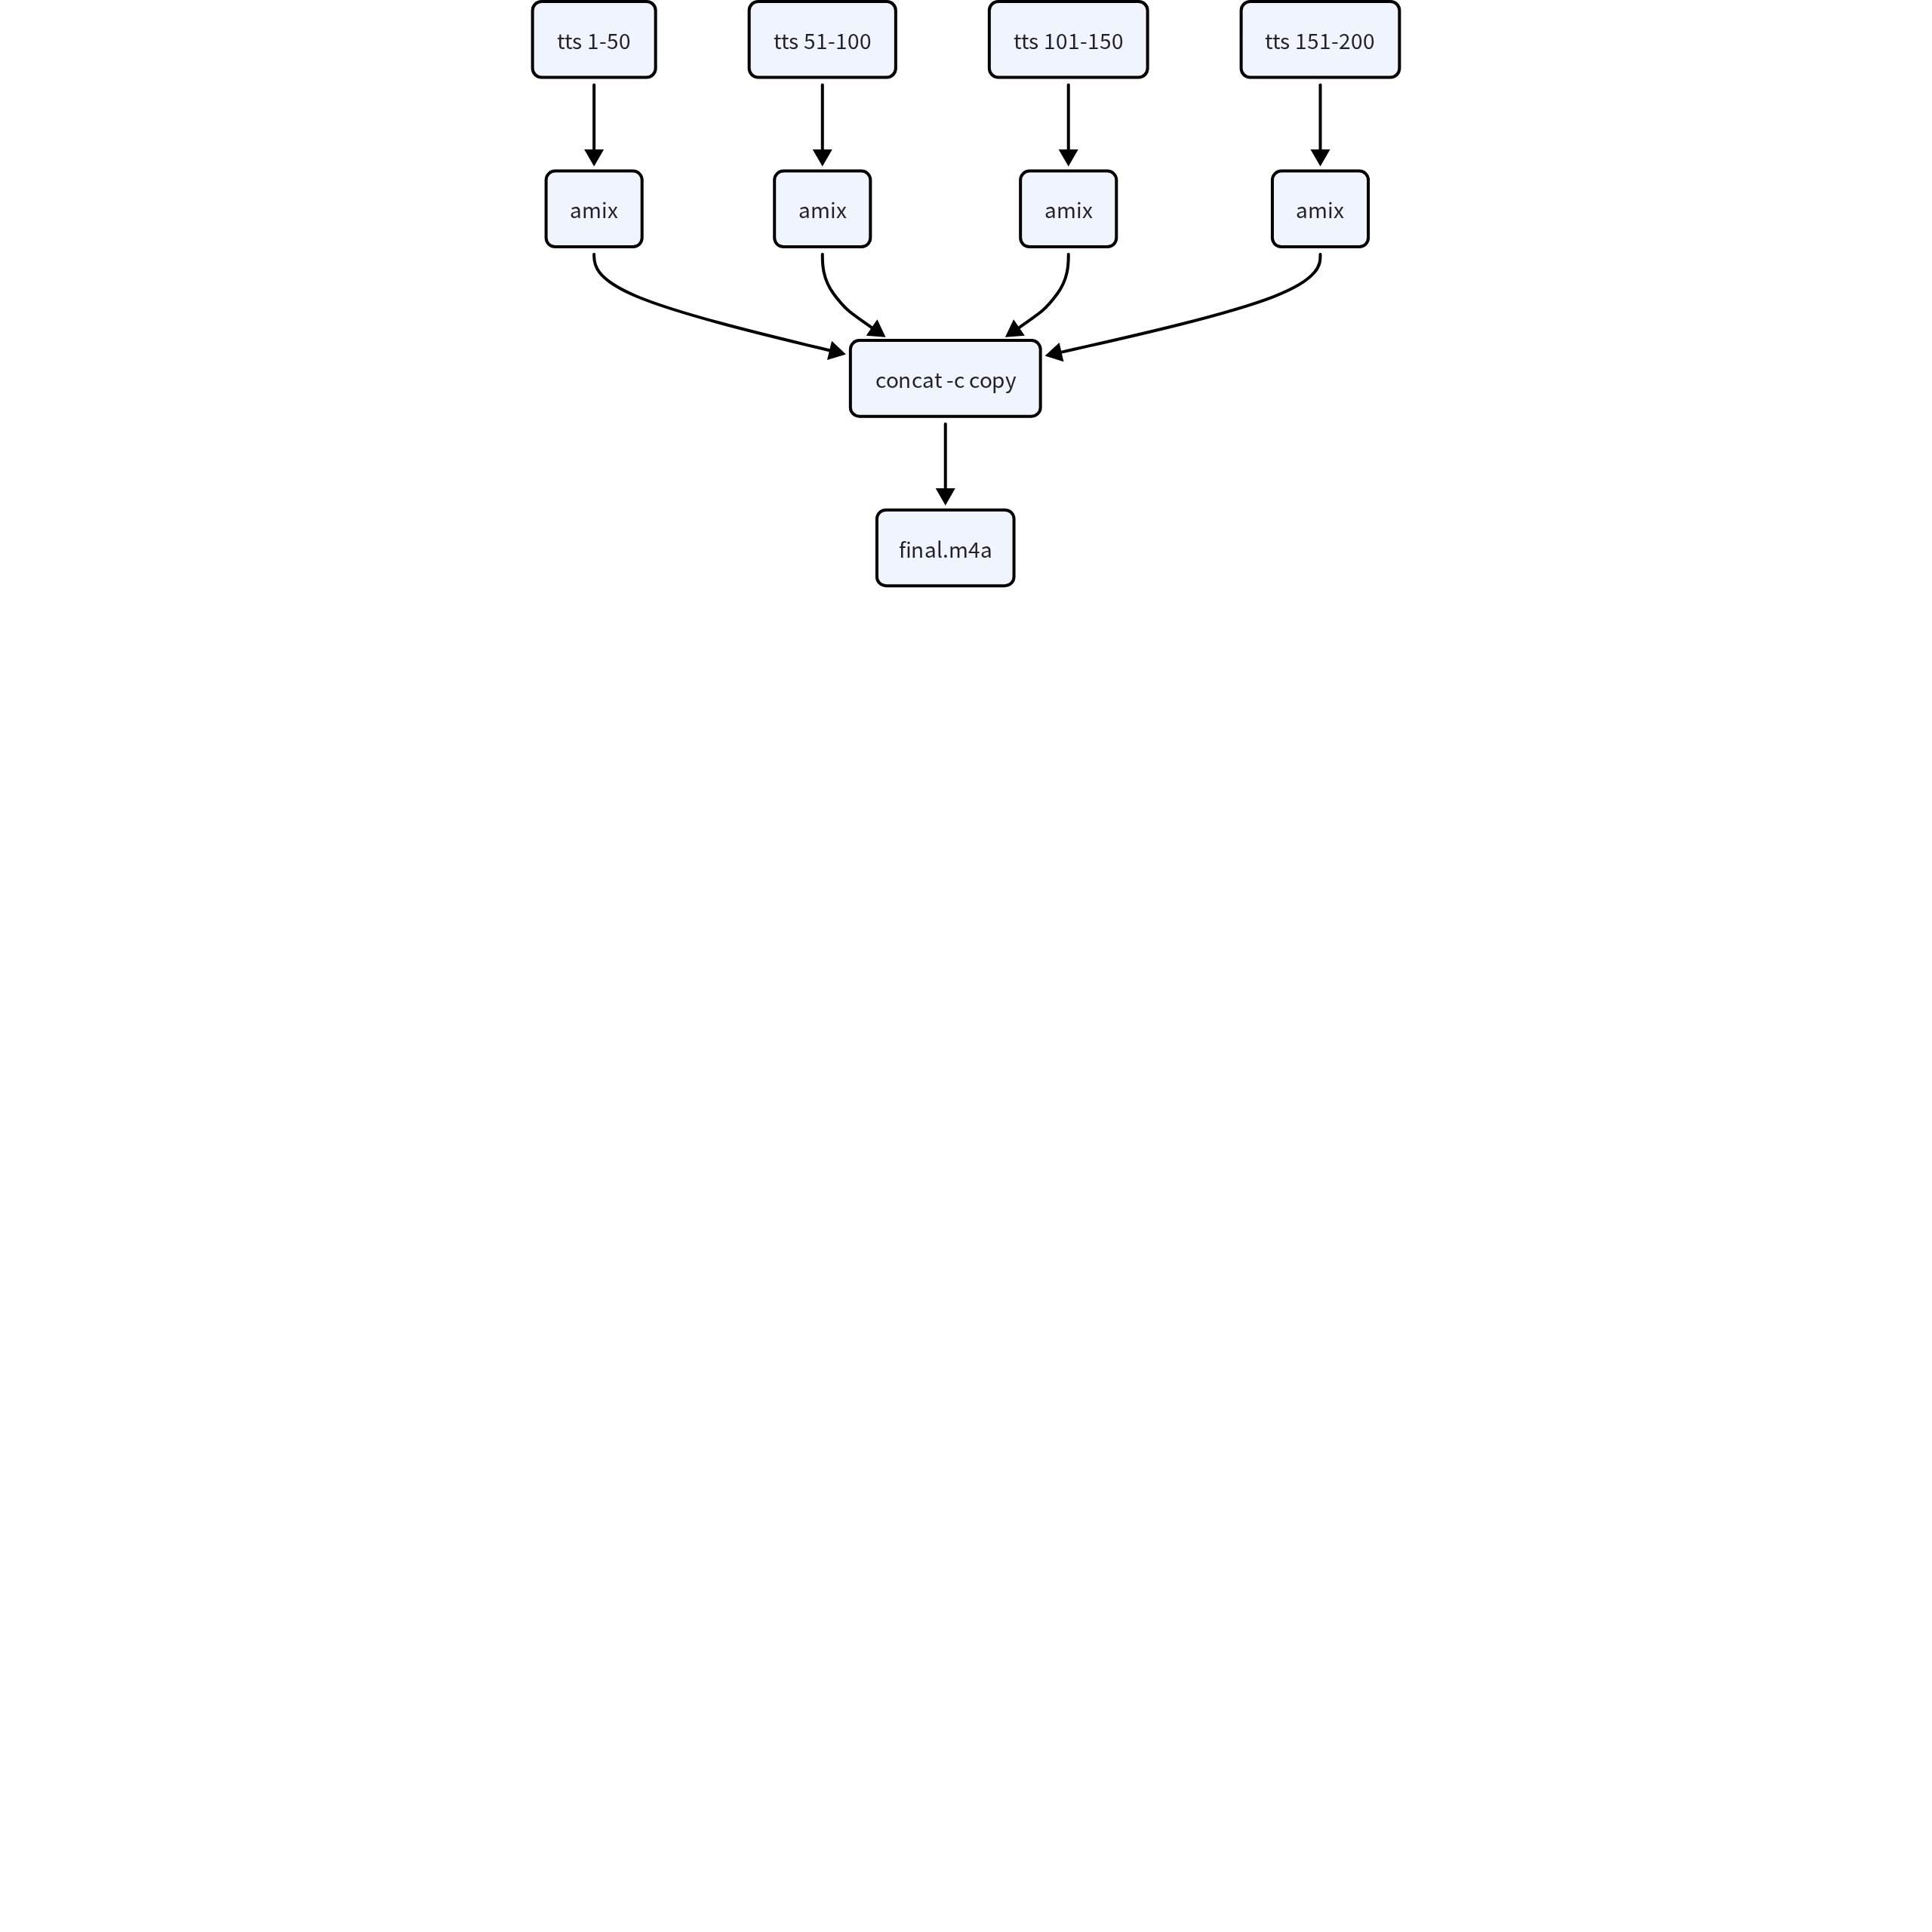
第一张图会同时排队等待处理 200 路 PCM 流。第二种方案最多混合 50 路流,然后使用 -c copy 拼接。每张图最多维持 MAX_MIX + 1 路活动输入。中间文件采用 AAC 编码,而不是 PCM。视频分段按像素量控制预算,音频分段按流数量控制预算,不要混用这两种预算。
另外两个工程细节
Filtergraph 字符串本身也可能变得过大。动态构建的 -filter_complex 可能长达数千甚至数万字符。除了难以调试以外,上一篇文章已经改用 ffmpeg-python 解决了一部分调试问题,但过长的参数仍会触及命令行长度限制。超过阈值后,不要继续把图塞进 argv,而应将其写入脚本文件,再让 FFmpeg 通过 -/filter_complex 读取。
切分后的片段必须能够拼接。视频边界要与帧对齐,音频分块的时长也要对齐,同时合并极短片段,确保使用 -c copy 时,时间戳仍然连续。如果内存控制方案产生了未对齐的碎片,就只能重新编码后再执行 concat,上一篇文章省下来的编码次数也会重新出现。
结论
复合流水线的思路依然正确。要让它能够处理长视频,需要在单张图之外增加工作集预算:
- 限制生命周期:按像素秒切分视频,并单独限制叠加节点数量;按 amix 流数量切分音频,再执行 concat。
- 不要退回分步处理:每个分段内部仍然只解码一次、在内存中流式处理、只编码一次;使用 -c copy 拼接分段,避免切分带来第二次重新编码。
这条原则还需要补充后半句:只解码一次,在内存中流式处理,只编码一次,但必须限制图的规模。
在 VMEG 视频翻译导出链路中,这些限制让长视频渲染的内存占用从“随时长线性增长”变为“可根据分辨率预测”。单台机器也能完成数小时的 AI 配音视频输出。代价是产生更多分段,并增加一次 concat 步骤。好处是进程不会再被 OOM killer 终止。
限制图的规模后,这些分段自然会成为并行处理单元。下一篇文章将介绍如何将它们分发出去,把单机预算转化为多机加速能力。