VMEG AI 研究与洞察
探索 AI 配音、视频本地化与语音处理背后的技术实践。
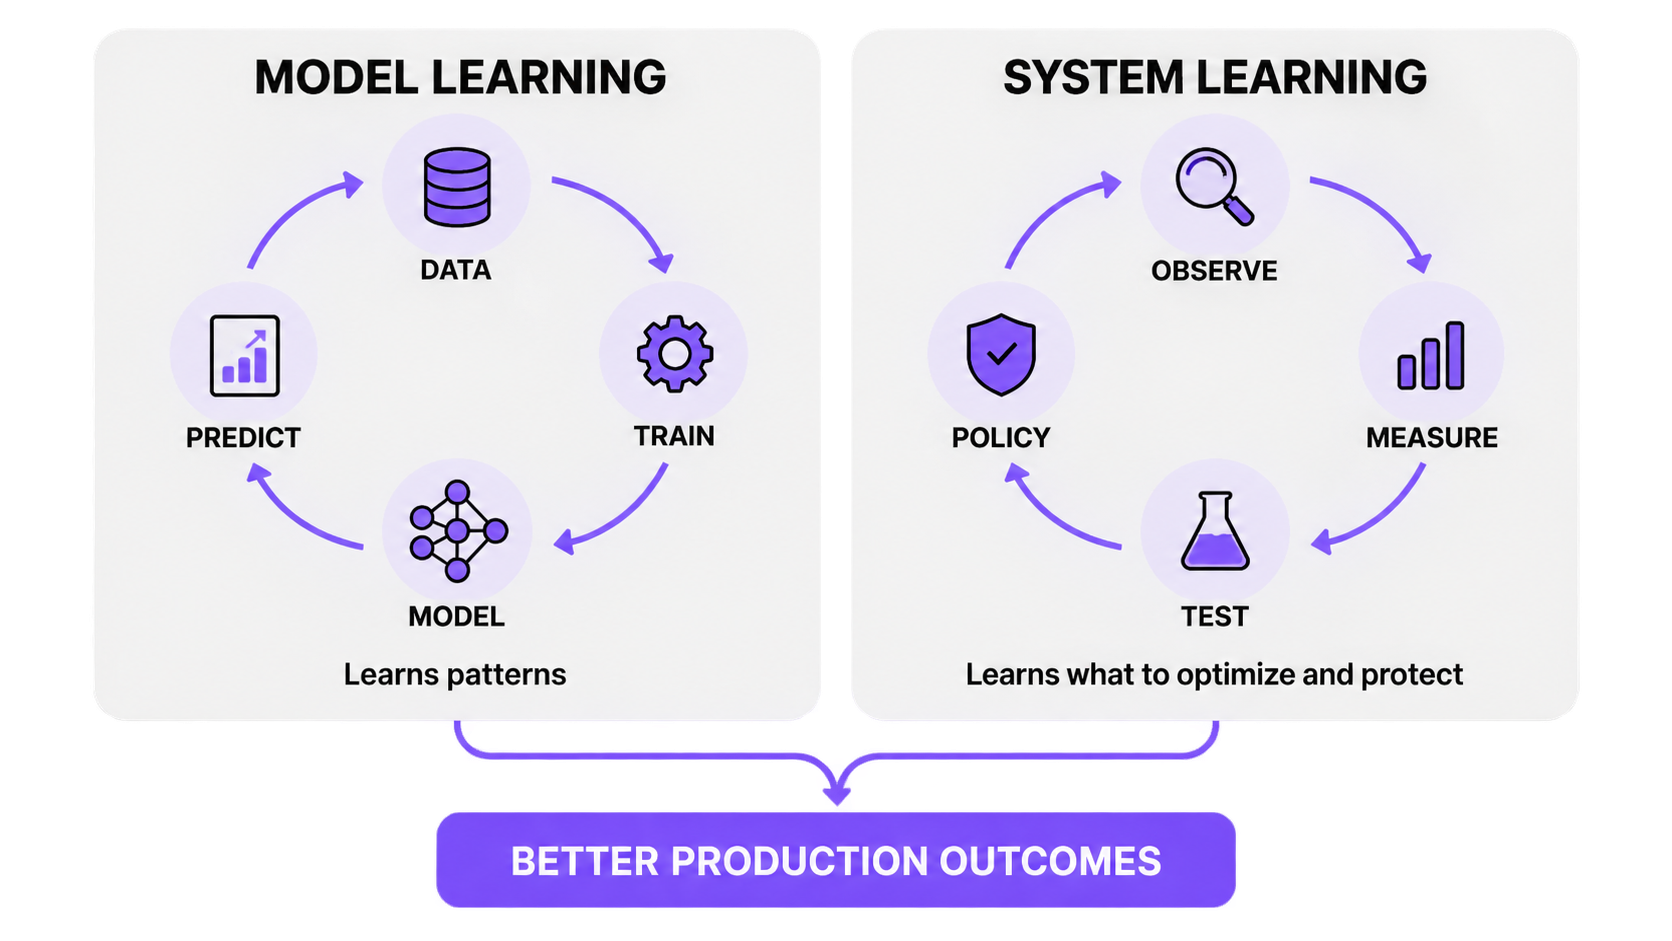
不只是训练模型:复杂算法如何从线上结果中持续学习
持续学习不只发生在模型训练中。本文通过 AI 配音对齐案例,说明生产系统如何依靠观测指标、安全检查、受控回放和线上证据持续改进。
阅读全文 →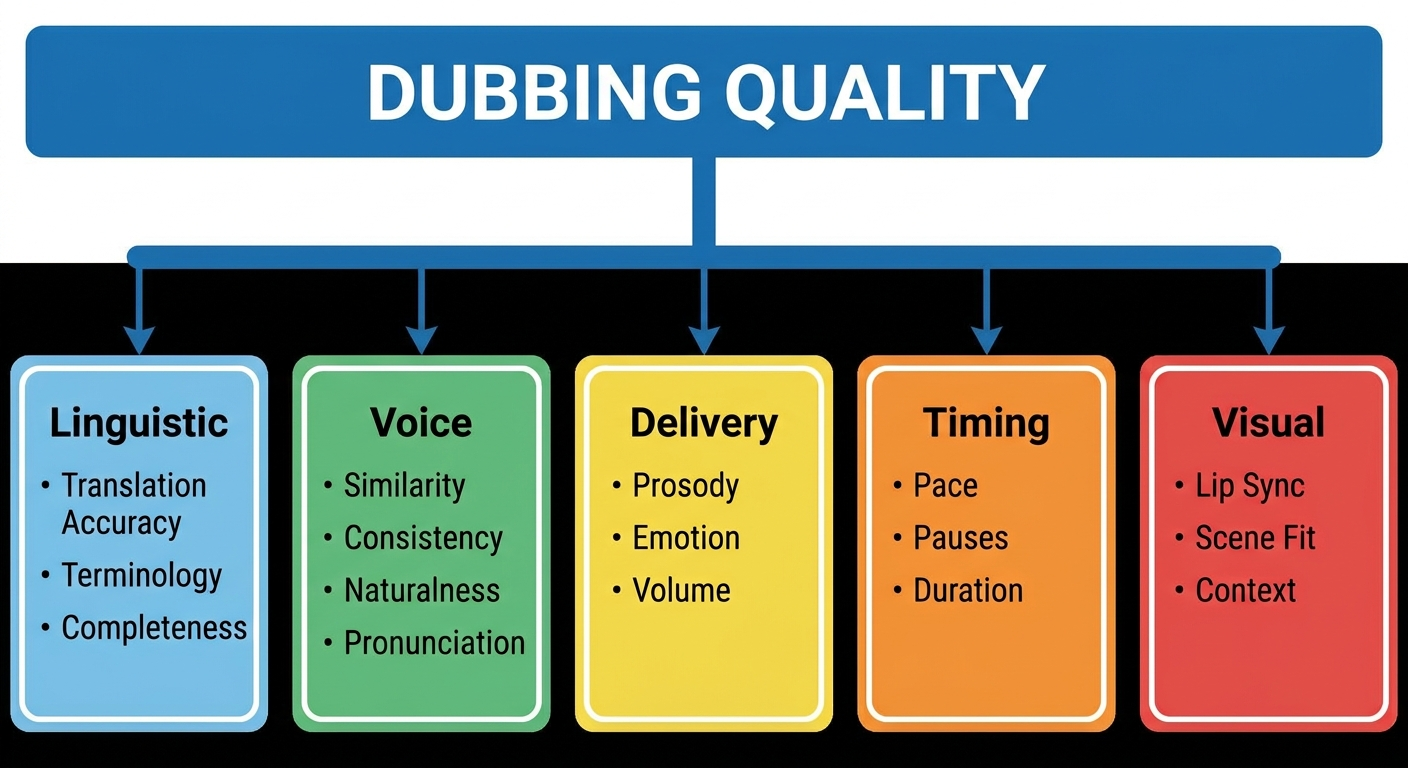
如何衡量 AI 配音视频的质量?
WER、BLEU、MOS 和唇形同步评分分别衡量 AI 配音的一个方面。实际制作质量是一个由翻译、说话人身份、韵律、情绪、语速和视觉同步等维度构成的向量,还要考虑观众真正能察觉的问题。
阅读全文 →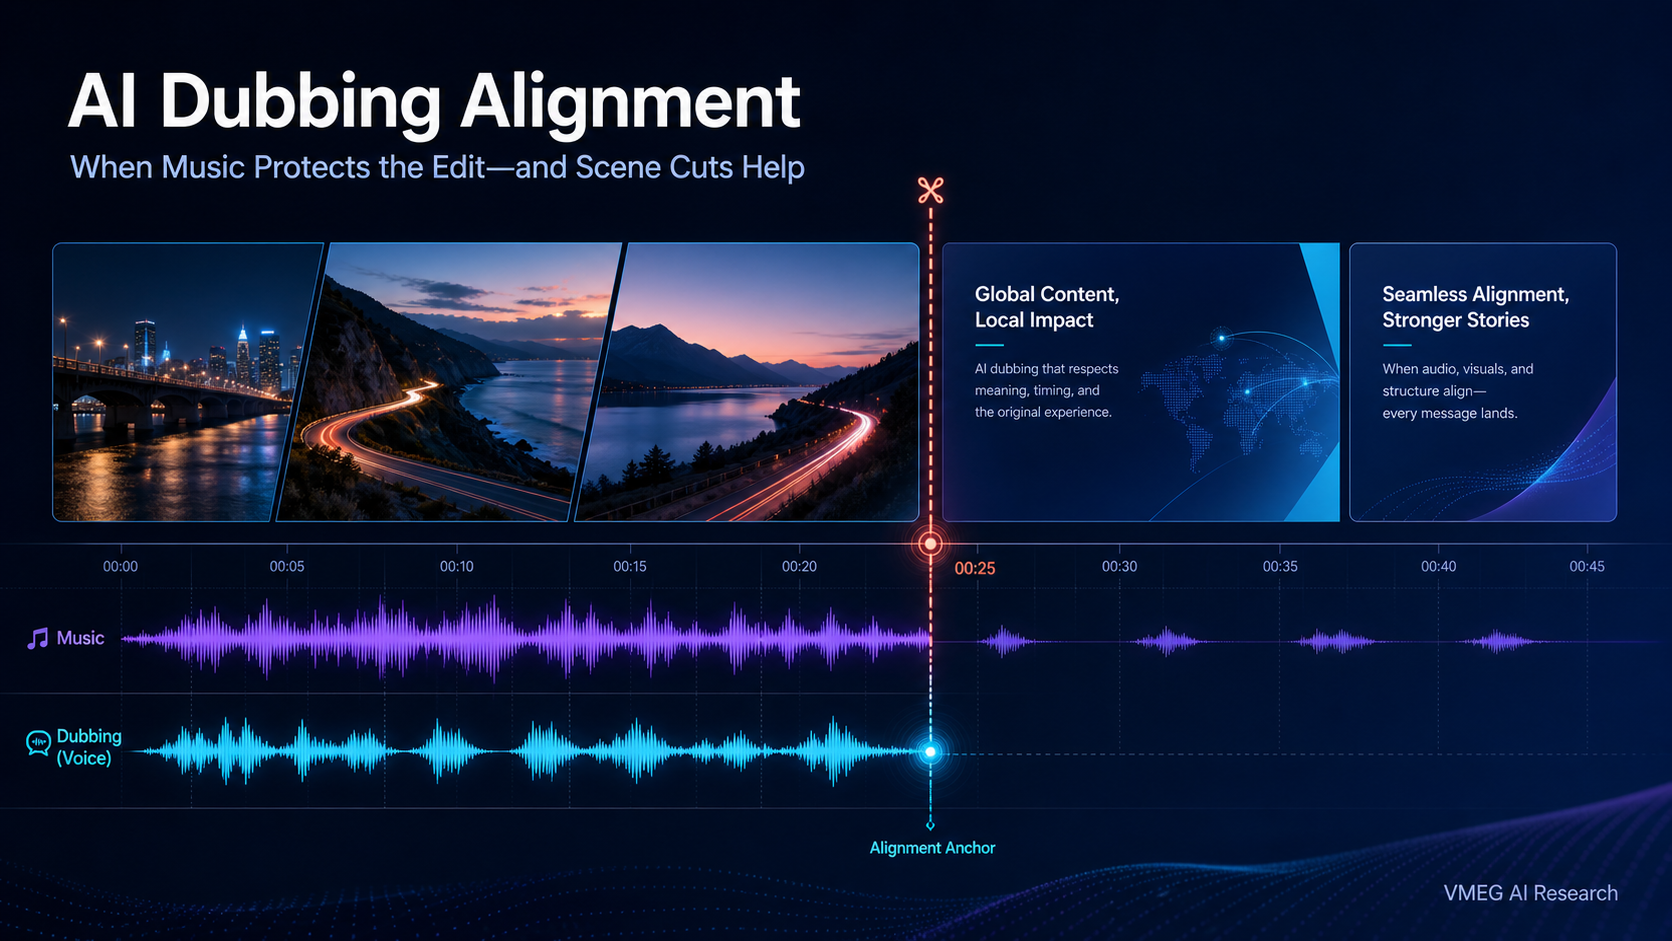
保留配乐与转场如何共同引导 AI 配音对齐
背景配乐的强度与持续度,以及可信的镜头转场,能帮助 AI 配音选择更自然的对齐落点,同时保留原片应有的节奏。
阅读全文 →
如何找到听起来像你的 AI 声音
声音匹配会从声音库中找出与参考音频最接近的声音。“像我”可拆分为身份、感觉和场景三个维度,VMEG 等产品会先筛选候选声音,再按相似度排序。
阅读全文 →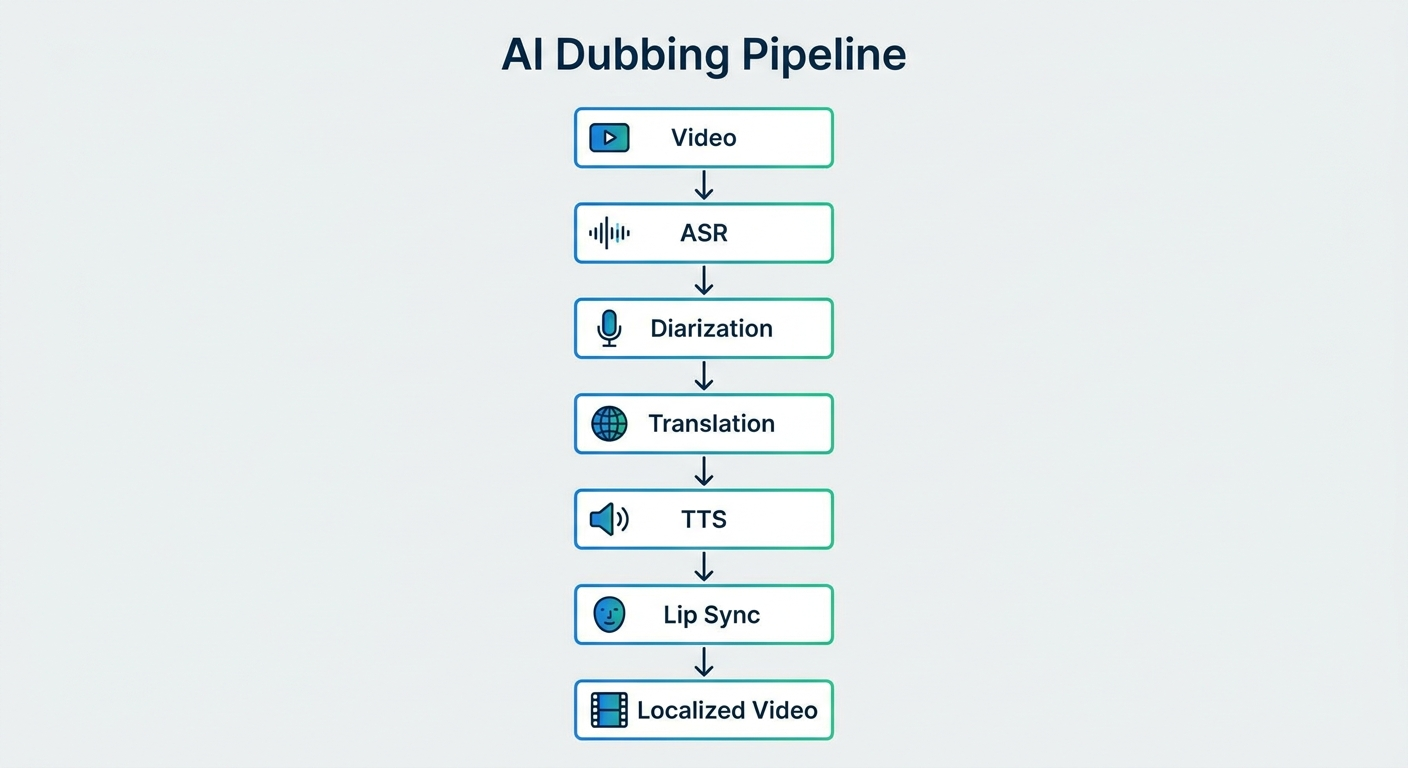
端到端智能与流水线级控制:重新思考 AI 配音架构
多模态模型和集成式配音 API 让“输入视频、直接输出视频”的一体化流程颇具吸引力。但生产环境仍需要可观测性、局部重新生成和人工审核。因此,未来的方向是将端到端智能与流水线级控制相结合。
阅读全文 →不只是训练模型:复杂算法如何从线上结果中持续学习
持续学习不只发生在模型训练中。本文通过 AI 配音对齐案例,说明生产系统如何依靠观测指标、安全检查、受控回放和线上证据持续改进。
如何衡量 AI 配音视频的质量?
WER、BLEU、MOS 和唇形同步评分分别衡量 AI 配音的一个方面。实际制作质量是一个由翻译、说话人身份、韵律、情绪、语速和视觉同步等维度构成的向量,还要考虑观众真正能察觉的问题。
保留配乐与转场如何共同引导 AI 配音对齐
背景配乐的强度与持续度,以及可信的镜头转场,能帮助 AI 配音选择更自然的对齐落点,同时保留原片应有的节奏。
如何找到听起来像你的 AI 声音
声音匹配会从声音库中找出与参考音频最接近的声音。“像我”可拆分为身份、感觉和场景三个维度,VMEG 等产品会先筛选候选声音,再按相似度排序。
端到端智能与流水线级控制:重新思考 AI 配音架构
多模态模型和集成式配音 API 让“输入视频、直接输出视频”的一体化流程颇具吸引力。但生产环境仍需要可观测性、局部重新生成和人工审核。因此,未来的方向是将端到端智能与流水线级控制相结合。
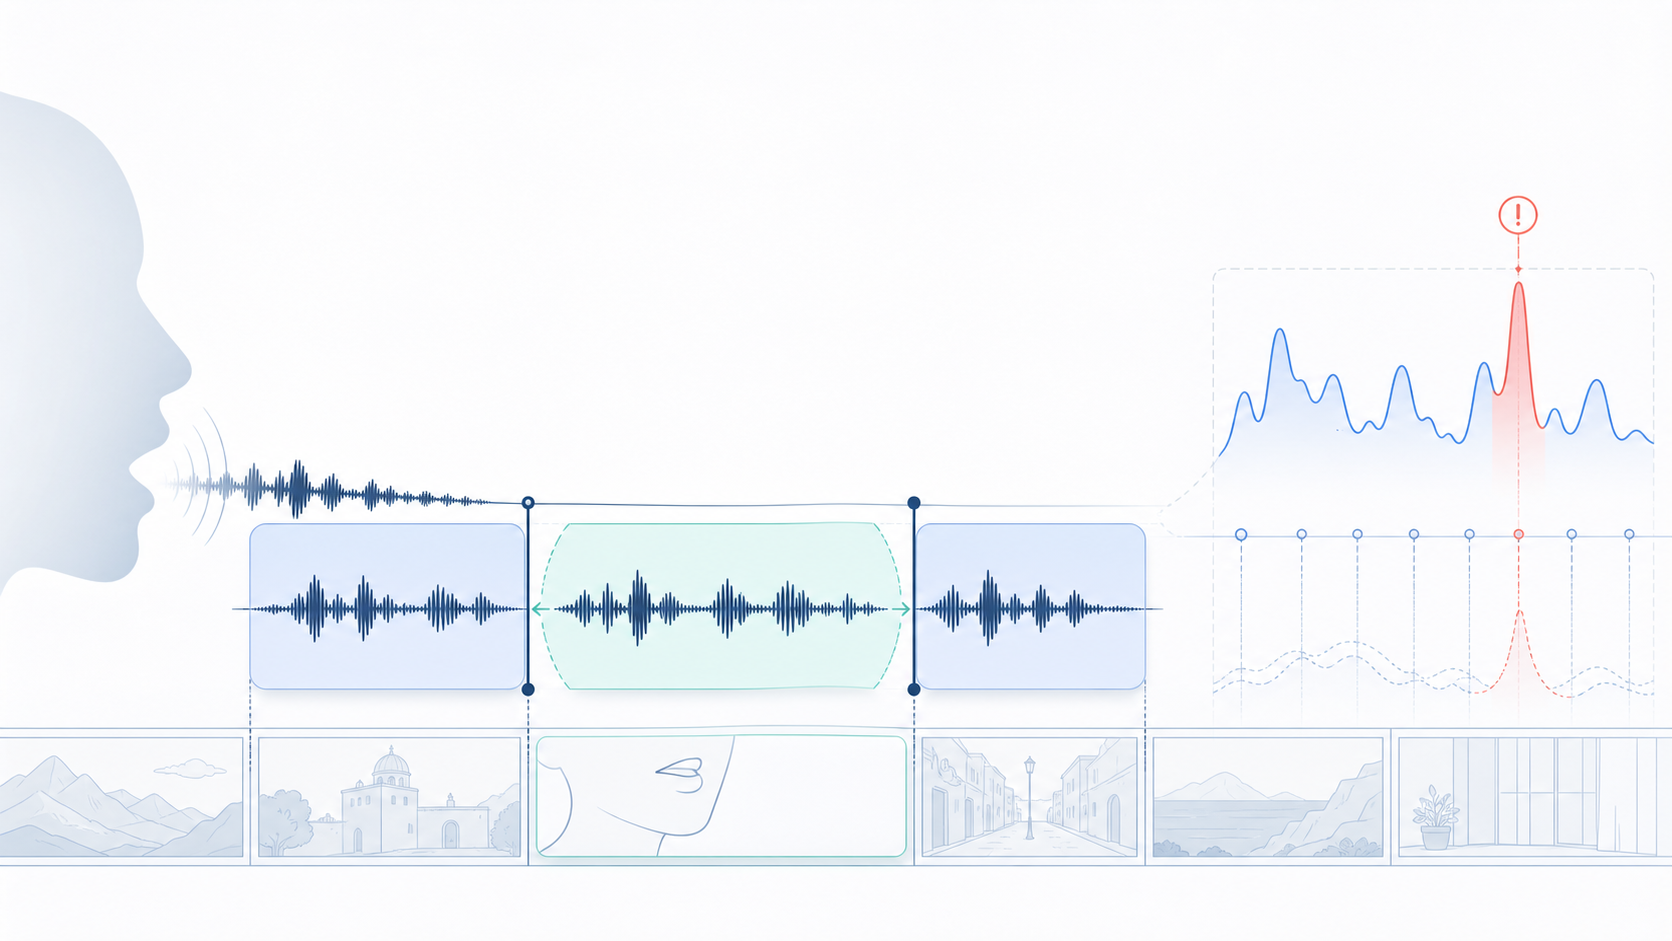
配音语速:哪些可以测量,怎样保持自然
嘈杂、剪辑频繁或很短的原始音频不适合只靠绝对音节率判断。相对的听感语速更接近人耳,因此应优先扩展相邻时间槽,必要时改写,最后才调整播放速度。
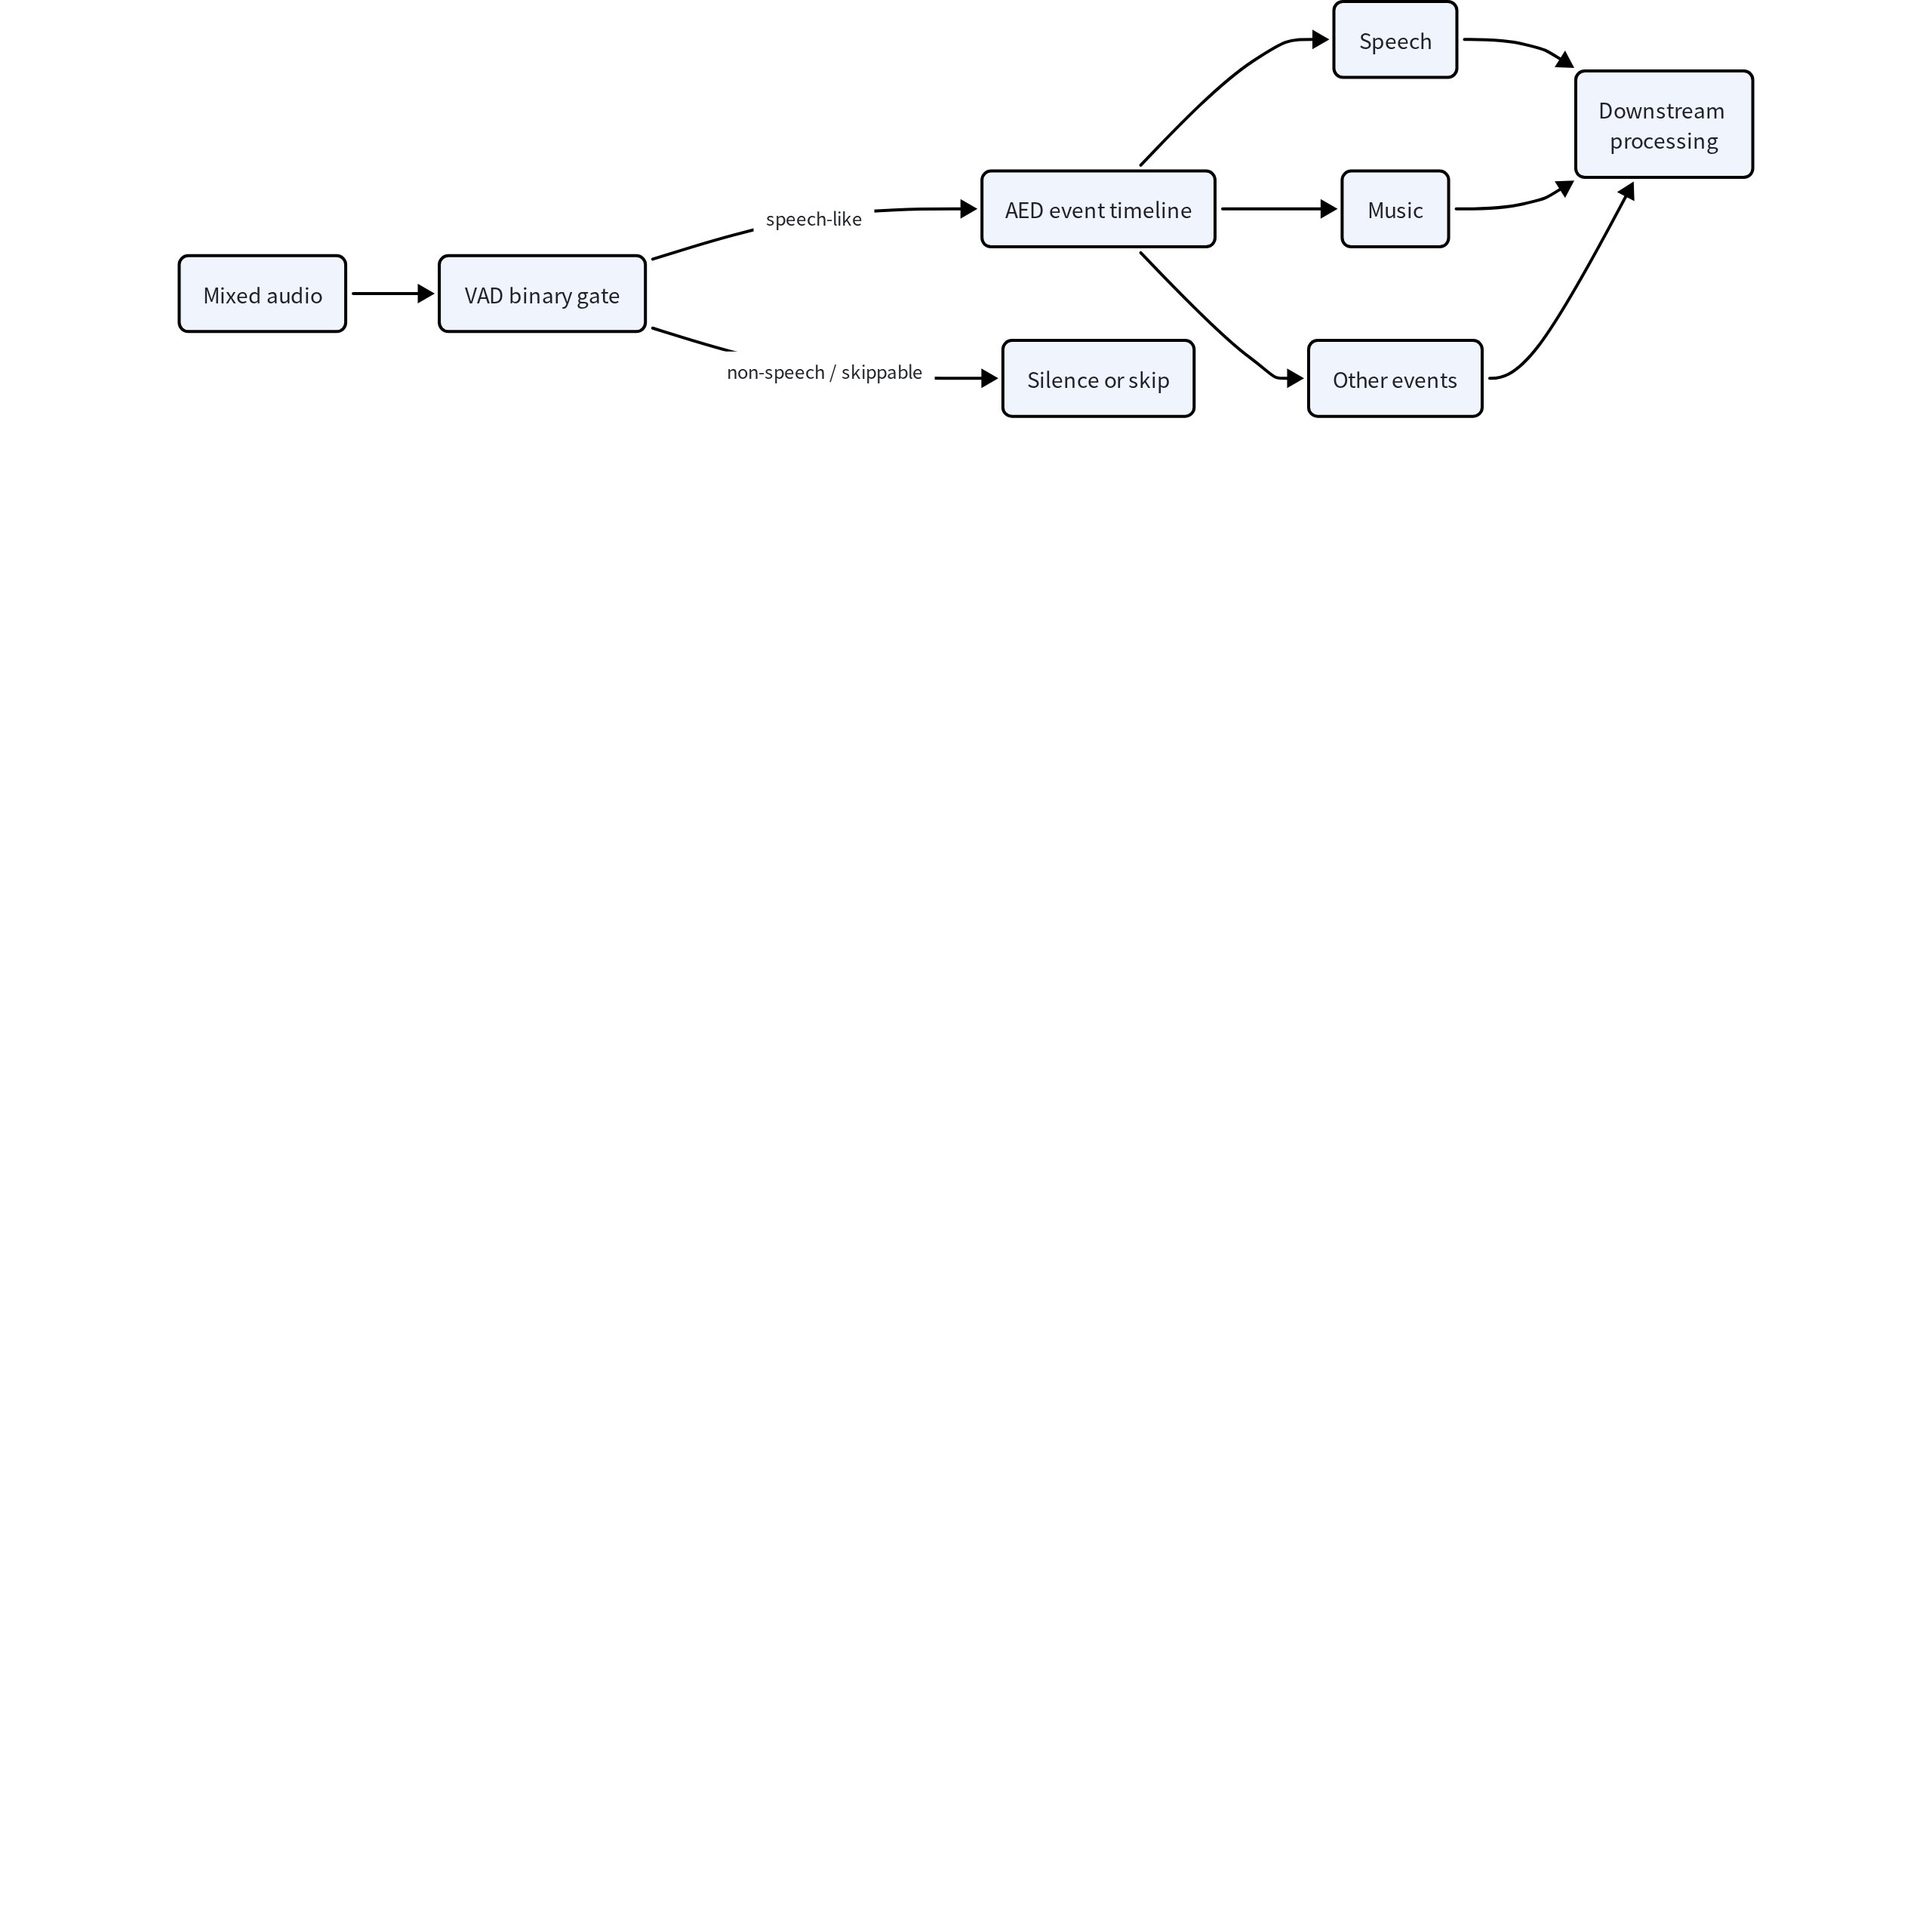
从 VAD 到 AED:为什么音频事件检测不能只听人声
语音活动检测只能判断是否有人正在说话。混合媒体中还包含音乐、笑声、掌声和相互重叠的音效。音频事件检测为后续环节提供带类型的时间线,避免配音和混音系统将所有声音都当作语音处理。
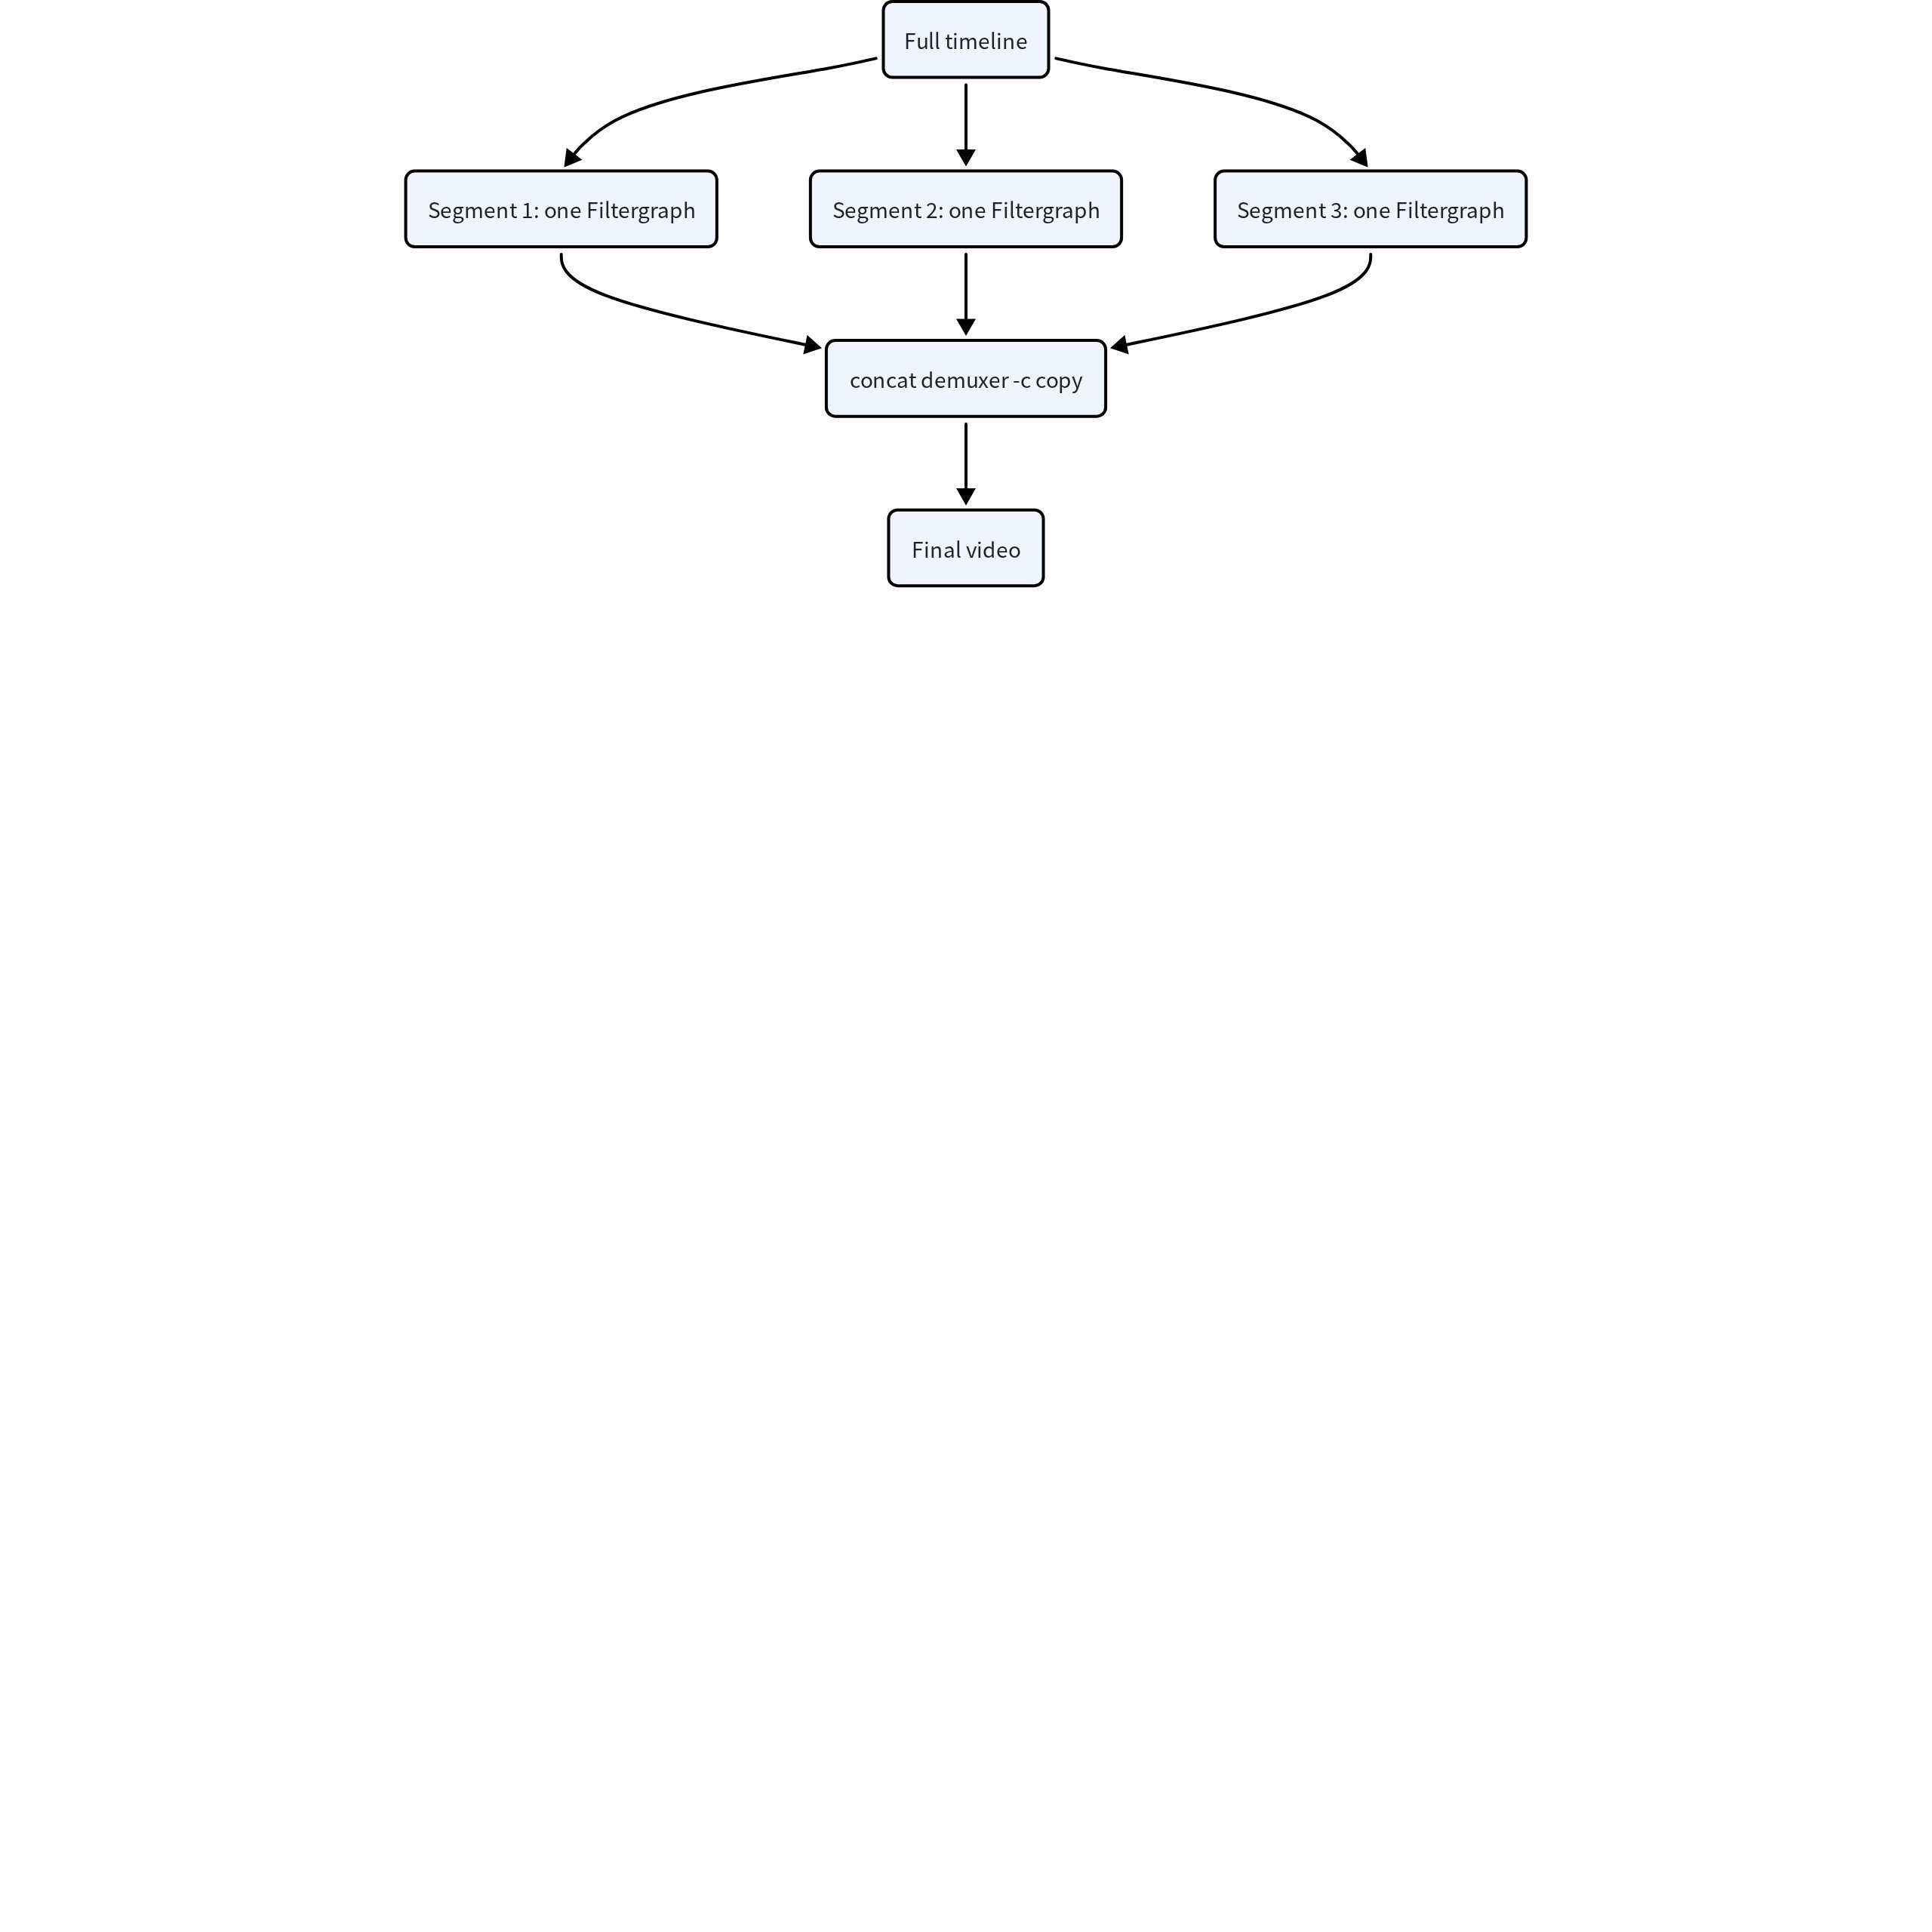
限制工作集:避免长视频 Filtergraph 导致 OOM
Filtergraph 之所以速度快,是因为它会将中间数据保留在内存中。处理包含数百个 TTS 片段的长视频时,工作集可能引发 OOM。可根据像素秒和 amix 流数量限制图的生命周期,再使用 concat 和 -c copy 拼接。
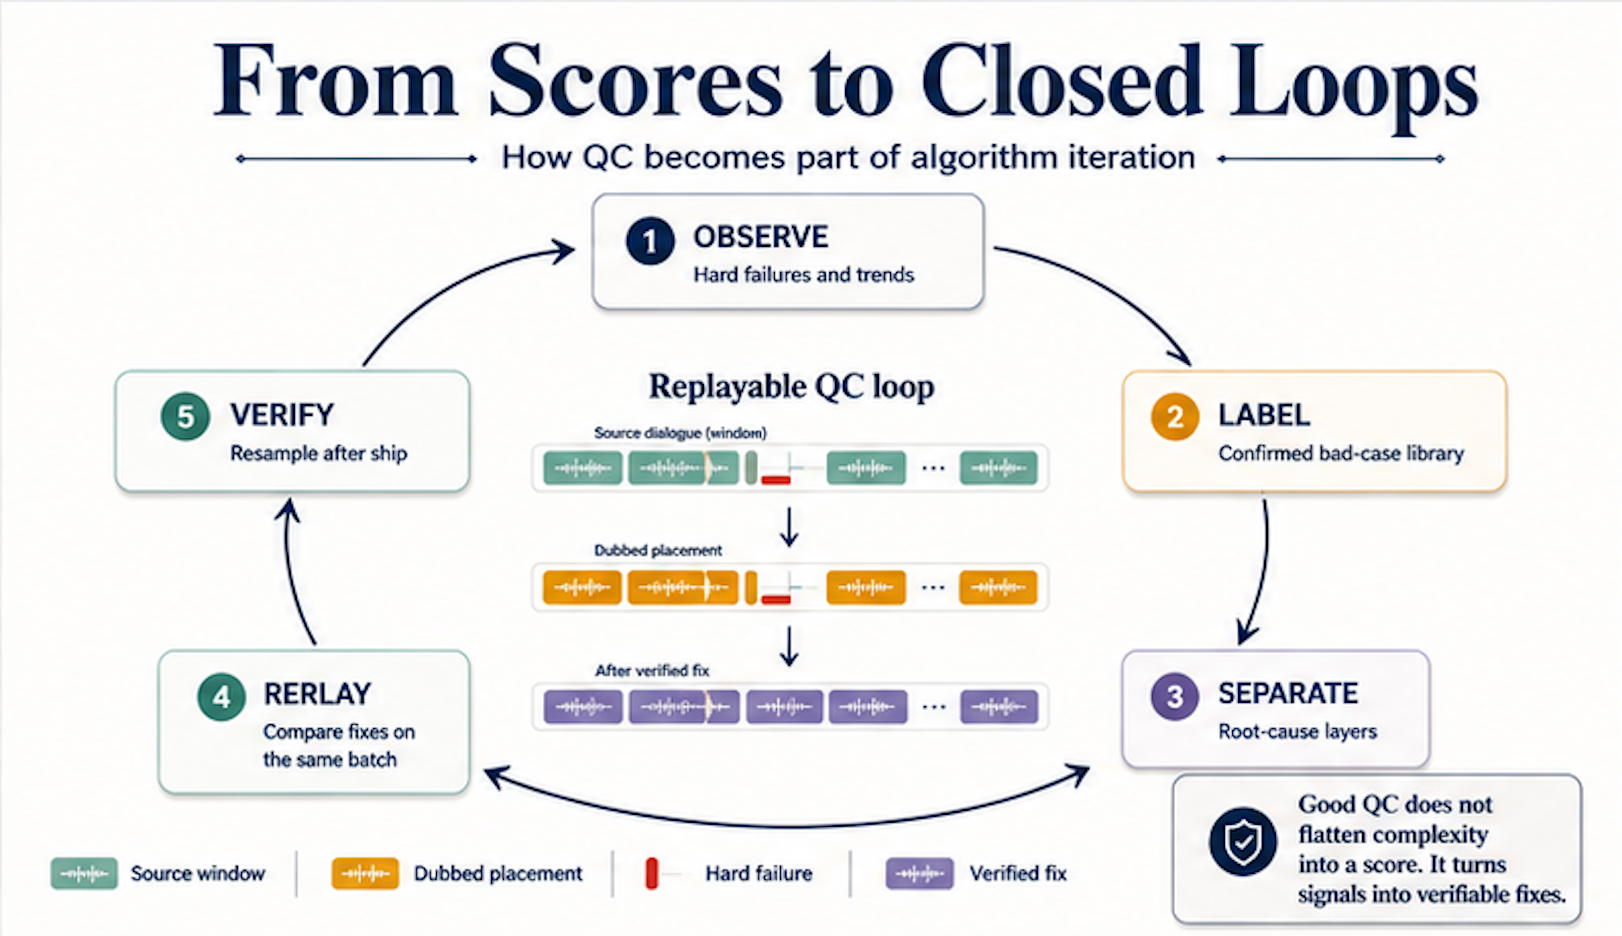
从评分到闭环:重新理解视频配音质量控制
质检评分可以发现配音任务存在问题,却无法告诉你该修复流水线的哪一层。本文介绍 VMEG 如何从各阶段的综合评分转向“观察、标注、分类、回放、验证”的闭环,让故障样本真正推动算法迭代。
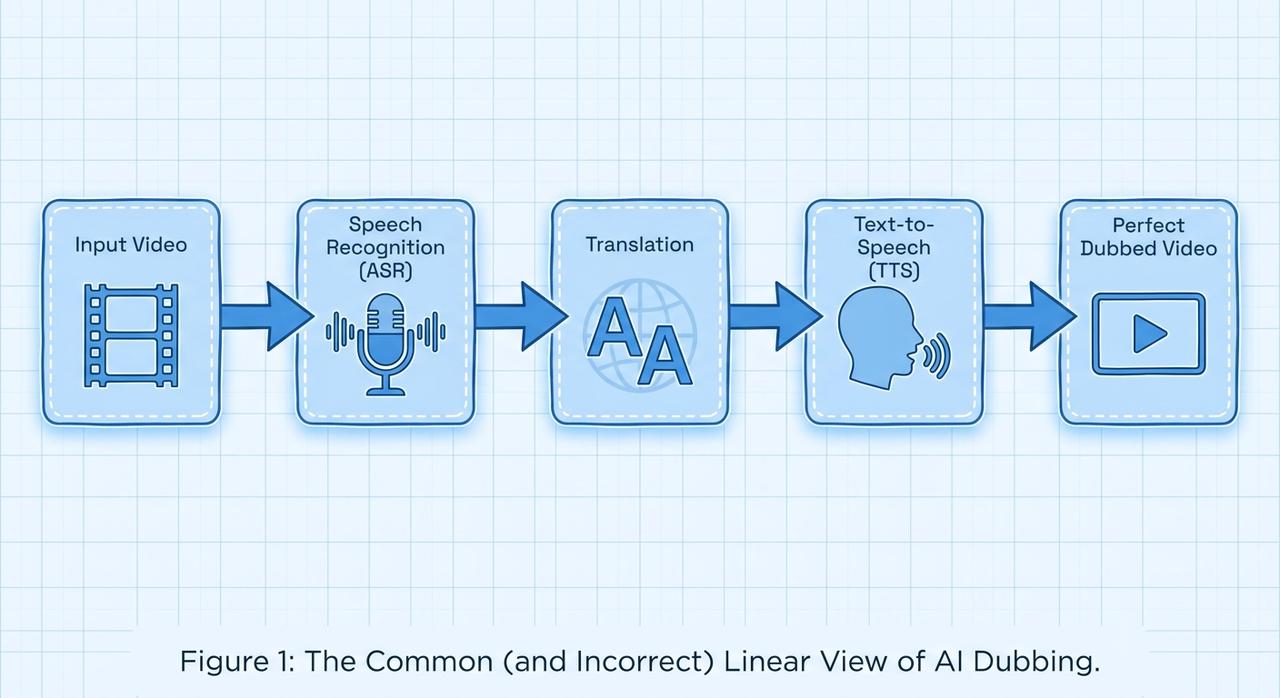
为什么 AI 配音不只是文本转语音
跨语言重现人类的表演,远比生成自然的人声困难。现代 TTS 已经表现出色,但 AI 配音不仅要将文本转换为语音,还必须保留时序、情绪、节奏和说话人身份。
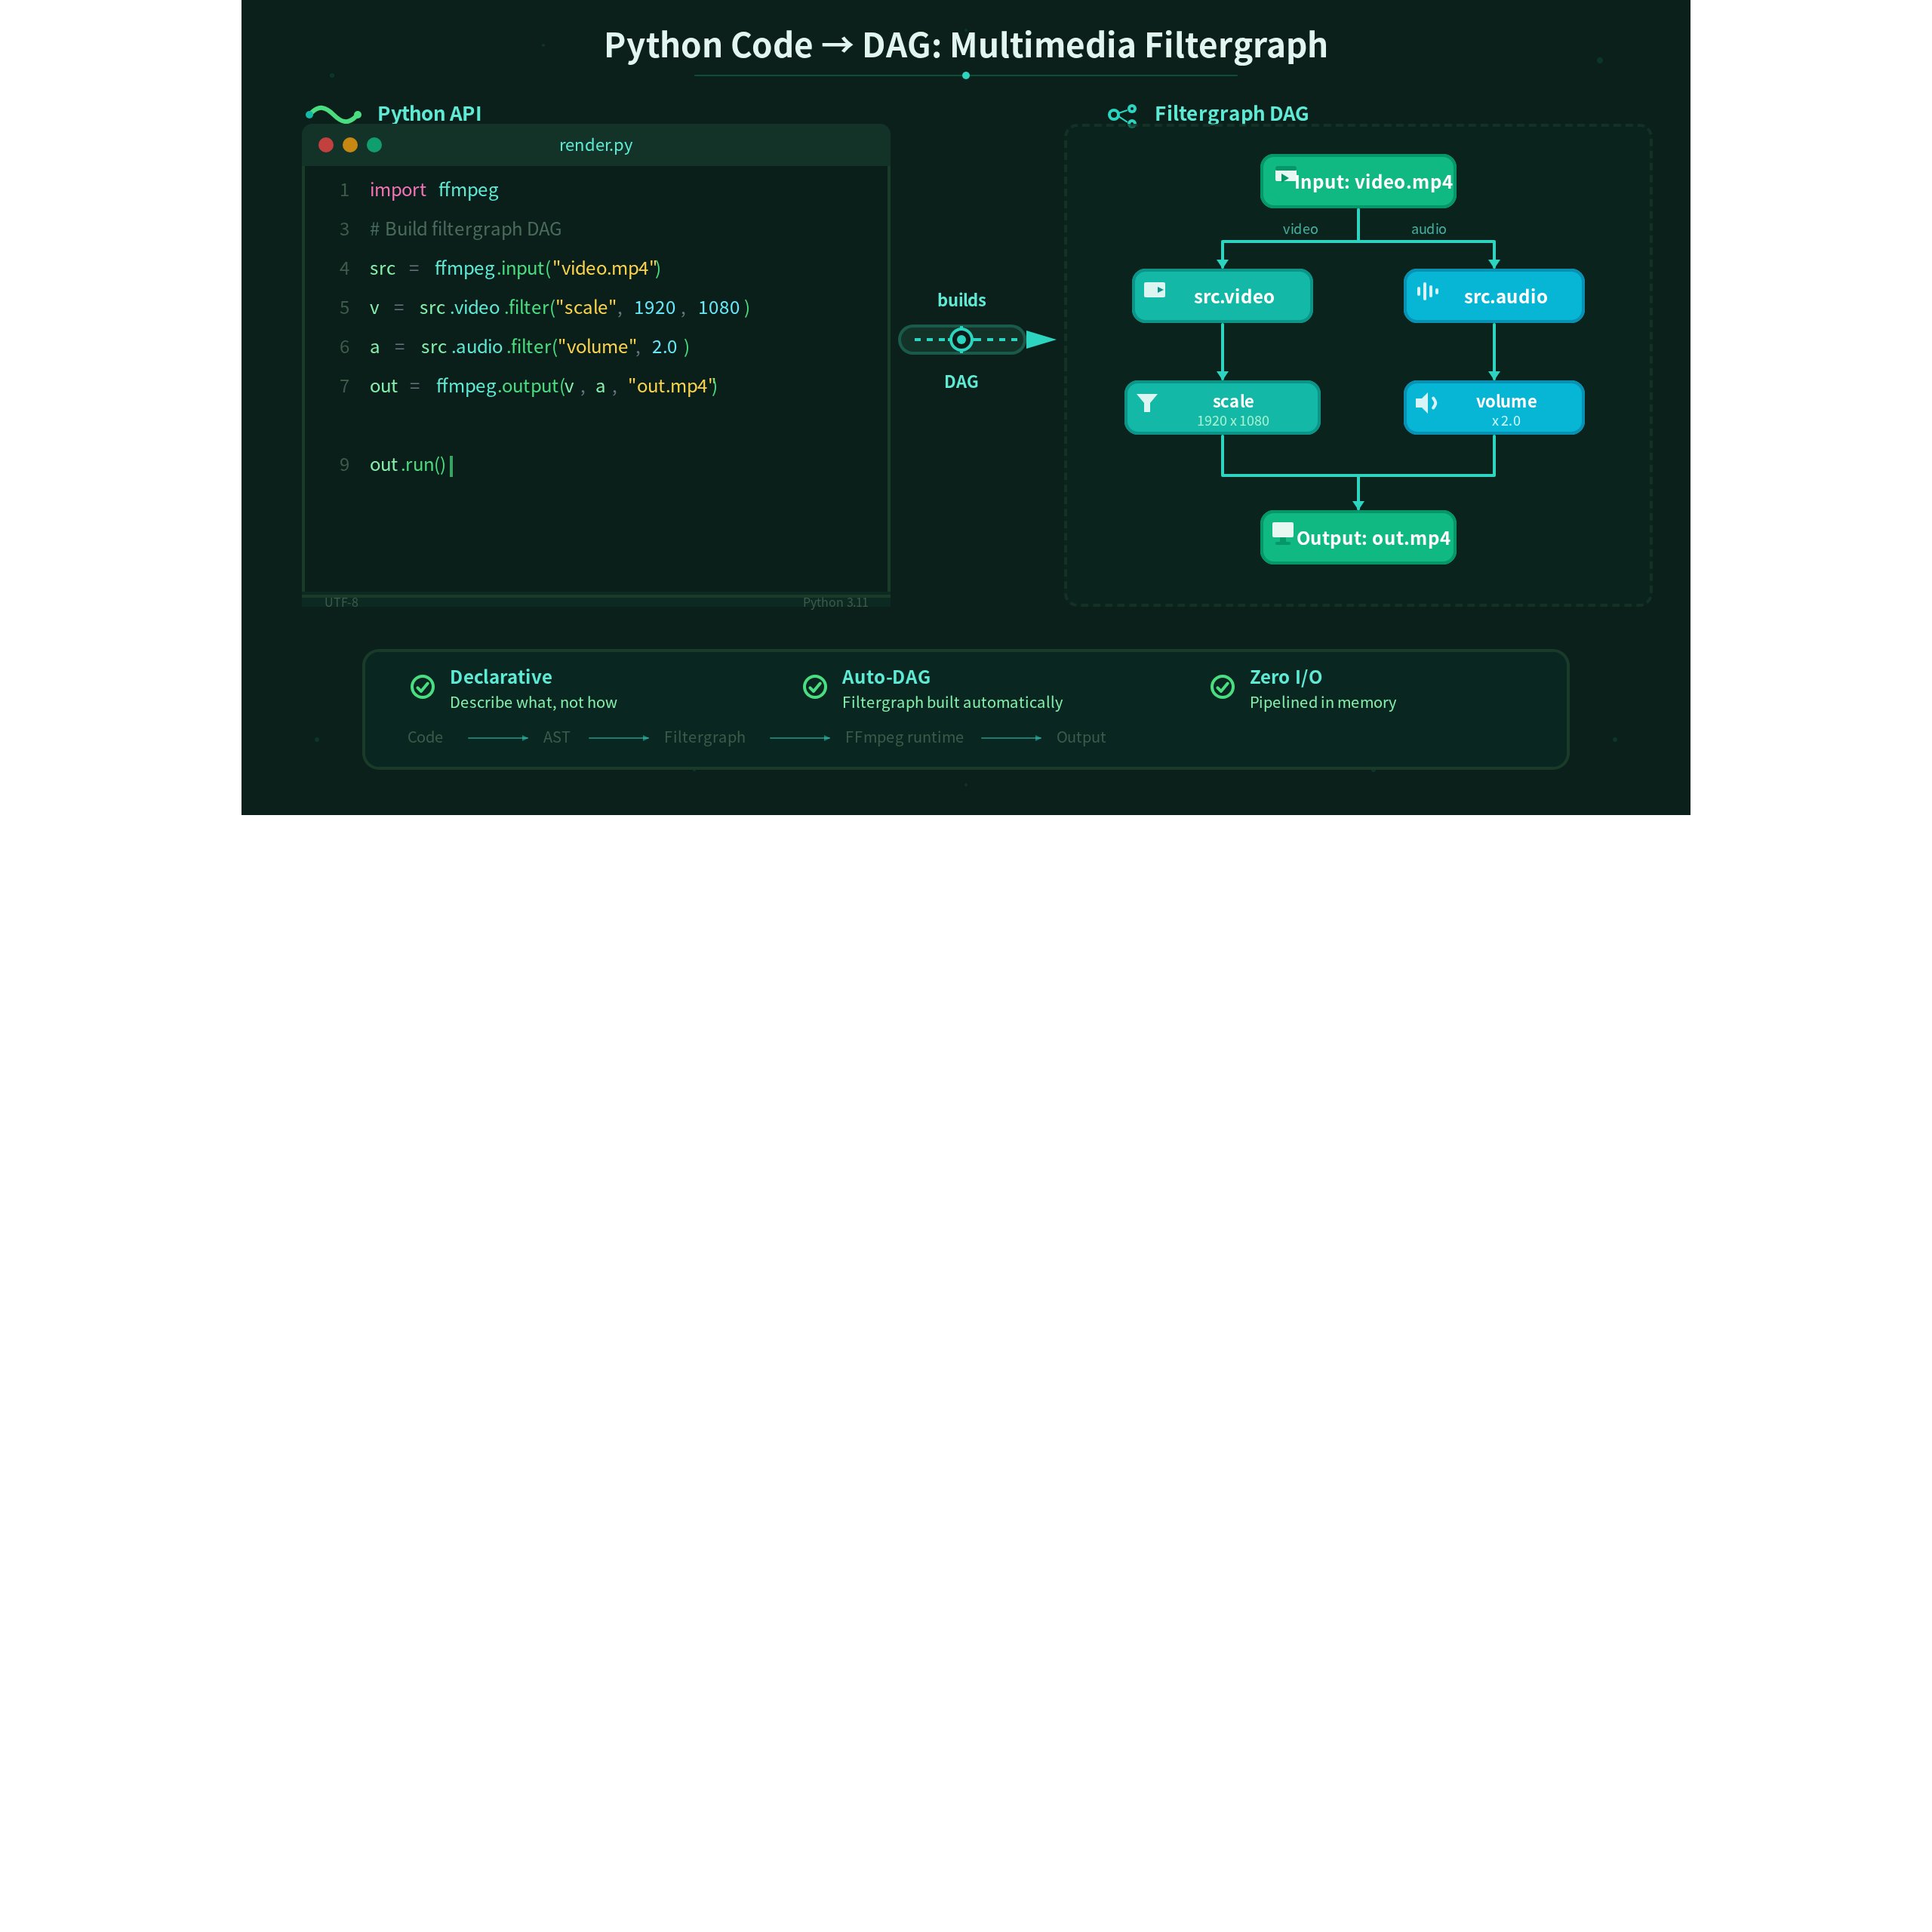
用 FFmpeg Complex Filtergraph 加快视频渲染
通过减少中间文件、在内存中组合 Filtergraph,并用声明式工具管理复杂命令,可以降低磁盘 I/O 并提高多核利用率。
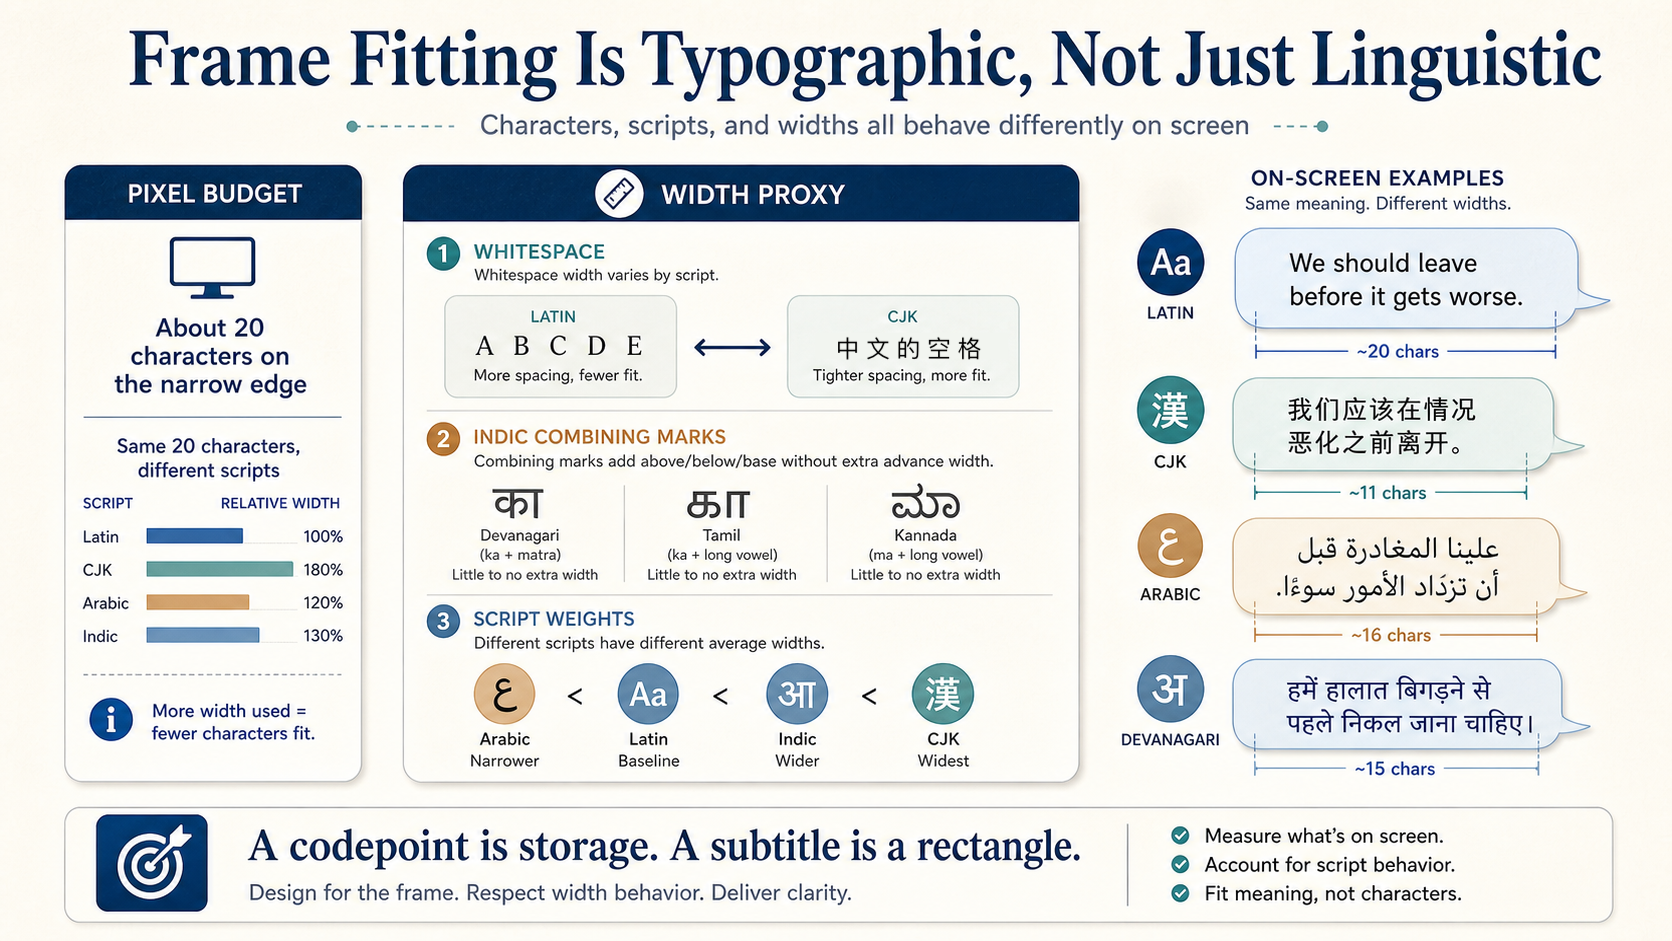
字幕在哪里换行:关键是几何,不是语言
字幕换行看似是语言问题,但在生产环境中主要是几何问题:需要让拉丁文字、中日韩文字、阿拉伯文字、印度文字和无空格文字的字形都能适配画面。
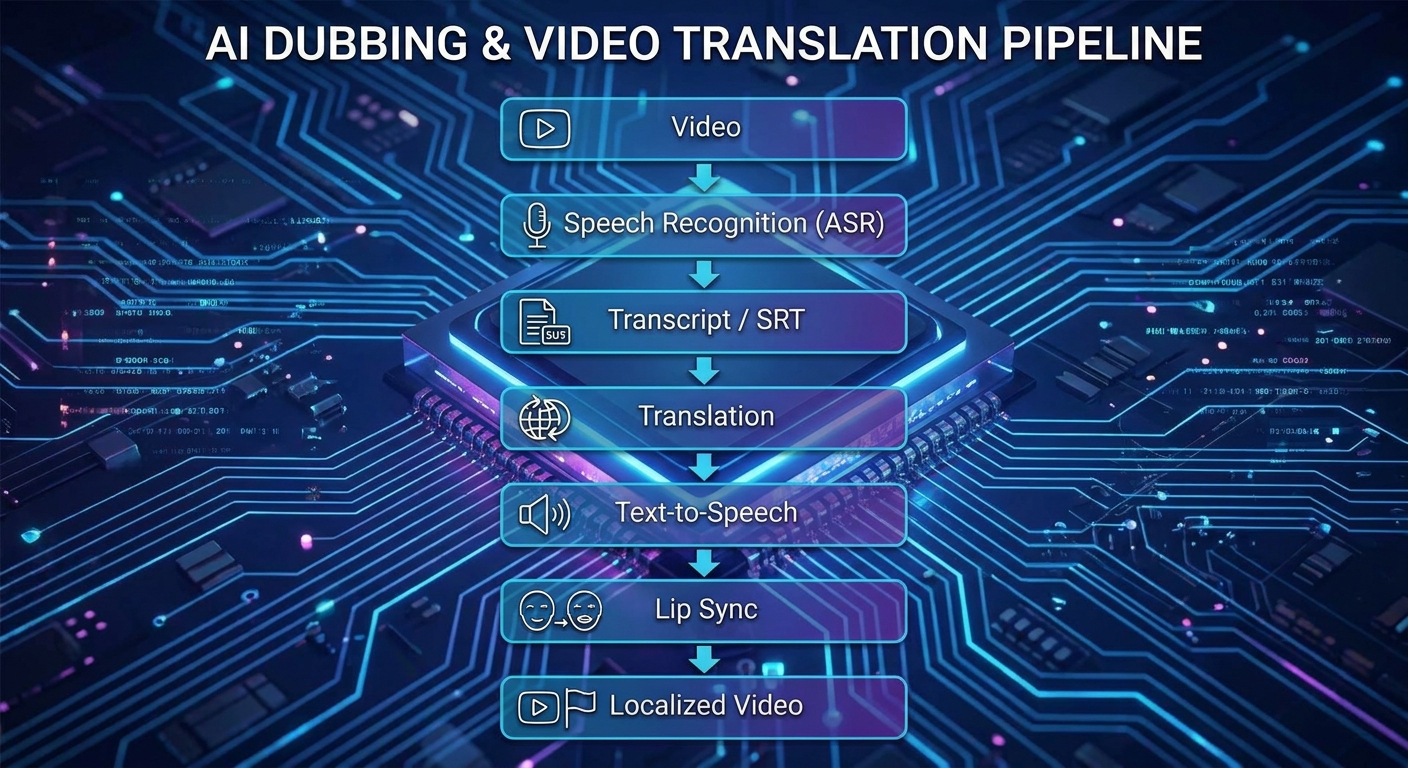
为什么 AI 视频本地化不能只靠转写稿
语音识别只回答说了什么。生产级视频本地化还需要说话人、性别、年龄、情绪、说话风格、时间边界与多模态上下文。

翻译模型懂这种语言,只是选错了版本
我们处理的内容涵盖企业解说视频、日常 vlog、短剧和广告。真正困难的通常不是让模型输出泰米尔语、阿拉伯语或粤语,而是让它采用配音场景中人们实际会使用的语言版本。
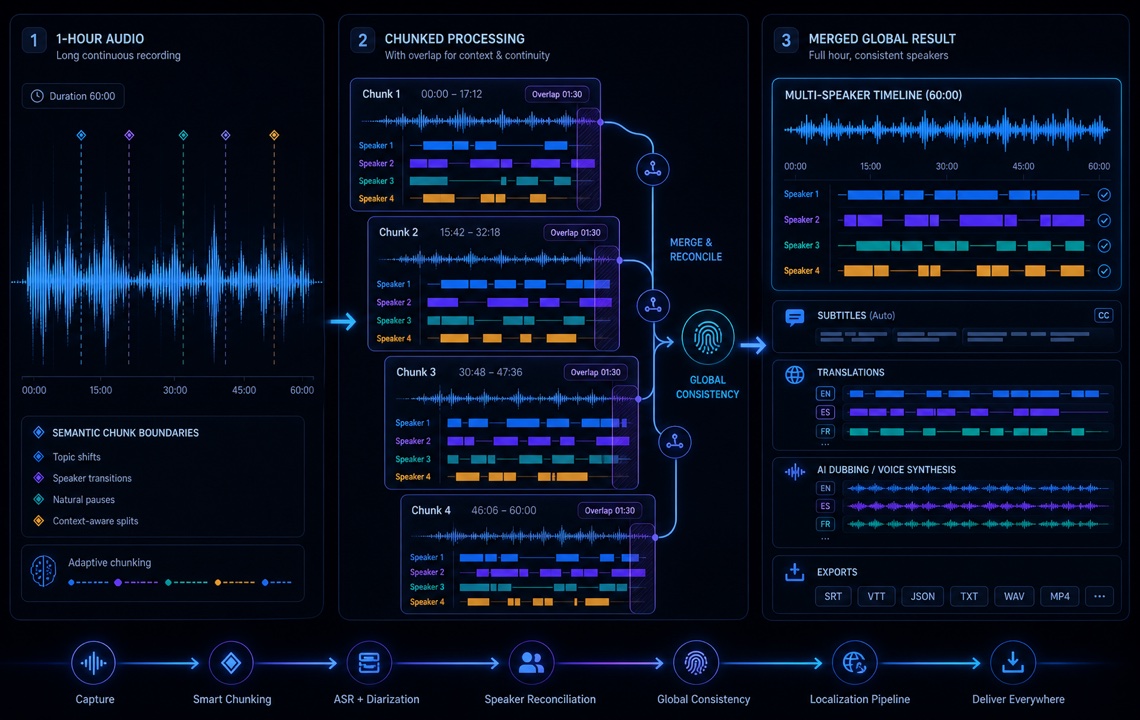
一小时不等于一个音频文件:大规模长音频语音处理的工程实践
长音频语音处理的瓶颈不在 AI 模型,而在工程系统。本文介绍生产系统如何在数小时音频、数十位说话人和复杂本地化流程中保持一致性。
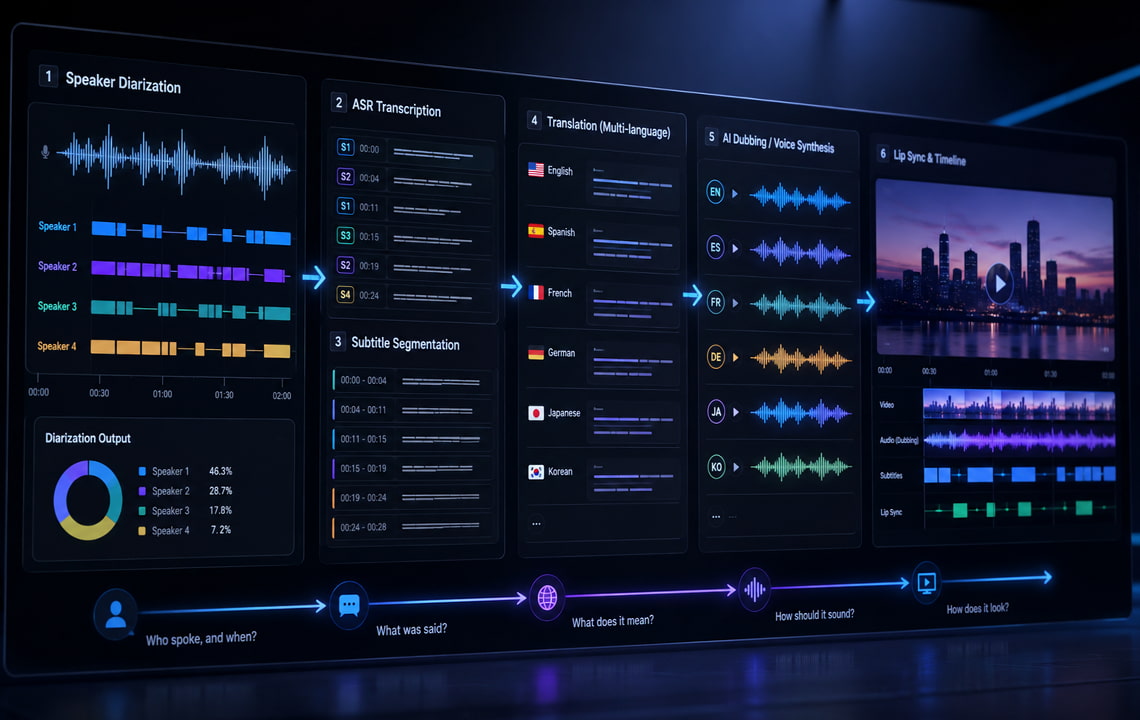
生产环境中的说话人分离:为什么仅优化 DER 还不足以支撑 AI 视频本地化
说话人分离经常被视为一项独立的 AI 任务。实际上,它是端到端视频本地化流程中影响最深远、也最容易被误解的环节之一。
避免音频冲突:AI 视频翻译中的时间对齐
跨语言配音会改变句子时长,也可能让新语音撞上音乐高潮或关键音效。本文介绍如何通过时间线分析、受控变速和精确对齐保留原片节奏。
如何为跨语言字幕匹配恰到好处的“呼吸感”
在全球视频分发中,一项核心挑战是确保字幕和配音不仅语义准确,也能让当地受众感受到自然的节奏。
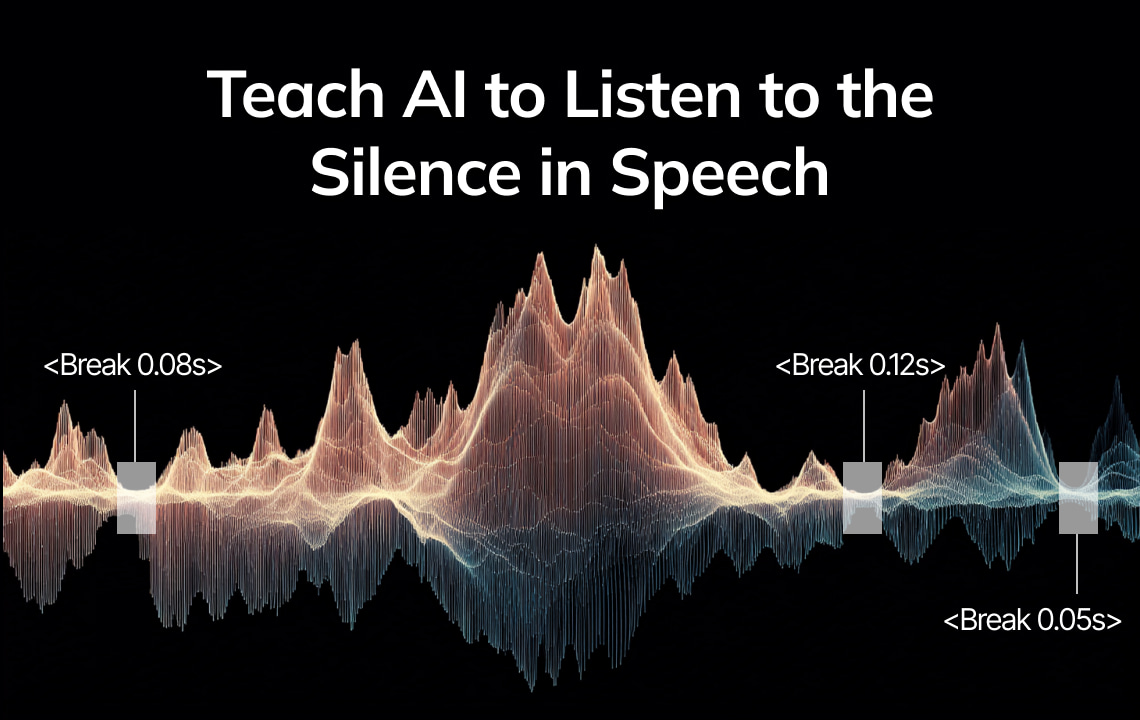
如何教会 AI 聆听言语中的沉默
了解 AI 如何通过静默语音识别与节奏建模感知言语中的沉默,让机器捕捉人类说话时的停顿、情绪与呼吸。