质量控制的核心是统计学。早在大语言模型和多模态 AI 让自动化评估成为实际工程问题之前,统计学家就已经在思考一个相似的问题:当关注的对象无法被直接观测时,该如何衡量它的质量?
VMEG 在为多语言视频翻译与配音流水线构建质量控制体系时,遇到的正是这个问题。
第一版:看得见表象,看不见过程
第一版质检系统自然反映了我们当时对流水线的理解。最初,我对算法链路还不够熟悉,手里主要是任务完成后留下的产物,包括脚本、识别结果、TTS 结果、对齐结果等。最直接的做法是:
把每个任务拆分为多个阶段,包括语言选择、识别、翻译、TTS 和对齐。在每个阶段标记“看起来异常”的表层信号,根据异常片段占比评分,再把表现最差阶段的分数作为总分。对齐环节尤其依赖时长比,例如原始音频时长与其在时间线中所占时长的差异、语速比是否超出合理范围,以及相对变化是否过于剧烈。
这种方法确实有明显优势:能够快速上线并稳定运行,每个任务也都有一个明确的分数。但它的能力上限同样明显:
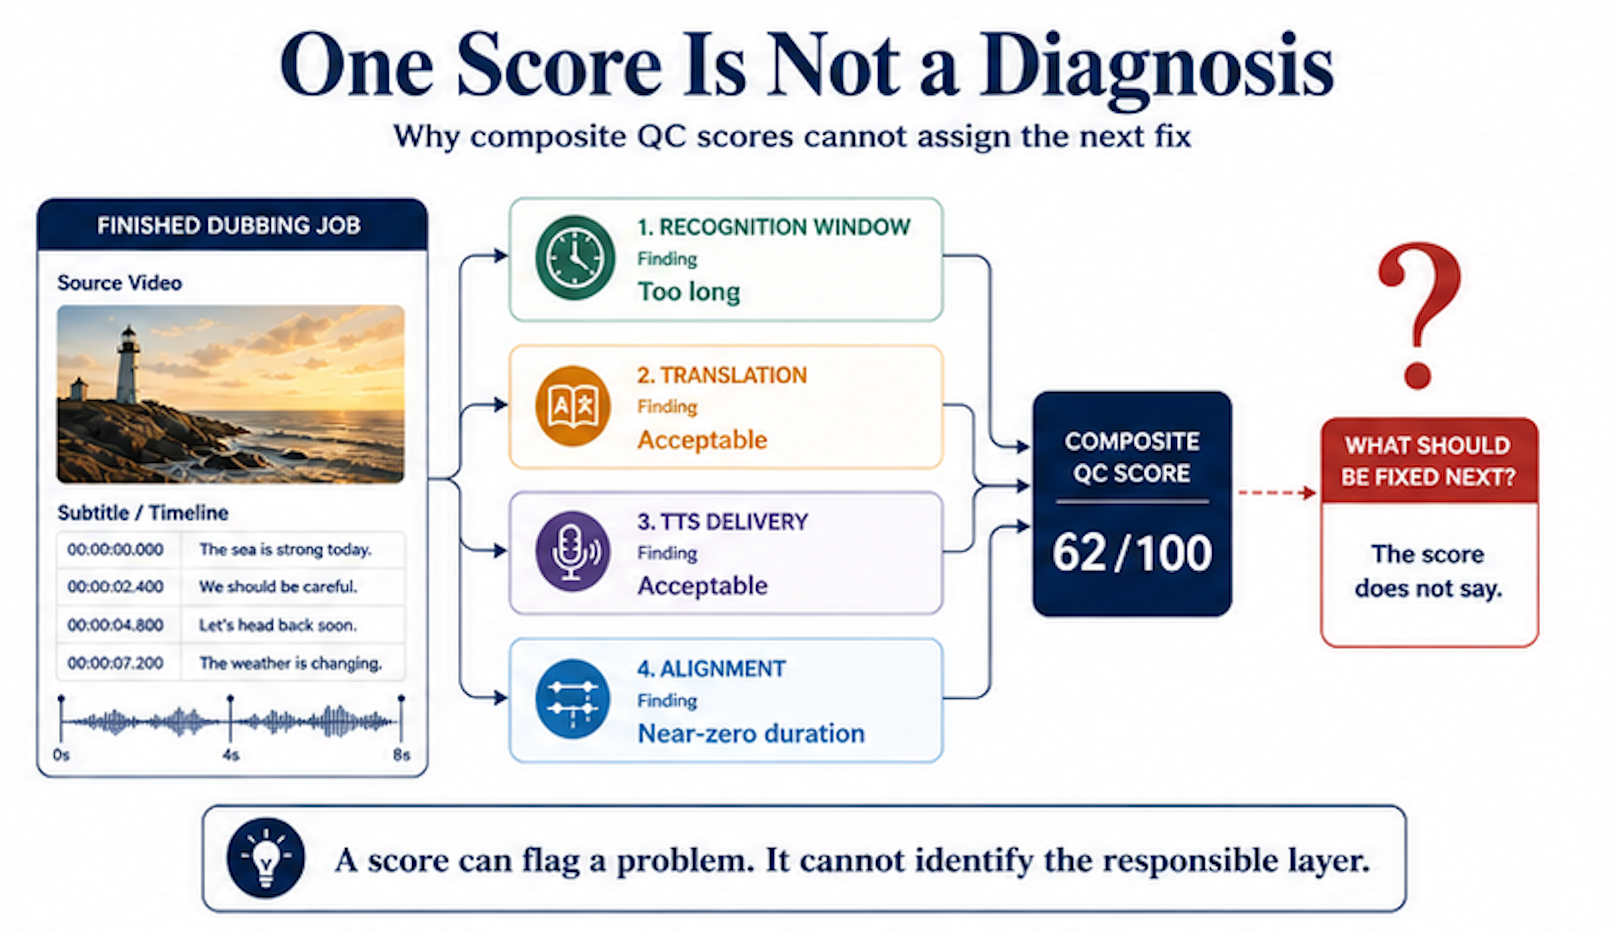
- 评分能说明存在问题,却很少能指出问题出在哪一层。是上游窗口有误?是流水线中间的某项策略吞掉了一行?还是实际听感仍可接受?一个总分会抹平这些差异。
- 表层参数存在相关性,也会造成误导。时长比和语速比确实重要,但相关性不等于因果关系。如果不沿着完整链路排查,就无法确定应该修复哪个步骤。
- 当时没有经过确认的故障样本池。缺少一组稳定、已标注的故障样本,算法迭代就只能依赖对个别案例的直觉判断。
回头来看,第一版更像是一份统计学作业答案:“计算一个综合评分。”它帮我们迈出了第一步,但还不足以支撑算法工程所需的质量控制。
为什么阶段评分还不够:有用的指标应当指向可执行的修复方案
真正的转折出现在我深入了解整个系统之后。对于同一个成片,一旦能够对比源对话窗口和配音放置窗口,抽象的分数就会变成可以采取行动的具体问题:
- 匹配情况:两个窗口如何重叠?是整行发生偏移,还是只有起止位置混乱?
- 严重故障:某行配音在时间线上几乎没有有效时长,也就是说,这一行根本没有播放。
- 行内偏移:整行发生了错位,声音与画面无法对应。
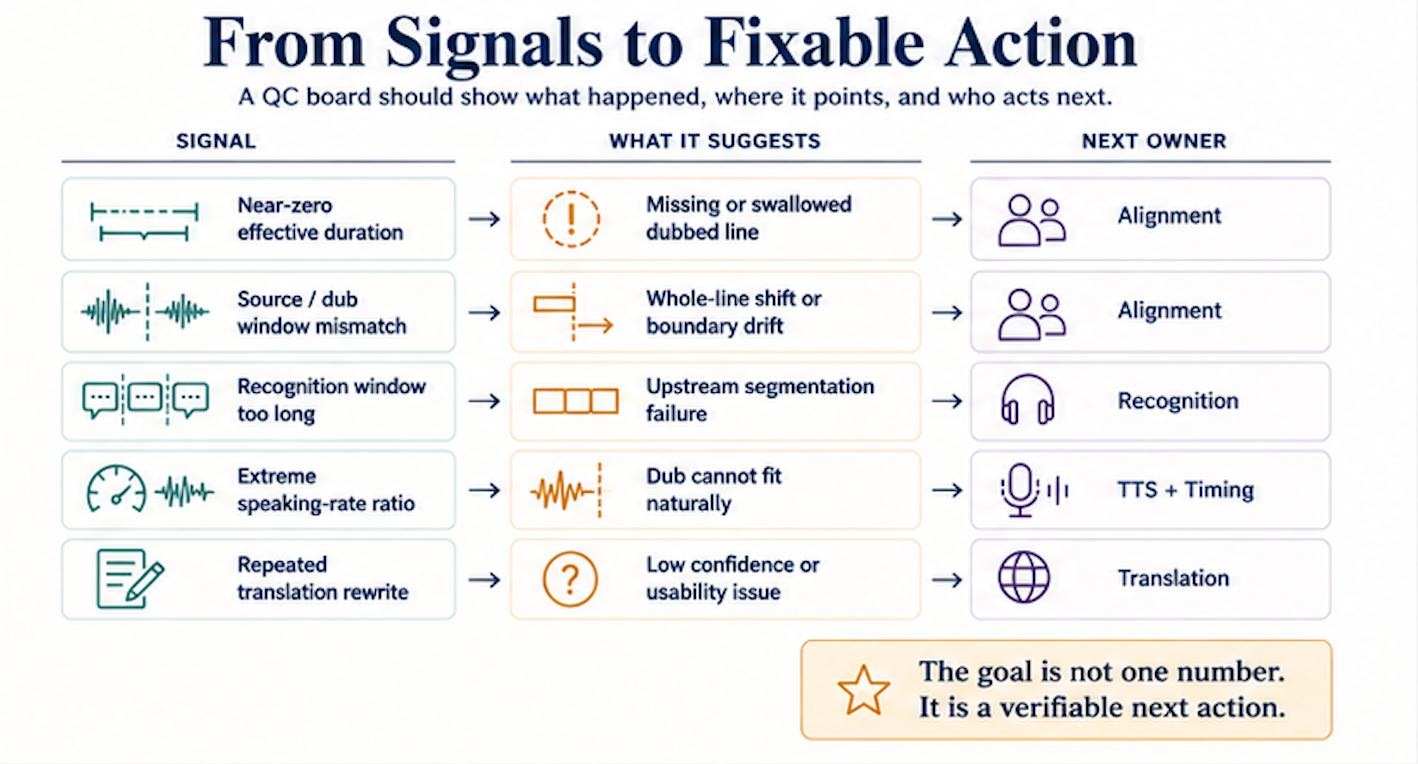
- 辅助信号:识别窗口过长或过短、语速被过度调整、翻译因低分而被改写、音色不稳定、分离结果需要安全修正等。每个信号回答的问题都不同,不应全部揉进一个所谓的“质量评分”中。
目前的算法质检看板正是按照这一思路构建的。顶部展示趋势,包括缺陷率、体验转化、任务量,以及用户在编辑器中重新执行各步骤的频率。下方展示模块详情,包括对齐、识别、翻译、分离、语速、声音一致性、后处理覆盖情况等。我们的目标不再是用一个分数概括所有问题,而是更清楚地回答:我们观察到了什么,它指向哪里,接下来应该由谁修复?
直到这时,课堂上学过的因子分析、异常值等概念才真正落到实处,成为划分决策边界的工具:
这个信号能否把故障归入不同的根因类别?它能否推动一项可验证的修复?
同一种告警,两类根因,两种对齐修复方案
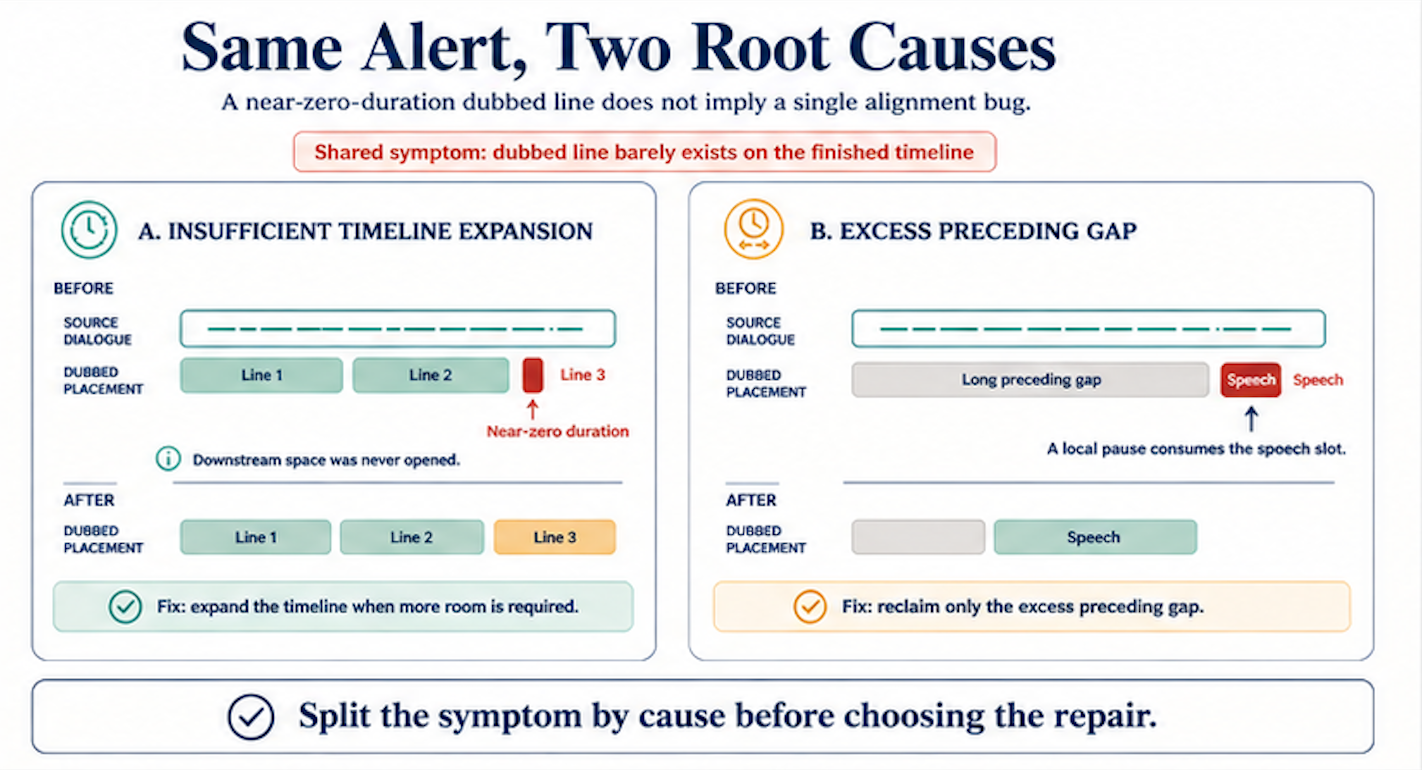
在对齐链路中,我们会监控一种严重告警:某行配音在成片时间线上的有效时长接近于零。它在看板上十分醒目,因为用户几乎总能听出问题,表现为台词缺失或多行台词挤在一起。
这里要注意:两项相互独立的修复在表面上几乎完全相同,都是零时长的严重故障,但根因截然不同。
修复一:视频拉伸幅度不足
第一类缺陷中,配音需要更多时间空间,但成片时间线没有腾出足够的位置。后续台词受到挤压或被吞掉,最终只剩下空壳。指标中表现为零时长,实际听感则是语音缺失或与相邻台词重叠。
质检在这里的作用不只是亮起红灯。我们选取了一组严重程度较高且已经确认的故障样本,对相同输入回放候选改动,再检查问题是否真正减少。最初凭直觉编写的补丁几乎没有改善指标。后来,我们确保需要扩展时,时间线确实得到扩展,这组故障样本中的零时长案例和相邻台词碰撞才在大多数情况下明显减少。代码合并后,我们又测试了一批规模更大、具有相同症状但尚未标注的案例,以确认修复并非只适配少数熟悉的个案。
这一轮让我们认识到:如果没有可回放的故障样本库,同一个表层告警很容易让人调整错误的参数。
修复二:前置间隔过长
第二类缺陷仍然表现为零时长。仔细检查后发现,这一行原则上拥有足够时长,但前面的静音占用了太多时间槽,导致实际语音无处安放。在成片中,用户只能听到呼吸声,却听不到台词。
修复方法也完全不同。这里不能“进一步拉伸视频”,而是要调整策略:默认保留合理停顿;只有当某行台词明显被压缩成空壳时,才从它前面的间隔中回收少量时间,把语音放回去。回收的时间只需让这一行能够正常播放,不应再多,以免裁掉正常停顿。
这一轮让我们认识到:当同一个指标再次出现异常时,往往意味着主要原因已经消除,次要原因随之浮现。如果不持续测量,人们很容易把它归结为“同一个缺陷又出现了”。实际上,这通常是相同症状产生了新的分层。
质检究竟如何改变算法迭代
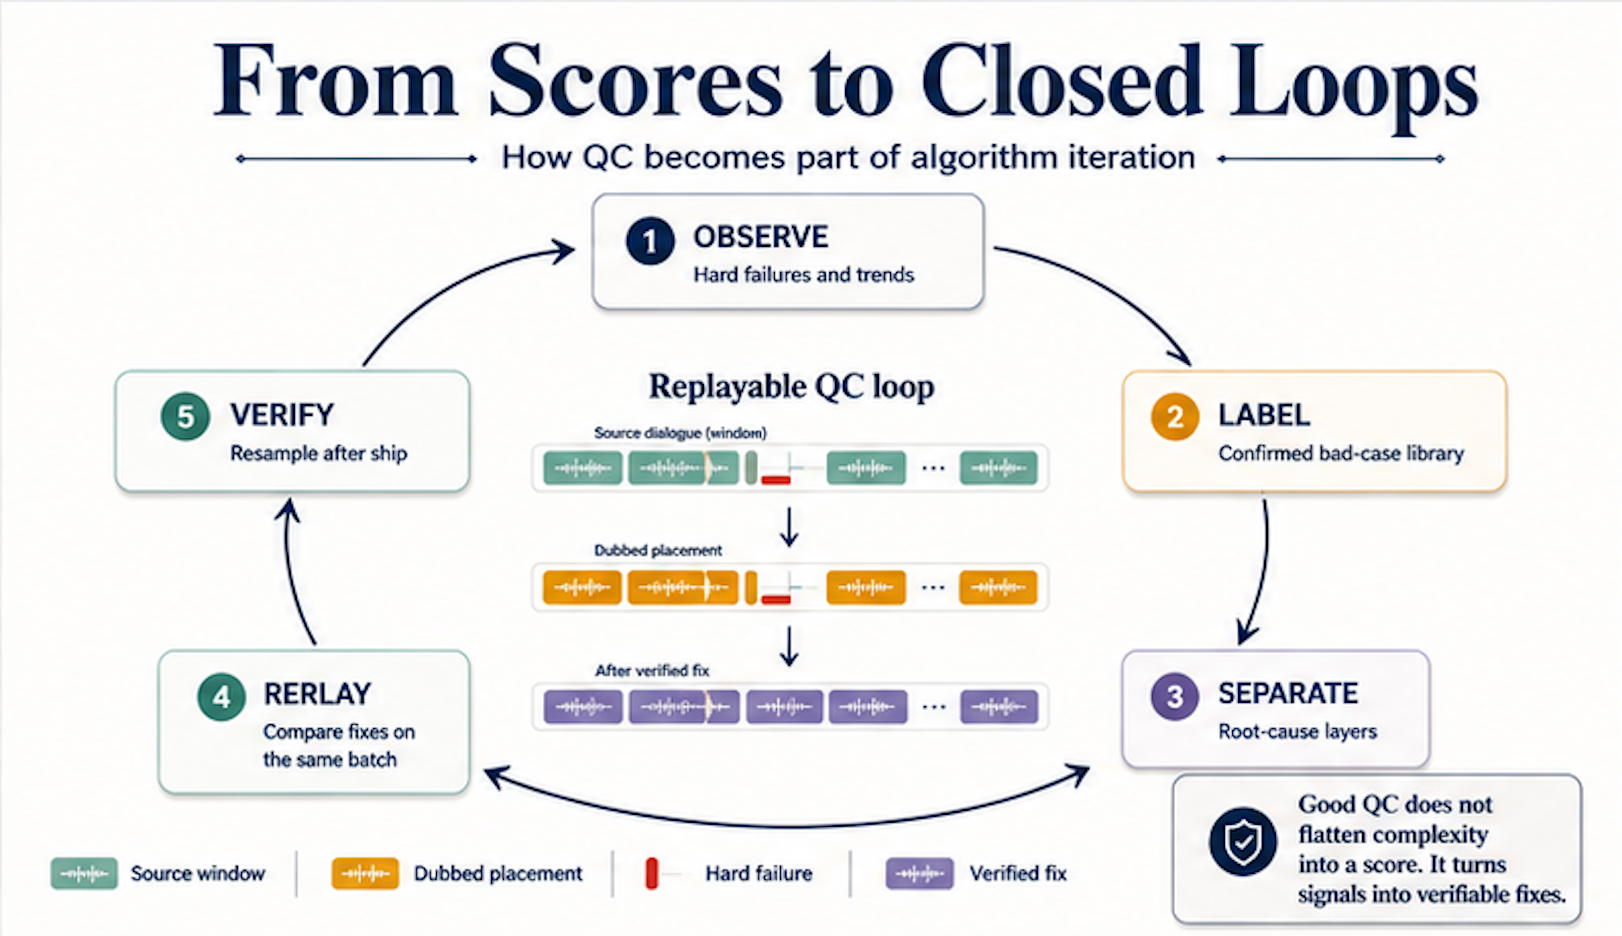
把这两次修复串联起来就会发现,质检并不存在于某一次代码变更中,而是贯穿一个闭环:
- 日常观察:在支持工单大量出现前,严重故障和趋势就已经显现。
- 人工标注并入库:故障样本成为可回放的数据集,不再只是聊天中的截图。
- 根因分层:面对同一种零时长告警,先判断是时间线总时长不足,还是局部间隔占用了时间槽。
- 候选方案回放:在同一批故障样本上比较修改前后的结果,不再只凭一句“我觉得已经修好了”。
- 上线后再次扫描:如果相同症状再次出现,应优先考虑是否出现了新的问题分层,而不是改写此前的根因结论。
对算法团队来说,迭代节奏从“修改一个地方,试听几个片段”转变为“修改一个地方,回放一批样本,解释剩余问题”。对产品和体验团队来说,缺陷率下降也可以关联到具体修复,不会再淹没在综合评分中。
一个朴素的结论
好的质检不会为了得到更方便的分数而压缩复杂系统。它会把系统拆解为一组信号,这些信号既足够明确,能够在日常工作中得到信任,也足够具有可操作性,可以在修复后进行验证。
信号要明确,避免噪声干扰看板;也要可操作,让修复效果得到证明。
早期,我们急于得到一个分数,因此走了弯路。后来,我们为每个信号明确记录它不会衡量什么,才逐渐取得进展。两项对齐修复的价值,不在于补丁本身有多亮眼,而在于它们展示了质检真正进入算法闭环后会发生什么:相同症状可以被拆分,修复结果可以重新检查,剩余问题也会如实显现。
评分用于衡量质量,闭环才能改善质量。
参考文献
[1] Fabrigar, L. R., & Wegener, D. T. (2012). Exploratory Factor Analysis. Oxford University Press.
[2] Chandola, V., Banerjee, A., & Kumar, V. (2009). Anomaly Detection: A Survey. ACM Computing Surveys.
[3] Pearl, J. (2009). Causality: Models, Reasoning, and Inference. Cambridge University Press.
[4] Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media.
[5] Huyen, C. (2022). Designing Machine Learning Systems. O’Reilly Media.