在全球视频分发中,一项核心挑战是确保字幕和配音不仅语义准确,也能让当地受众感受到自然的节奏。如果把语速很快的英语旁白直接翻译成中文,观众可能会觉得喘不过气。
下面具体看解决这一问题的核心技术:跨语言语速与停顿惩罚算法。它不会简单地拉伸音频,而是像一位精通双语的节奏指挥,智能调节语言的“呼吸”。
核心问题:语速之间的天然差异
每种语言都有其固有的信息密度和发音节奏。这里有一个关键观测指标:跨语言语速比(base):
base = S_theo / T_theo其中:
S_theo:源语言(例如英语)的理论语速,单位为每分钟词数。T_theo:目标语言(例如中文)的理论语速,单位为每分钟词数。
通过统计得出的
base 值(例如 1.3)表示英语的常规语速是中文的 1.3 倍。这就是我们的基线预期。核心挑战:处理偏离常态的“节奏个性”
真实语音往往带有鲜明的个人特点。情绪激动的说话人,其实际语速(
S_act)可能远快于该语言的常规语速(S_theo)。如果直接按照 S_act / S_theo 的比值(称为 speed_sl_ratio)调整目标语速,就会导致目标语速失控。解决方案:建立语速“安全区间”
第一项创新是引入非对称压缩函数,将原始
speed_sl_ratio 压缩到合理区间 [sl_min, sl_max](例如 [0.9, 1.2])内,得到 speed_sl_penalized_ratio。其数学表达式如下:
令
r = speed_sl_ratio,delta = r - 1- 语速较快时(delta > 0):
r_pen = 1 + delta / (1 + gamma_pos * delta)gamma_pos = 1 / (sl_max - 1)- 语速较慢时(delta < 0):
r_pen = 1 + delta / (1 + gamma_neg * (-delta))gamma_neg = 1 / (1 - sl_min)最后,
speed_sl_penalized_ratio = clamp(r_pen, sl_min, sl_max)这个公式的巧妙之处在于:
- 它会将极端值平缓地“拉回”安全区间,避免输出发生剧烈波动。
- 在安全区间附近,数值变化平滑且接近线性,可避免产生听感异常。
- 它通过
gamma_pos和gamma_neg实现非对称控制,可以分别设置“过快”和“过慢”时的约束强度。
这样,我们就得到了稳定的目标语速:
T_act = T_theo * speed_sl_penalized_ratio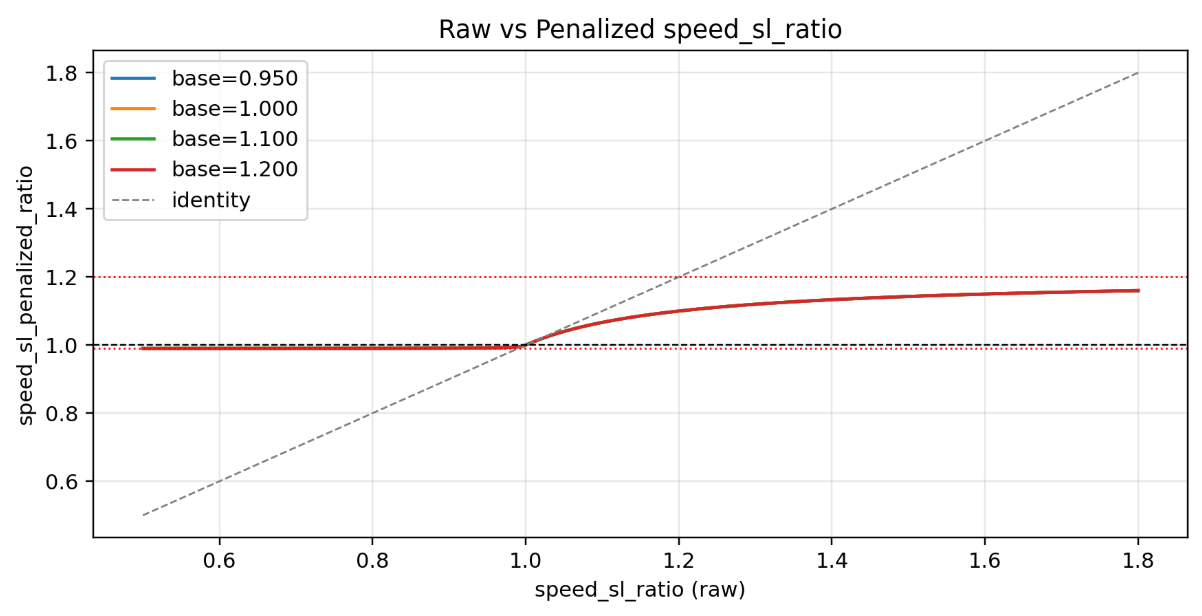
关键一步:将节奏偏差转化为“呼吸”调节
那么,受到惩罚的节奏差异去了哪里?算法巧妙地将其转移到短语之间的停顿中。这是算法的第二项创新。
我们引入一个核心变量:停顿缩放因子(
eff_ratio)。eff_ratio = base * (speed_sl_ratio / speed_sl_penalized_ratio)这个公式是节奏转换的桥梁:
- 如果
speed_sl_ratio > speed_sl_penalized_ratio(源语速过快并受到压缩),则eff_ratio > base。这意味着系统会延长停顿,补偿语速受限后仍可能存在的仓促感,给观众留出理解内容的时间。 - 如果
speed_sl_ratio < speed_sl_penalized_ratio(源语速过慢),则eff_ratio < base。系统会缩短停顿,防止节奏拖沓。
最后,使用
eff_ratio 缩放每个符合条件的停顿标签 <break time="Xms">:new_time = clamp(round(X * eff_ratio), min_pause, MAX_BREAK_MS)
系统流程与精细化处理
整个系统的处理流程清晰而稳健:
- 初始化:加载语言对的基础比率
base。 - 计算基线:
S_theo = T_theo * base - 分析偏差:
speed_sl_ratio = S_act / S_theo - 安全压缩:
speed_sl_penalized_ratio = compress_asym(speed_sl_ratio) - 节奏转换:
eff_ratio = base * (speed_sl_ratio / speed_sl_penalized_ratio) - 边界处理:对
eff_ratio进行微调、截断和“吸附到 1”处理(非常接近 1 时直接设为 1,以消除微小抖动)。 - 应用停顿:缩放所有超过特定语言阈值的停顿(例如中文为 80ms)。
我们还完善了以下细节:
- 阈值保护:忽略极短停顿,以保留自然的语言韵律。
- 硬边界保证:将
eff_ratio严格限制在[0.65, 1.50]范围内,以应对极端情况。 - 输出量化:所有时间均量化为 10ms 的整数倍,确保前端显示稳定(例如 1230ms 显示为 1.23s)。
优化示例(含节奏调整后的样例)
以下示例展示了同一段旁白如何自然适配不同语言。
算法会自动优化停顿时长,以保持自然的节奏和舒适的听感。
英语(源语言):
["True voice translation captures the soul of speech,<break time="640ms"/> not just converting words, but the living rhythm between them.", "Each language breathes at its own unique pace,<break time="519ms"/> and now we can teach machines to understand the stance of human expression."]
中文:
["真正的语音翻译能捕捉到语言的灵魂,<break time=\"980ms\"/>不仅仅是将词语转换,而是传递它们之间鲜活的韵律。", "每种语言都有其独特的呼吸节奏,<break time="790ms"/> 现在我们可以教机器理解人类表达的立场。"]
德语:
["Echte Sprachübersetzung erfasst die Seele der Rede,<break time="500ms"/> nicht nur indem sie Worte übersetzt, sondern auch den lebendigen Rhythmus dazwischen.", "Jede Sprache atmet in ihrem ganz eigenen Rhythmus,<break time="400ms"/> und jetzt können wir Maschinen beibringen, die Haltung menschlicher Ausdrucksweise zu verstehen."]
这些多语言示例体现了算法对节奏的细致处理:
它在保留原意的同时动态调整时长和停顿,让每种语言都能按照自身的自然节奏“呼吸”。
结语
我们的算法实现了精细的“节奏解耦”:
- 文本内容得到忠实翻译,不受节奏调节影响。
- 主体语速被限制在舒适的安全区间内。
- 停顿节奏承担其余所有调节任务,负责塑造最终的听觉体验。
借助核心变量
eff_ratio,我们成功地将源语言的“节奏个性”转换成目标语言的“呼吸指令”。这项技术让机器能够理解并还原人类语言韵律的美感,也体现了技术与艺术的结合。