跨语言重现人类的表演,远比生成自然的人声困难。
引言
过去十年间,文本转语音(TTS)技术取得了长足进步。
如今,最先进的模型可以生成非常自然的人声,只需几秒音频就能克隆说话人的声音,甚至还能呈现不同的说话风格。
不过,如果你看过 AI 配音视频,可能会有过类似的感受:
- 译文是正确的。
- 克隆的声音听起来很真实。
- 但总觉得哪里……不太对。
对白略显仓促。
情绪与演员的表演不符。
停顿听起来不自然。
不同场景中的声音会发生细微变化。
口型没有完全同步。
最终的视频就是缺少原作的感觉。
这就引出了一个值得思考的问题。
既然现代 TTS 已经如此出色,为什么 AI 配音仍然这么困难?
答案其实很简单:
AI 配音不是语音合成问题,而是表演重建问题。
VMEG 每天处理覆盖 170 多种语言的数万项 AI 视频本地化任务,其中约 10% 的项目时长超过一小时,最长的项目则超过三小时。在这一过程中,我们获得的一个重要认识正是如此。
生成语音只是其中一个环节。
真正的挑战是重现令人信服的表演。
人们通常想象的处理流程
大多数人想象中的 AI 配音流程是这样的:
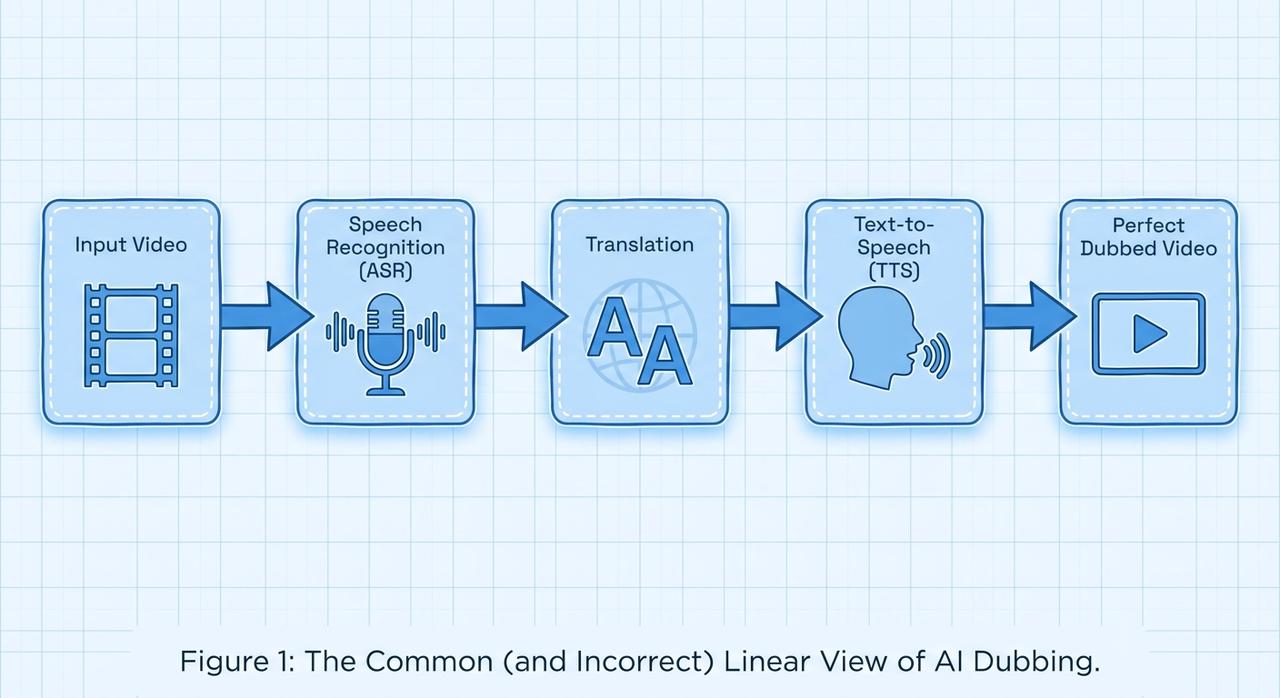
看起来非常合理。
遗憾的是,这套流程很少能产出观众真正愿意观看的视频。
因为从翻译到语音合成之间,缺失了大量信息。
文本转语音只解决了一个问题
传统 TTS 回答的是一个问题:
“给定这段文本,它应该听起来是什么样的?”
AI 配音要回答的问题困难得多:
“如何让这个人用另一种语言演绎这句话,同时保留原有的观看体验?”
这两者的目标有着根本区别。
TTS 模型专注于生成自然的语音。
配音系统则必须保留:
- 说话人身份
- 说话节奏
- 情绪
- 停顿
- 对话的流畅性
- 翻译约束
- 与视频的同步
- 整部影片中的一致性
自然的语音只是整个问题的一部分。
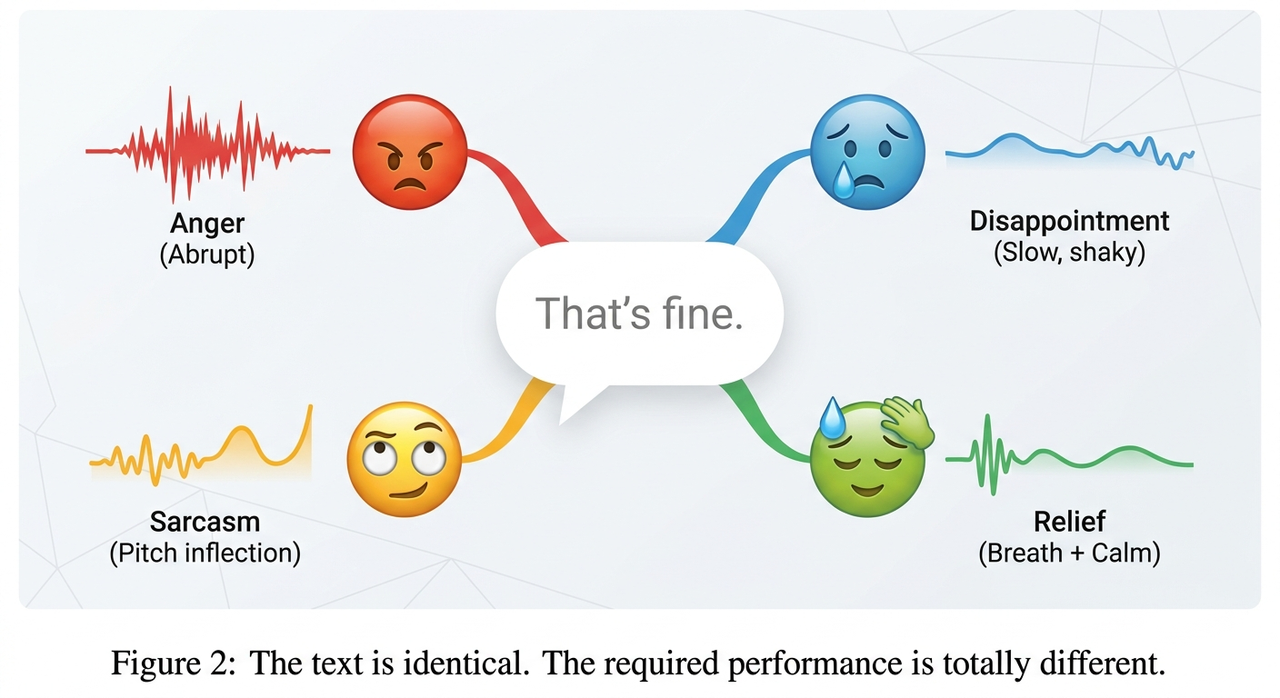
同一句话,多种演绎方式
来看下面这句话。
“没关系。”
TTS 模型看到的是:
That's fine.配音系统看到的信息则丰富得多。
| 属性 | 场景 A | 场景 B |
|---|---|---|
| 说话人 | 主持人 | 顾客 |
| 情绪 | 鼓励 | 沮丧 |
| 语速 | 平稳 | 快速 |
| 句前停顿 | 500 ms | 无 |
| 句后停顿 | 700 ms | 突然切断 |
| 面部表情 | 微笑 | 皱眉 |
| 镜头景别 | 全景 | 特写 |
| 口型可见度 | 低 | 高 |
文本完全相同。
演绎方式却不应该相同。
挑战 1:翻译会改变时长
人们对 AI 配音最大的误解之一,是认为翻译只是用一种语言替换另一种语言。
事实并非如此。
不同语言表达同一个意思时,所需的时长自然不同。
例如:
| 语言 | 示例 |
|---|---|
| 英语 | “我简直不敢相信。” |
| 德语 | 由于复合词和句子结构的特点,表达时长通常明显更长。 |
| 中文 | 通常更短、更紧凑。 |
| 日语 | 语法和节奏均不相同。 |
假设原说话人用 2.3 秒说完一句话。
翻译后,目标语言自然需要 3.5 秒。
此时,系统必须做出艰难的取舍。
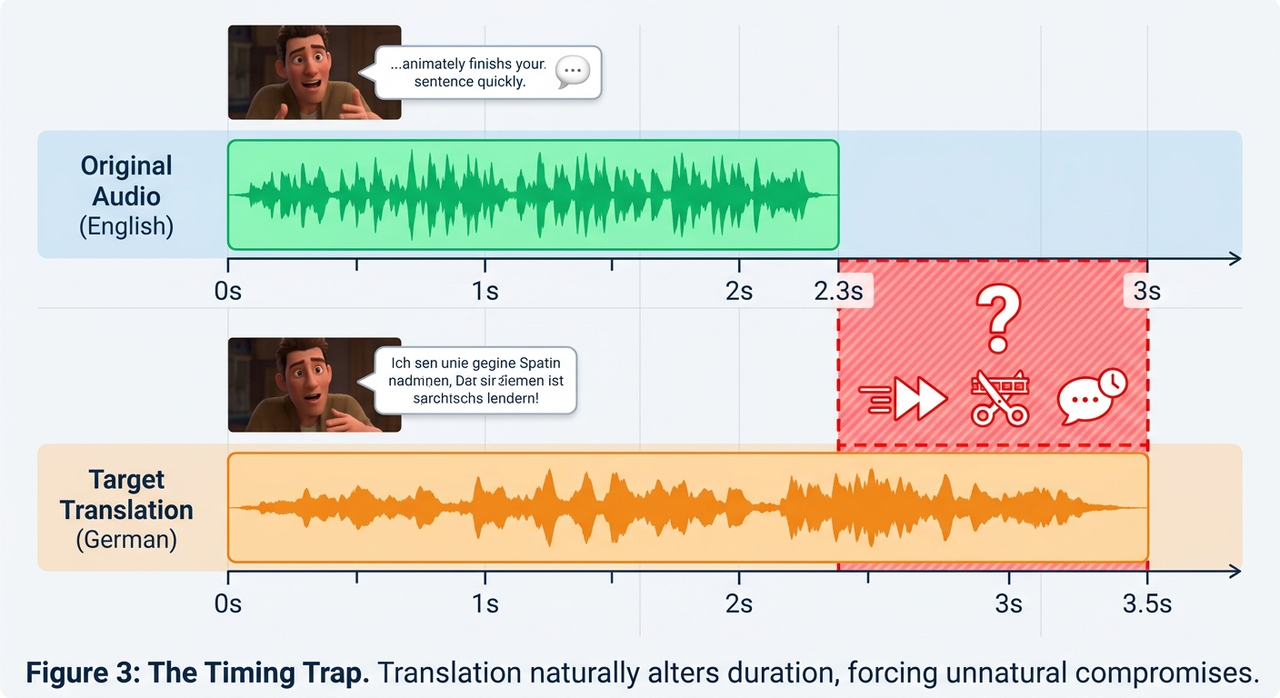
它应该
- 加快合成语音的速度?
- 改写译文?
- 缩短停顿?
- 略微压缩音频?
- 延长镜头之间的静音?
这些问题都无法由 TTS 模型解决。
它们属于本地化决策。
挑战 2:文字不会直接标明情绪
人类说话时不只是照着文字念。
人们还会理解话语的意图。
比如:
“行。”
它可能表达
- 同意
- 失望
- 讽刺
- 愤怒
- 释然
文字稿不会告诉我们答案。
视频往往可以。
面部表情。
肢体语言。
对话历史。
说话人之间的关系。
这些因素都会影响一句话应当如何表达。
近期针对表现力机器配音和视觉引导语音合成的研究表明,结合韵律、视觉上下文和时长控制,可以显著提高配音语音的自然度和同步效果。
挑战 3:时序决定成败
假设一条字幕在这里结束。
配音却晚了 300 毫秒才结束。
人类能够察觉到。
这种察觉未必是有意识的。
但人们会觉得对话不自然。
现在试想一下,这种情况在一部长片中出现数千次。
时序误差会不断累积。
口型同步会变得更加困难。
说话人轮次会变得混乱。
字幕也会逐渐错位。
流媒体平台也强调,字幕应与音频和画面剪辑紧密同步,因为时序会直接影响观看舒适度。
优秀的配音在口型同步之前就已经开始了。
挑战 4:语速与停顿
专业配音演员很少始终保持恒定的语速。
他们会
- 犹豫
- 打断他人
- 呼吸
- 通过停顿加强语气
- 兴奋时加快语速
- 情绪强烈时放慢语速
这些停顿本身就是沟通的一部分。
去掉这些停顿,通常会让合成语音听起来很机械,即使每个词都准确无误。
保留节奏与保证发音同样重要。
挑战 5:说话人一致性
在上一篇文章中,我们讨论了说话人分离为什么重要。
到了配音环节,原因便一目了然。
假设有一部两小时的纪录片,其中包括:
- 一名旁白
- 五名受访者
- 历史录音
- 观众提问
- 使用不同语言的嘉宾
每位说话人在整个节目中都应保持一致的合成声音。
一次说话人分离错误就可能导致:
- 使用错误的克隆声音,
- 旁白前后不一致,
- 对话令人困惑。
说话人一致性不只是自动语音识别(ASR)要解决的问题。
它会直接影响配音视频的可信度。
挑战 6:并非所有声音都应转换为语音
视频中除了对白,还有更多内容。
其中包括
- 音乐
- 掌声
- 笑声
- 欢呼声
- 静音
- 歌声
- 旁白
- 环境声
一段歌唱内容应该变成
♪ 永远不会放弃你 ♪
还是
[音乐]
又或者
保持原样?
正确答案取决于内容和本地化目标。
配音需要理解哪些内容应该重现,以及哪些内容应该保留。
挑战 7:口型同步开始得比你想象中更早
当最终视频看起来不自然时,人们往往会归咎于口型同步模型。
实际上,口型同步取决于此前每个环节的结果。
转写质量差
↓
翻译质量差
↓
时序不正确
↓
语速错误
↓
停顿位置不当
↓
口型同步失败
口型同步模型接收到的,可能本来就是无法处理的输入。
因此,近期研究越来越重视结合视觉信息共同控制语音时长和韵律,而不是将口型同步视为一个孤立的后处理环节。
AI 配音是一个系统工程问题
这或许是业内最大的误解。
人们常常比较不同的 TTS 模型。
但观众实际感受到的是整套处理流程。
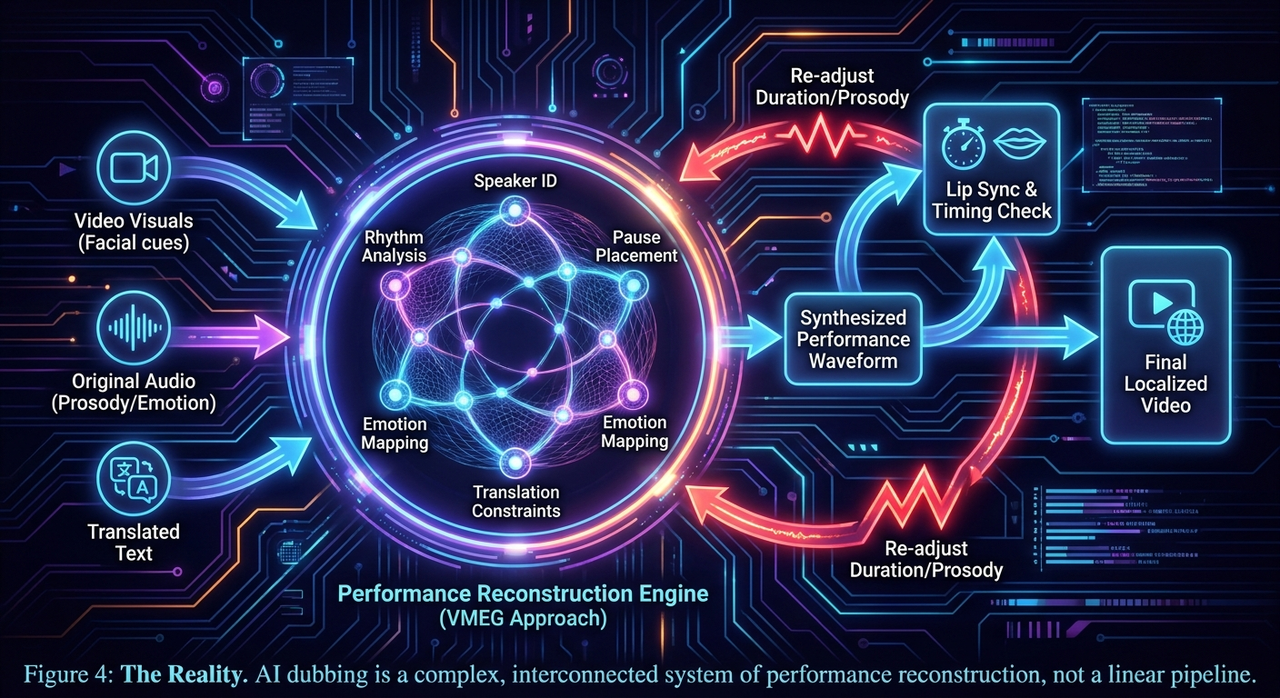
每个环节都会影响下一个环节。
只优化语音合成,通常无法产出效果最佳的配音视频。
VMEG 如何理解 AI 配音
在 VMEG,语音合成只是 AI 配音的一个组成部分。
在生成任何波形之前,我们的本地化流程会逐步分析:
- 说话人身份
- 多语言上下文
- 句子完整性
- 语速
- 停顿
- 情绪
- 字幕结构
- 翻译约束
- 同步要求
- 视觉上下文
我们不会只问:
“如何合成这句话?”
我们会问:
“如何用另一种语言重现这个人的表演?”
这种视角的转变几乎会影响每一项工程决策。
结语
文本转语音将文本转换为音频。
AI 配音重现人类的表演。
这是两个有着根本区别的问题。
随着语音合成模型不断进步,我们认为,下一阶段 AI 视频本地化的发展重点将不再只是生成更好的声音,而是更深入地理解原始表演,包括时序、情绪、节奏、说话人身份,以及表演与视觉场景之间的互动。
观众最终评判配音视频时,看的并不只是声音是否逼真。
他们更在意它是否让人感到与原作一致。
参考资料
语音识别与对齐
字幕与本地化指南
AI 配音研究