在多媒体后端工程中,FFmpeg 是绕不开的基础工具。VMEG 的视频翻译流程到了导出阶段,需要处理 TTS 配音的变速与音量、多轨混音、字幕烧录、水印叠加,以及音视频合并。许多团队在开发初期会把这些步骤拆成彼此独立的串行操作。
串行处理会重复编码并产生中间文件;具体多花多少时间,取决于素材、滤镜、编码参数和存储环境,需要实测。
这篇文章从底层原理出发,讨论如何减少中间文件、构建 Complex Filtergraph,并引入 ffmpeg-python,把 FFmpeg 的性能真正用起来。
核心问题:FFmpeg 为什么这么慢?
优化之前,先找出拖慢渲染的环节。原则很简单:在滤镜兼容且内存允许时,把相关操作合并到一张 Complex Filtergraph 中,尽量只解码和编码视频一次。
问题一:重复编码
编码通常是视频处理里最吃 CPU 的步骤。假设流程是:视频 A → 加水印并编码 → 中间视频 B → 加字幕并编码 → 最终视频 C。同一批画面会被解码、重新编码两次,不但产生代际画质损失,也重复消耗计算资源。
反例:同一批画面编码两次
# 第一步:添加水印,第一次编码
ffmpeg -i bg.mp4 -i watermark.png -filter_complex "[0:v][1:v]overlay" -c:v libx264 temp.mp4

# 第二步:读取中间文件并添加字幕,第二次编码
ffmpeg -i temp.mp4 -vf subtitles=sub.ass -c:v libx264 final.mp4
改法:用 Complex Filtergraph 合并成一次编码
FFmpeg 的 -filter_complex 参数可以在内存中建立有向无环图。解码后的音视频以原始像素(YUV)或原始采样(PCM)的形式经过叠加、字幕等过滤节点,最后输出时只编码一次。
# 一次编码完成水印和字幕
ffmpeg -i bg.mp4 -i watermark.png \
  -filter_complex "[0:v][1:v]overlay[vmark];[vmark]subtitles=sub.ass[vout]" \
  -map "[vout]" \
  -c:v libx264 final.mp4
一组可复现的本地对照
我们选取仓库里已有的两段视频,各截取 10 秒,并对其中一段另行复跑,分别执行两种处理:串行方案先叠加方框并编码中间 MP4,再烧录同一条字幕并编码成片;合并方案在一张 Filtergraph 内完成两项处理,只编码一次。两组都使用 FFmpeg 4.4.2、libx264、veryfast、CRF 23 和两个编码线程。预热一次后各运行三次,下表为两种方法的耗时中位数。
| 素材 | 串行两次编码 | 单次 Filtergraph | 本次比值 |
|---|---|---|---|
| 视频 A | 4.04 秒 | 1.99 秒 | 2.03 倍 |
| 视频 A,复跑 | 3.52 秒 | 2.09 秒 | 1.69 倍 |
| 视频 B | 5.56 秒 | 3.08 秒 | 1.81 倍 |
这只是本地示例,并非生产导出的基准测试。串行方案编码两次,因此即使两边使用相同 CRF,成片画质也不完全等价;同一素材复跑后比值发生变化,说明机器负载会影响结果;素材数量也不足以推导通用倍数。复现命令与逐轮数据保存在文章源码中。具体参数可查 FFmpeg 官方文档。
问题二:中间文件与重复处理
常见做法是在 Bash 脚本中串起多条 FFmpeg 命令。每条命令都要经历读取文件、解码、处理、编码和写回磁盘。这样会带来两个问题:
- 中间文件 I/O 可能成为瓶颈:无损中间格式等大文件会被反复读写。
- CPU 利用率取决于具体环节:解码器、滤镜、编码器和线程设置都会影响并行度;不能仅凭命令条数判断核心是否空闲。
改法:内存流转,多核并发
把多个过滤节点组装进同一张 Complex Filtergraph 后,中间帧和采样可以直接传给下一个滤镜,无需先写成中间文件。部分滤镜处理可以并行,但合并命令不保证 CPU 利用率提高,也没有固定提速倍数。
以视频翻译中的常见场景为例:多段 TTS 音频分别变速、调音量、设置时间轴偏移,最后再混音。
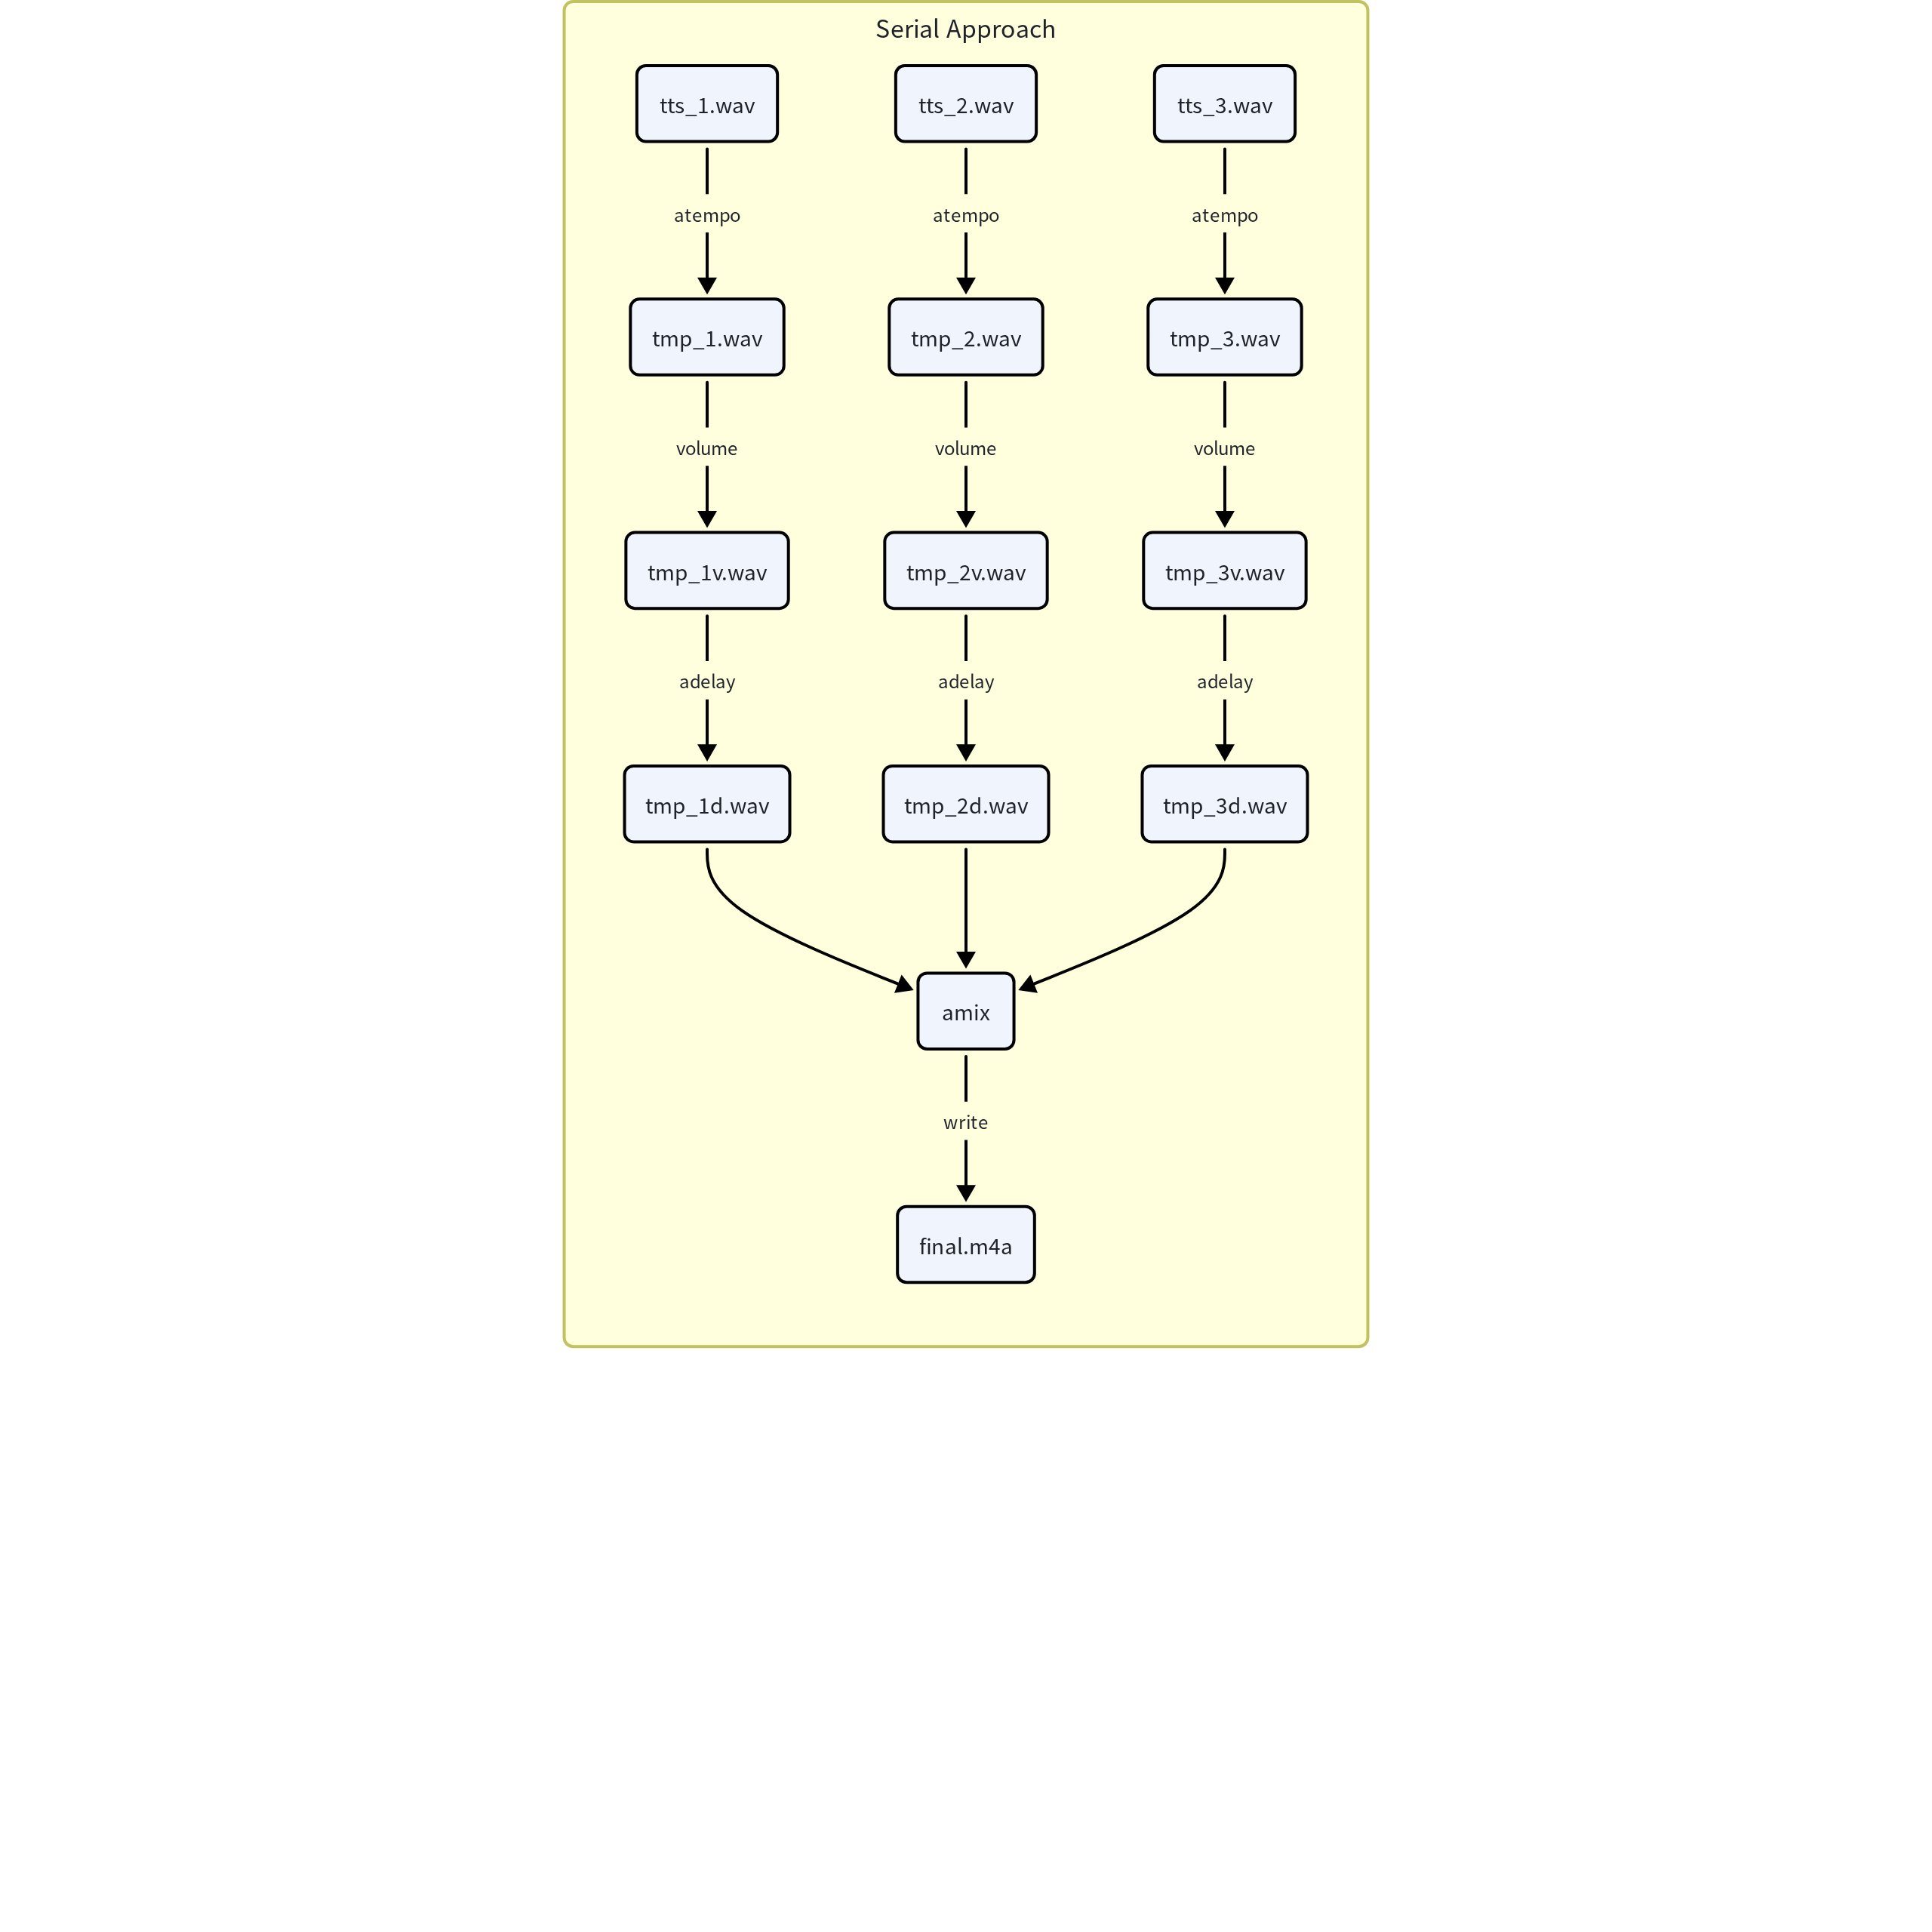
串行方式:多条 FFmpeg 命令和一批中间文件
# 第一步:逐段调整语速
ffmpeg -i tts_1.wav -filter:a atempo=1.2 tmp_1.wav
ffmpeg -i tts_2.wav -filter:a atempo=1.5 tmp_2.wav
ffmpeg -i tts_3.wav -filter:a atempo=1.0 tmp_3.wav

# 第二步:调整音量
ffmpeg -i tmp_1.wav -filter:a volume=0.8 tmp_1v.wav
ffmpeg -i tmp_2.wav -filter:a volume=1.2 tmp_2v.wav
ffmpeg -i tmp_3.wav -filter:a volume=0.9 tmp_3v.wav

# 第三步:设置开始时间偏移
ffmpeg -i tmp_1v.wav -filter:a adelay=0|0 tmp_1d.wav
ffmpeg -i tmp_2v.wav -filter:a adelay=5000|5000 tmp_2d.wav
ffmpeg -i tmp_3v.wav -filter:a adelay=10000|10000 tmp_3d.wav

# 第四步:最终混音
ffmpeg -i tmp_1d.wav -i tmp_2d.wav -i tmp_3d.wav \
  -filter:a amix=inputs=3:duration=longest final.m4a
这个示例会启动九次 FFmpeg,并写出多份中间 WAV。进程启动和文件读写都有成本;但 WAV 中间步骤并不等同于视频的重复有损编码。
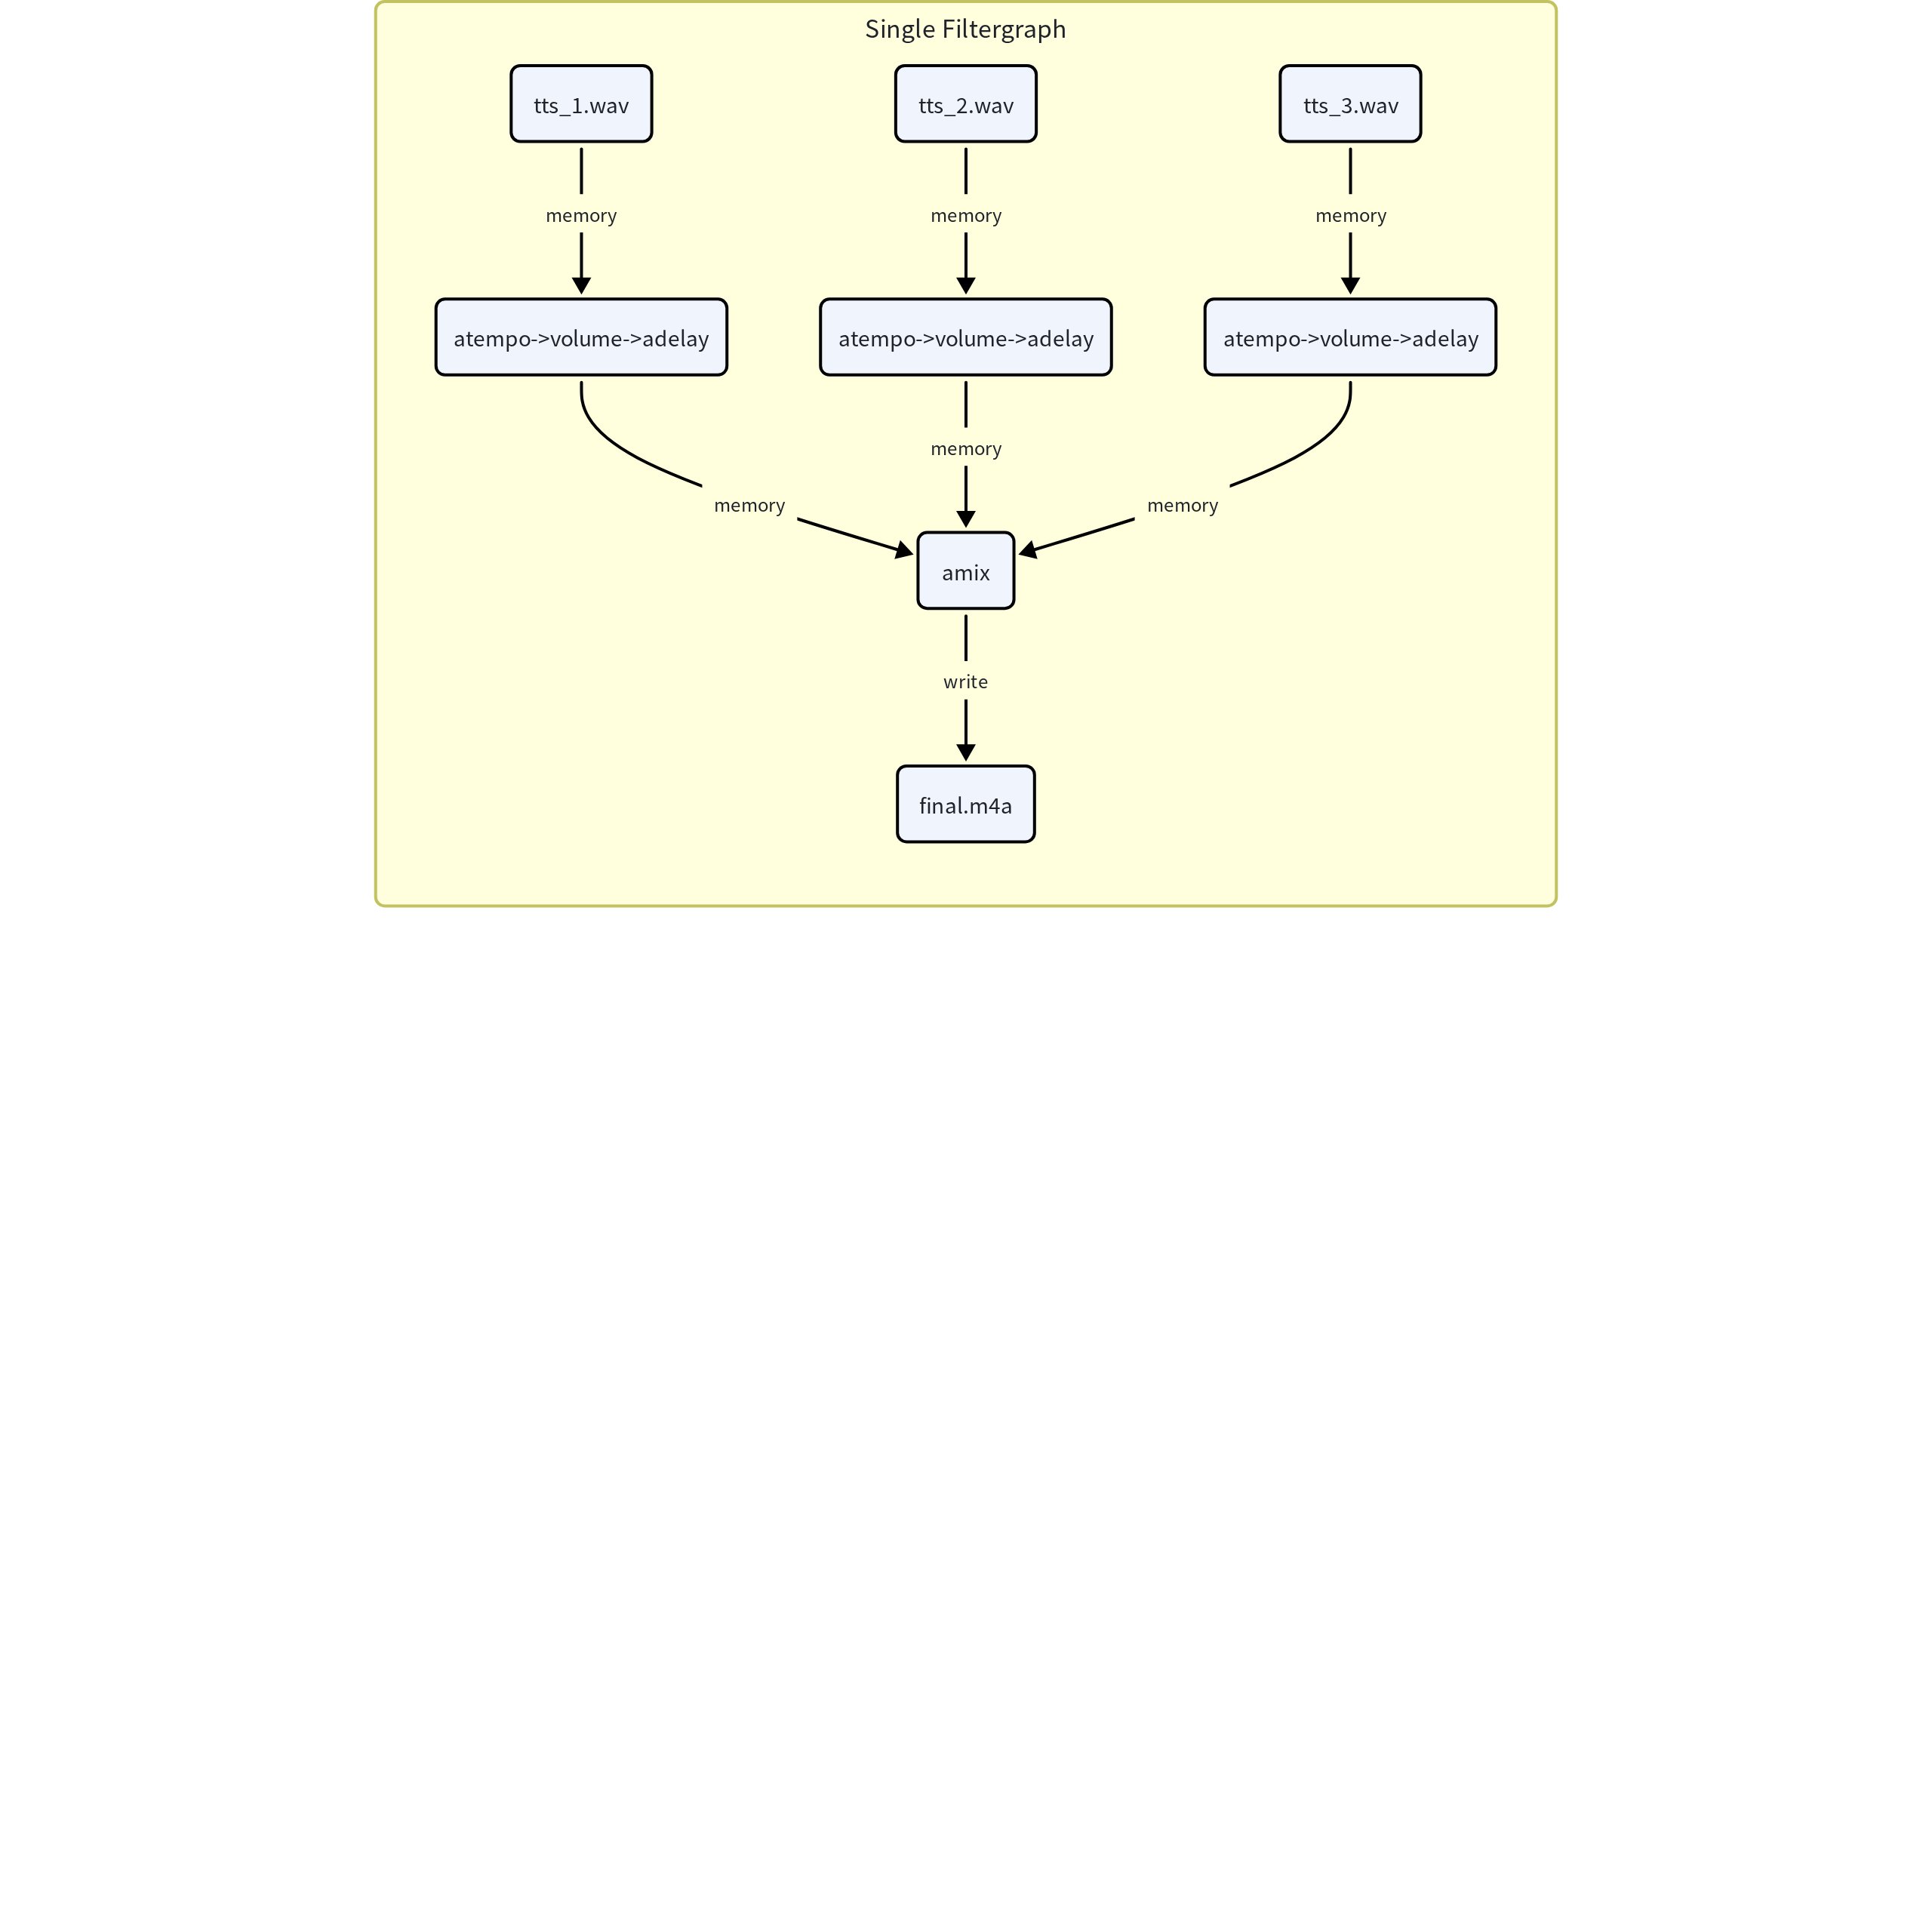
单张 Filtergraph:一步完成
ffmpeg -i tts_1.wav -i tts_2.wav -i tts_3.wav \
  -filter_complex \
  "[0:a]atempo=1.2,volume=0.8,adelay=0|0[a1]; \
   [1:a]atempo=1.5,volume=1.2,adelay=5000|5000[a2]; \
   [2:a]atempo=1.0,volume=0.9,adelay=10000|10000[a3]; \
   [a1][a2][a3]amix=inputs=3:duration=longest[aout]" \
  -map "[aout]" \
  -c:a aac final.m4a
合并后只需启动一次 FFmpeg,也省掉了示例中的中间音频文件。实际耗时仍取决于音频长度、输入格式和编码设置。
两种工作流对比:
工程难点:怎样维护复杂的 Filtergraph?
Complex Filtergraph 带来了性能,也带来了维护问题。直接拼接命令字符串,写到一定规模后几乎没人愿意碰。
业务逻辑一复杂,例如根据用户输入动态增加 N 张贴图、M 段音频和多语言字幕,最终命令可能有数千个字符。单引号、双引号、转义字符,以及 [v1]、[a2] 这类流标签都容易出错,排查起来也很费时间。
用 ffmpeg-python 声明式构建流水线
相比用 subprocess.run(f"ffmpeg -i ...") 拼字符串,更稳妥的办法是使用 ffmpeg-python。
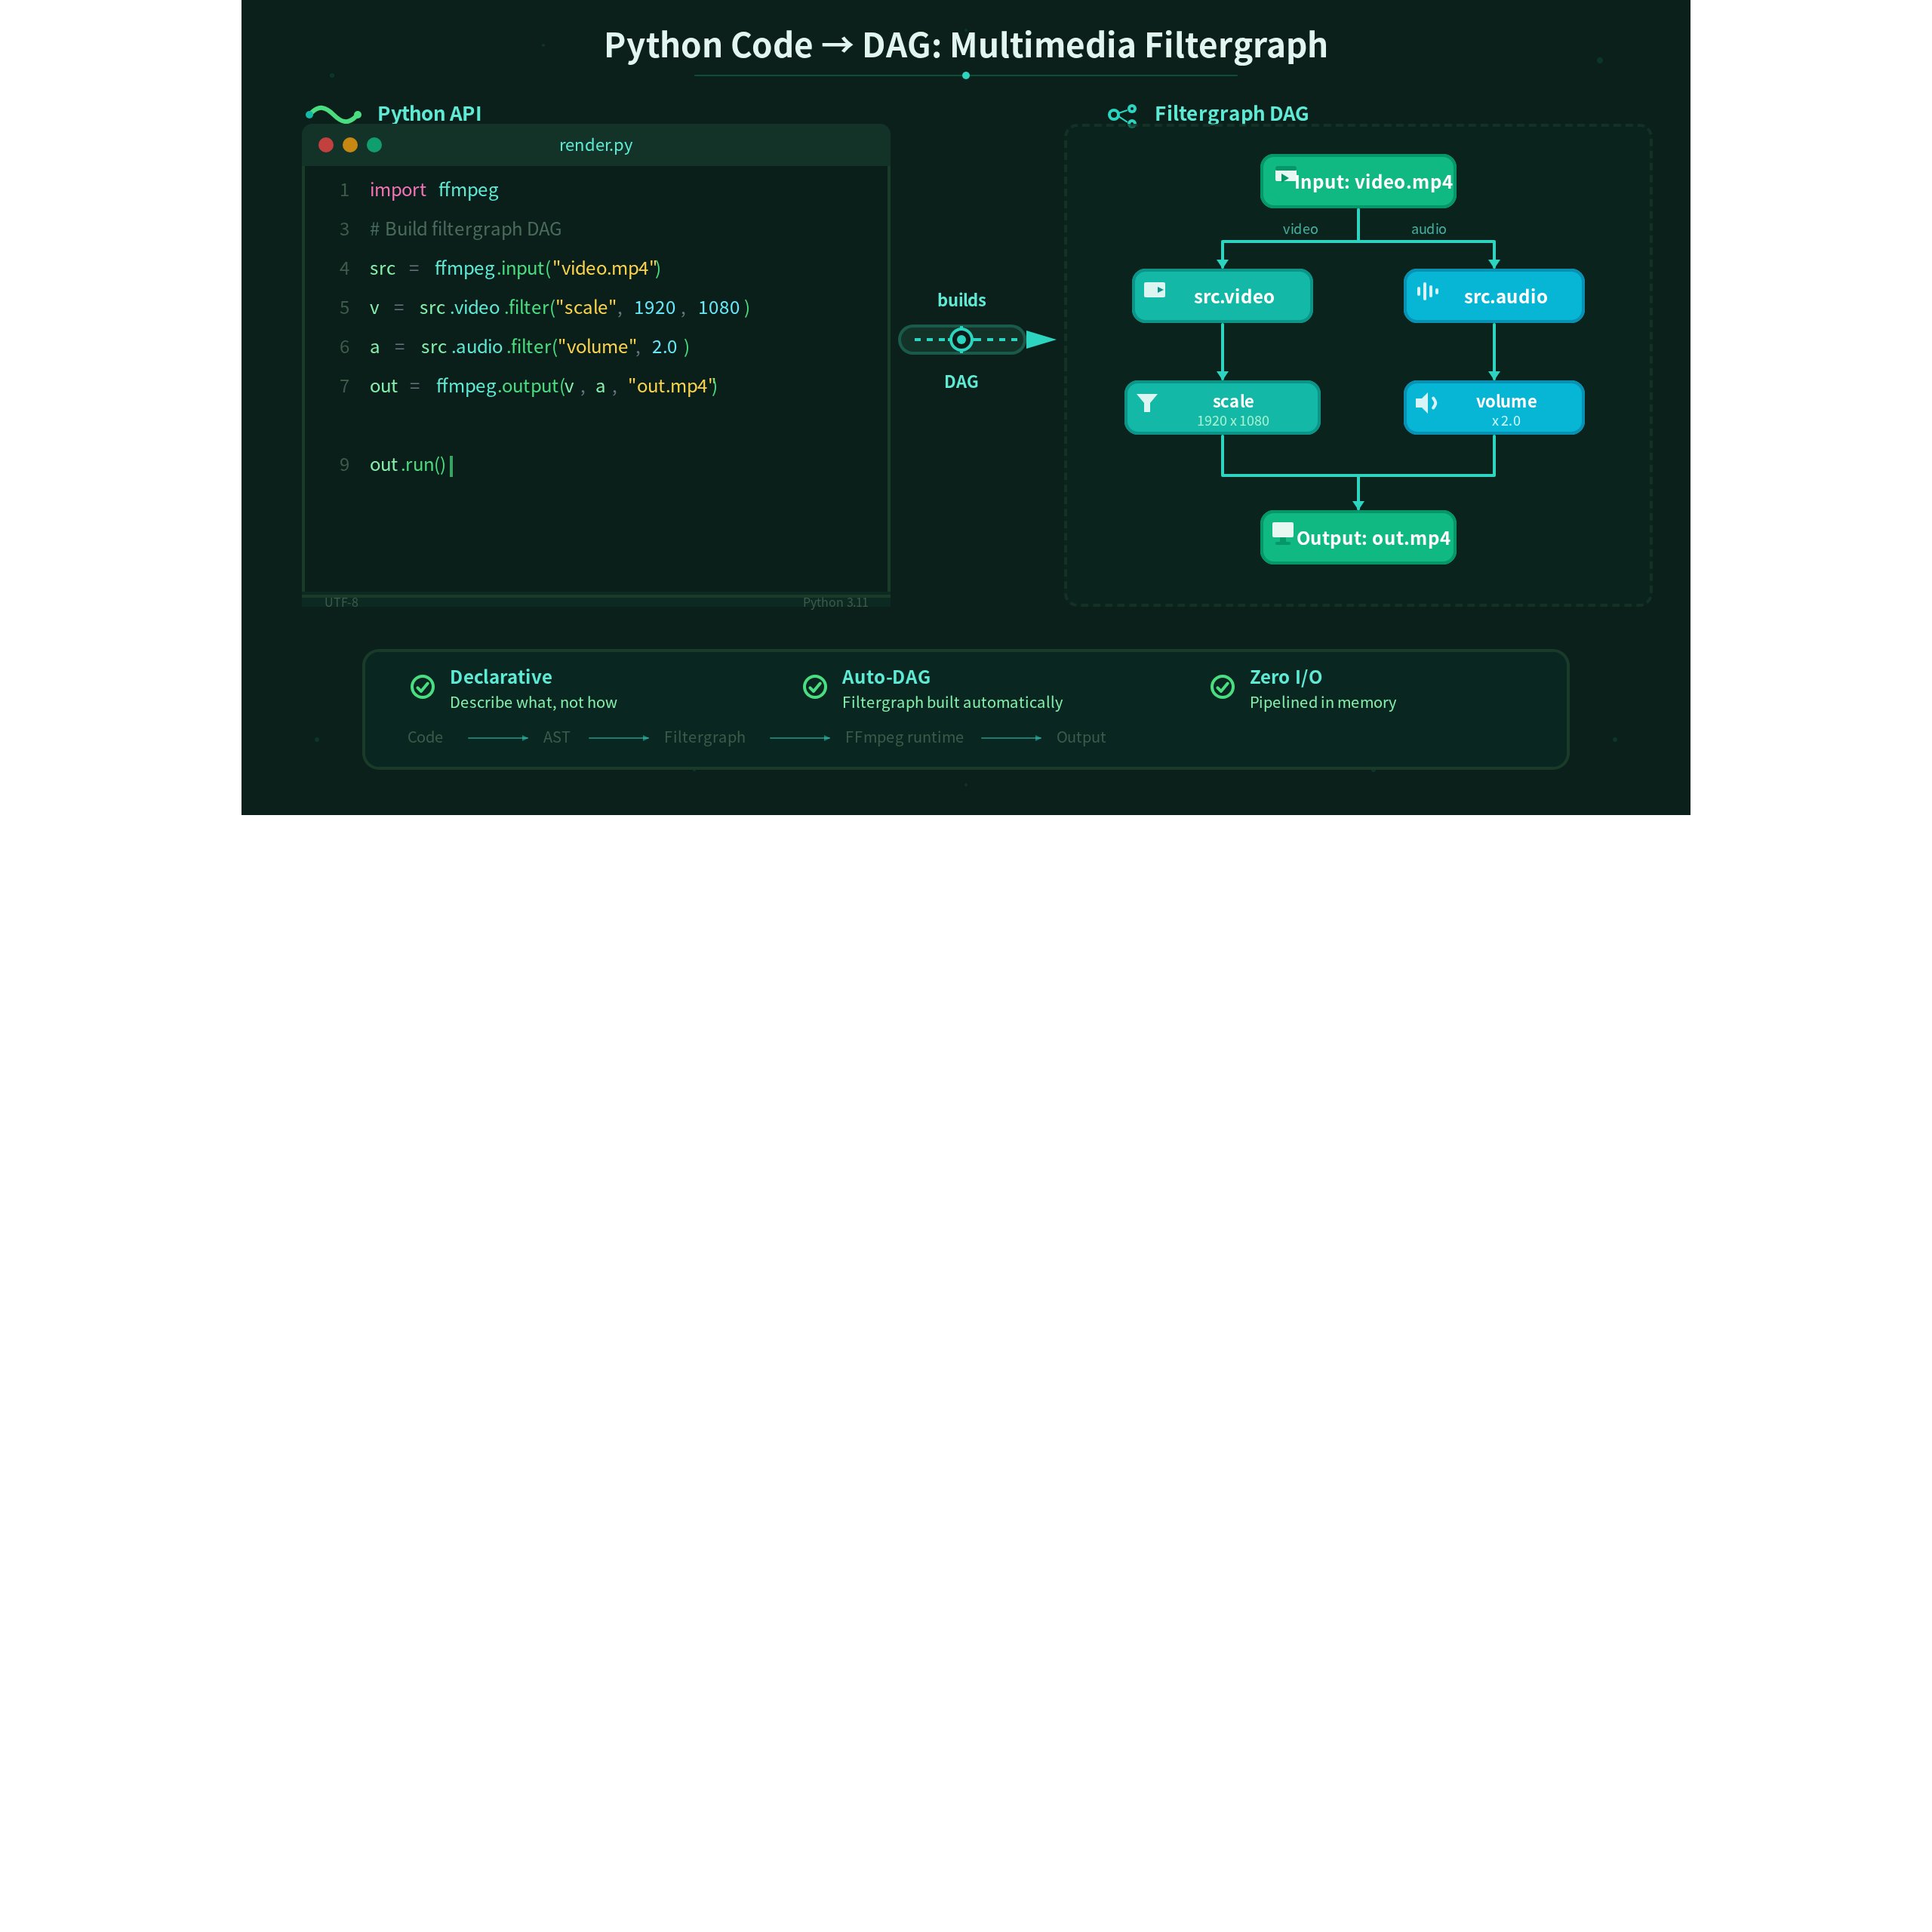
ffmpeg-python 提供的是声明式 API。调用时不会马上执行命令,而是先在 Python 中构建 DAG,最后再编译成正确的 FFmpeg 命令。流标签由库管理,业务逻辑可以拆成模块化、可复用的函数,很适合按业务条件动态组装复杂流程。
前面的 TTS 音频处理可以改写成:
import ffmpeg

# 声明输入源
tts_1 = ffmpeg.input('tts_1.wav').audio
tts_2 = ffmpeg.input('tts_2.wav').audio
tts_3 = ffmpeg.input('tts_3.wav').audio

# 每段 TTS 依次处理语速、音量和偏移
a1 = tts_1.filter('atempo', 1.2).filter('volume', 0.8).filter('adelay', '0|0')
a2 = tts_2.filter('atempo', 1.5).filter('volume', 1.2).filter('adelay', '5000|5000')
a3 = tts_3.filter('atempo', 1.0).filter('volume', 0.9).filter('adelay', '10000|10000')

# 混音并输出
audio_out = ffmpeg.filter([a1, a2, a3], 'amix', inputs=3, duration='longest')
output = ffmpeg.output(audio_out, 'final.m4a', acodec='aac')
ffmpeg.run(output, overwrite_output=True)
这里没有手写流标签,也没有命令字符串拼接。每个处理步骤都是清楚的 Python 对象链。复杂命令更容易拆开调试;每个过滤节点都能单独检查、复用和测试;输入输出关系直接写在代码里,不必在几百个字符中追踪 [a1]、[vout]。嵌套引号、漏写分号和参数拼错等问题也会少很多。
结论
把相关滤镜合并到一次处理,可以省去中间文件和一次编码。上面的两段本地样片中,合并方案均更快,但结果不足以证明通用的 10 倍或 100 倍提升。生产导出仍需用代表性素材,同时核对耗时、画质和内存占用。ffmpeg-python 有助于构建和维护命令,本身不会让 FFmpeg 滤镜运行得更快。
接下来:内存问题
性能提升没有免费的午餐。Complex Filtergraph 会尽量利用 CPU,也会带来新的风险,其中最常见的是 OOM(内存不足)。大量输入文件同时解码并在内存中排队等待合并时,内存占用可能突然升高,在内存受限的环境中直接触发 OOM。
长视频渲染该如何控制内存?下一篇文章会讨论这个问题。