引言
想象一下,你正在观看一段经过 AI 配音的访谈,主持人却突然用上了嘉宾的克隆声音。
或者,你正在阅读字幕,却发现每一句回答都被归到了错误的人名下。
转写文本本身可能完全正确,但观看体验会立刻变得不对劲。
这正是说话人分离如此重要的原因。
说话人分离要回答的问题很简单:
谁在什么时候说了话?
然而,要在真实视频中可靠地回答这个问题,难度超出许多人的预期。
更重要的是,单独优化说话人分离未必能改善整体用户体验。在生产级 AI 视频本地化系统中,它往往需要与转写准确率、字幕分段、翻译质量和配音一致性共同权衡。
本文将探讨其中的原因。
从语音到本地化视频
说话人分离只是整个大型处理流程中的一个环节。
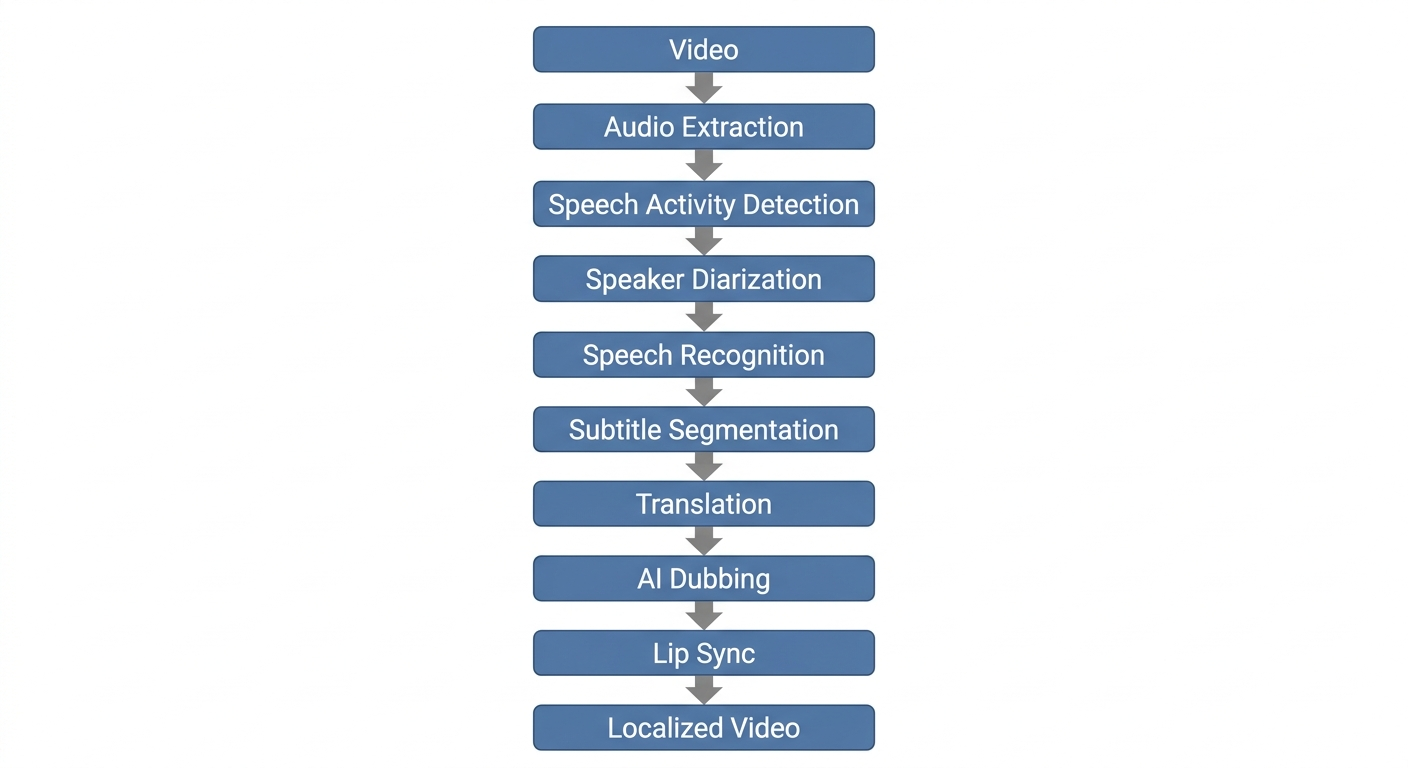
流程前段产生的错误会一直传递到最终视频。
一个错误的说话人标签就可能导致:
- 字幕归属错误
- 翻译前后不一致
- 使用错误的克隆声音
- 对话衔接混乱
- 观看体验受到干扰
为什么说话人分离很重要
在许多应用中,说话人的身份与其说出的内容同样重要。
以播客为例。
不进行说话人分离时:
Welcome everyone.

Thanks for inviting me.

Let's talk about AI.

Absolutely.
进行说话人分离后:
Host:
Welcome everyone.

Guest:
Thanks for inviting me.

Host:
Let's talk about AI.

Guest:
Absolutely.
转写文本立刻变得更容易理解。
接下来,再想象一下将这段对话翻译成日语,或者为其生成 AI 配音。
如果说话人标签无法保持一致,对话连贯性就更难维持。
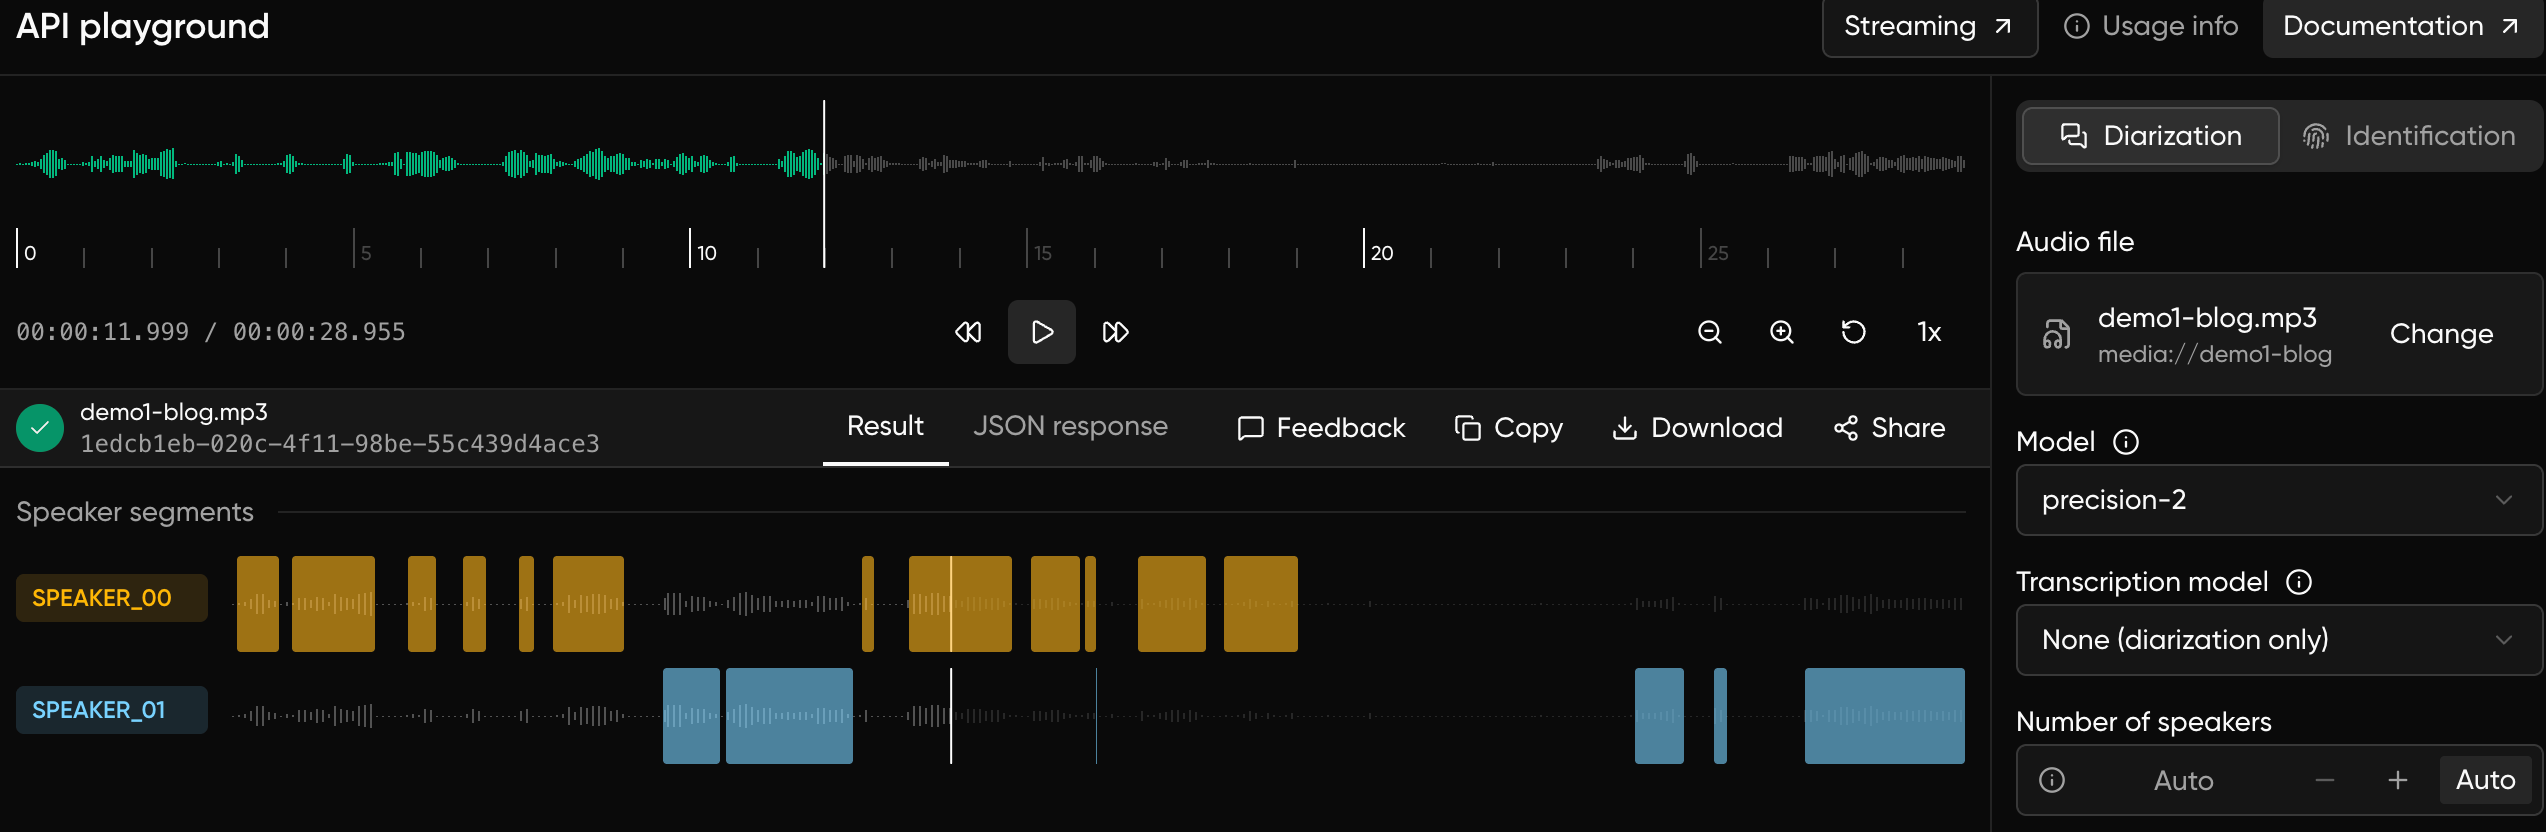
Pyannote:
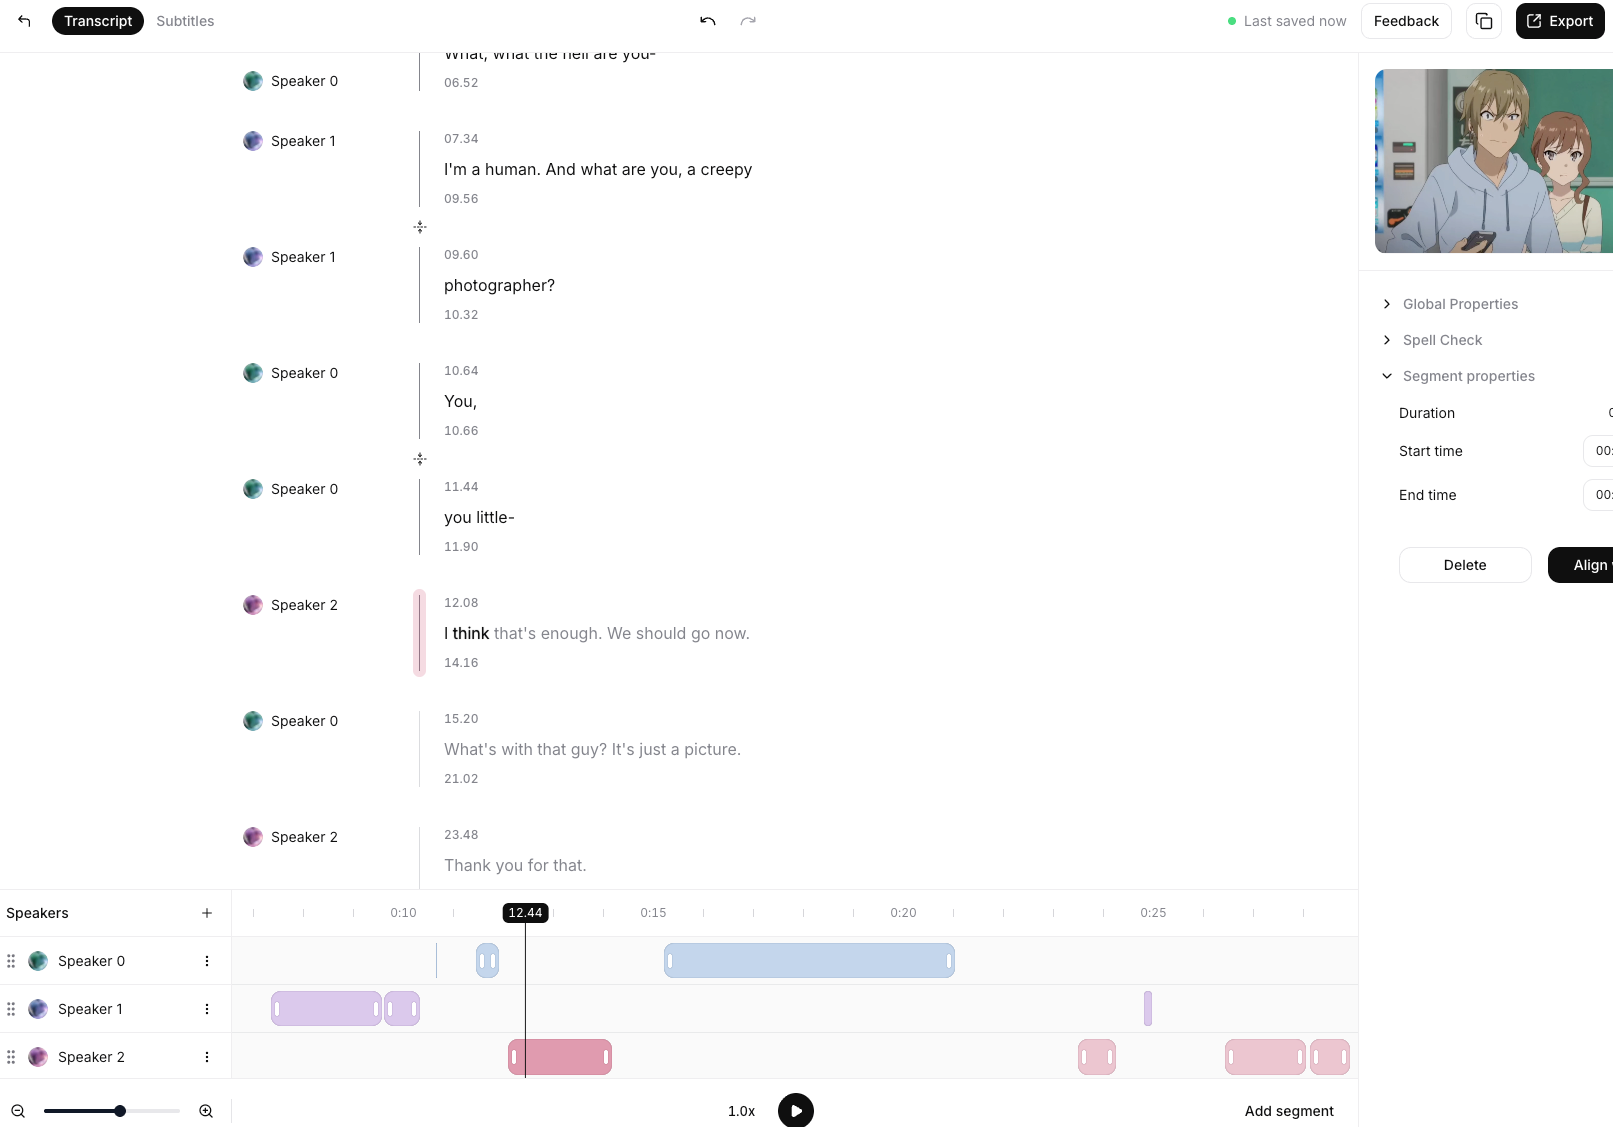
ElevenLabs:
VMEG:
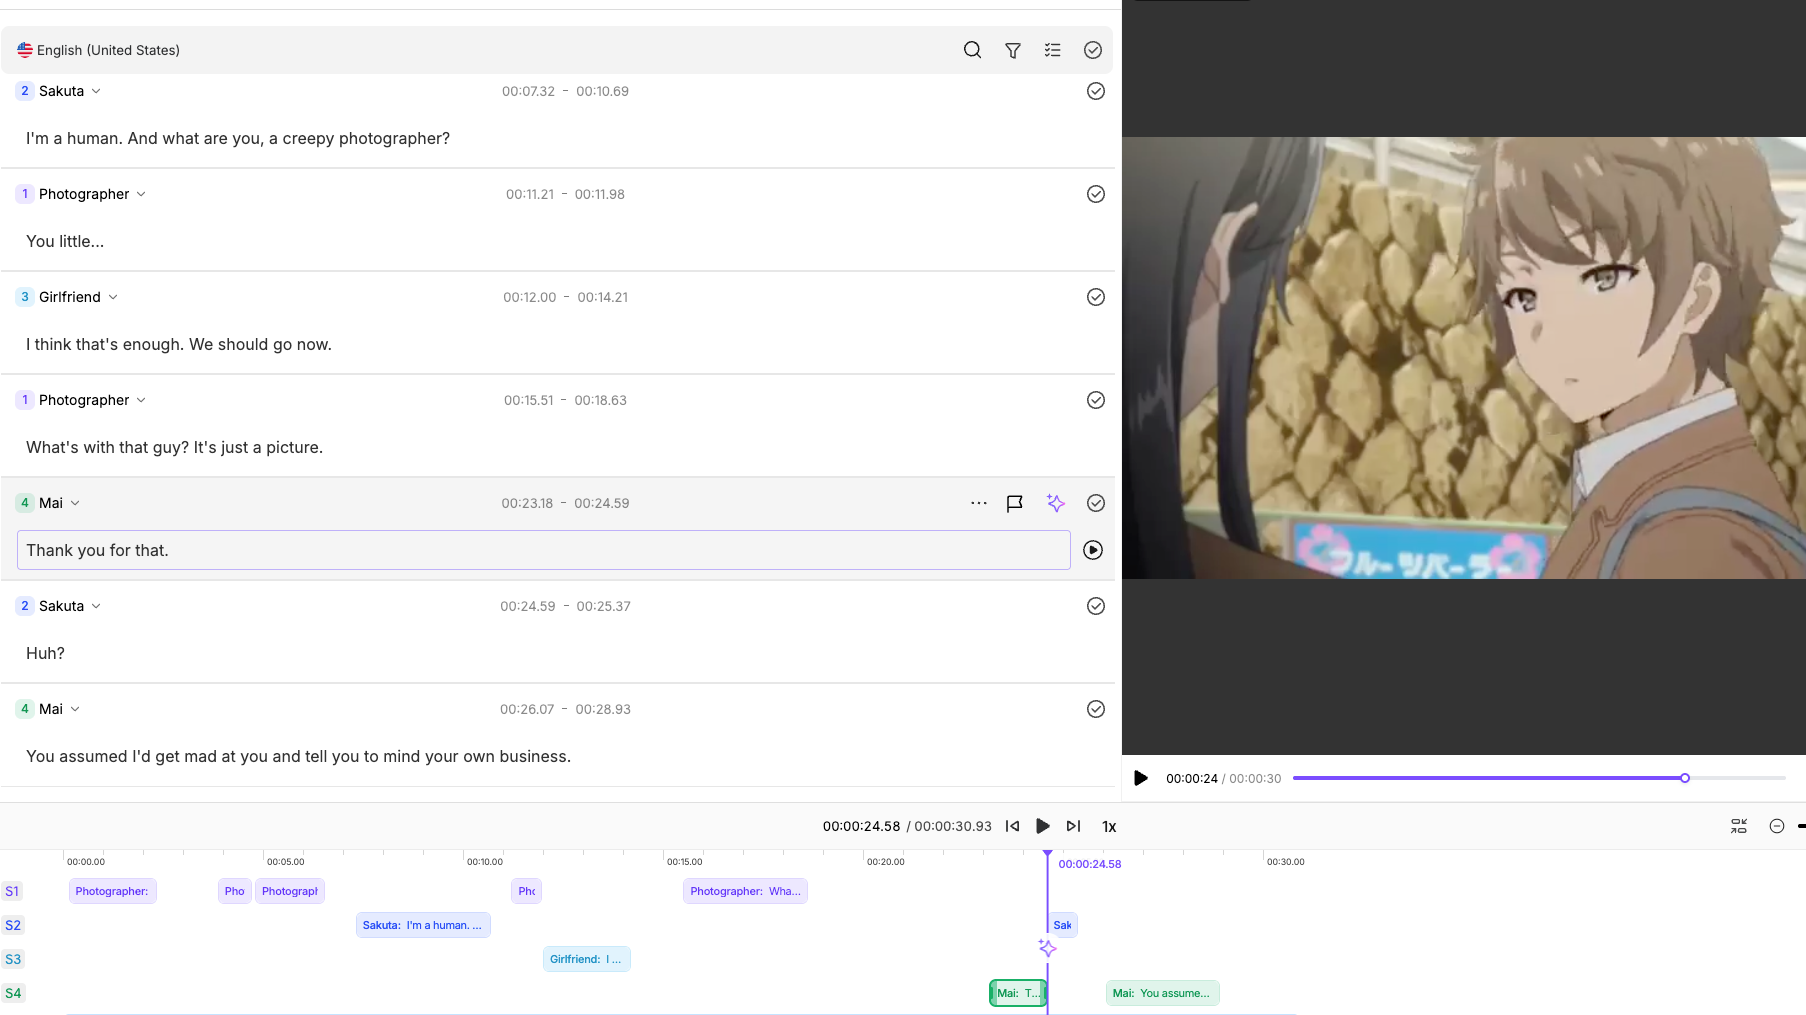
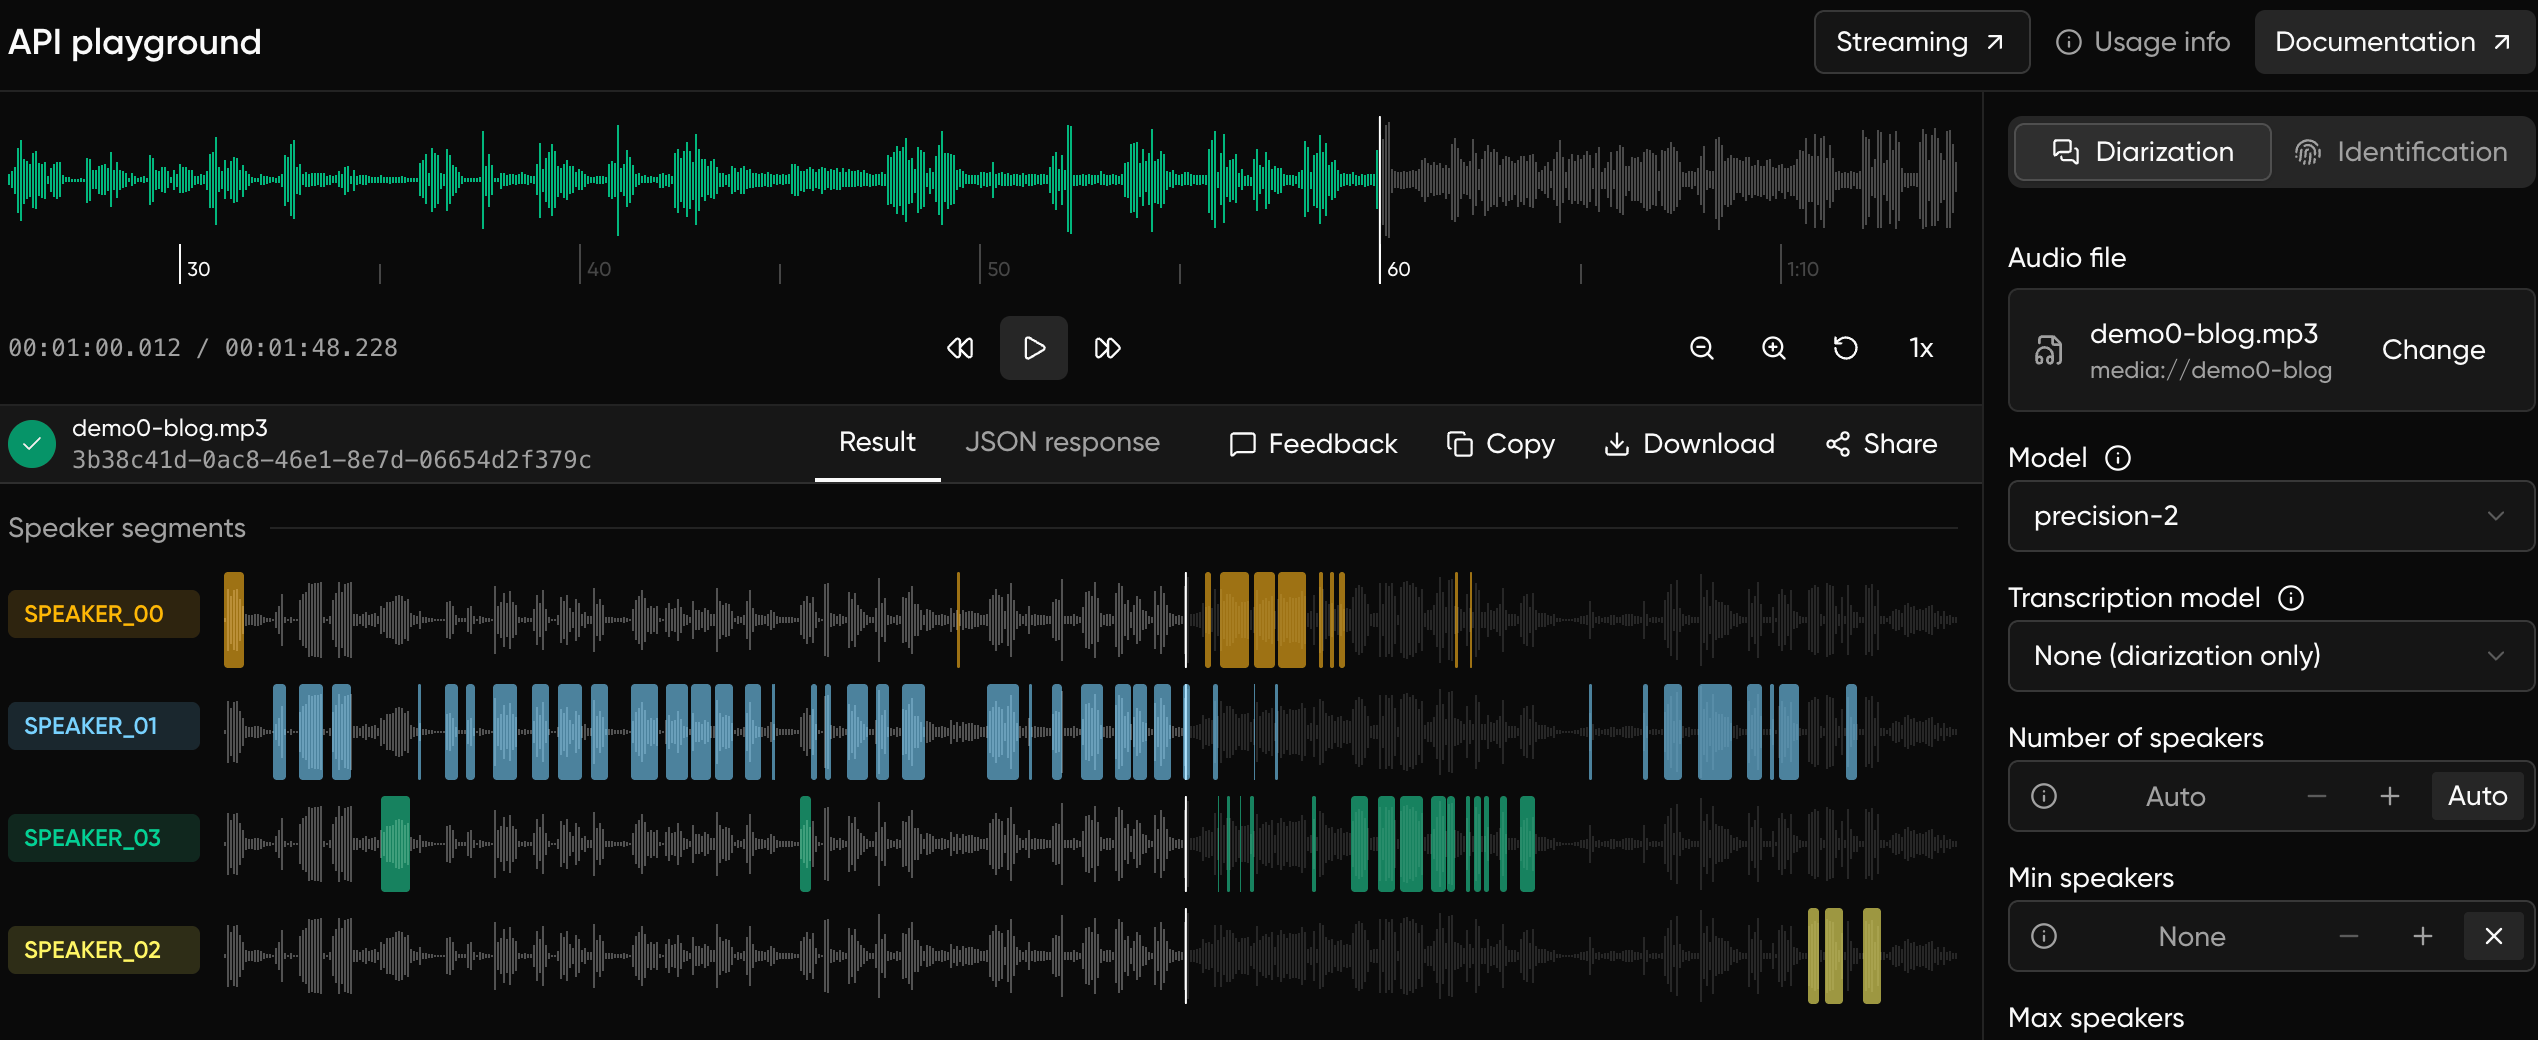
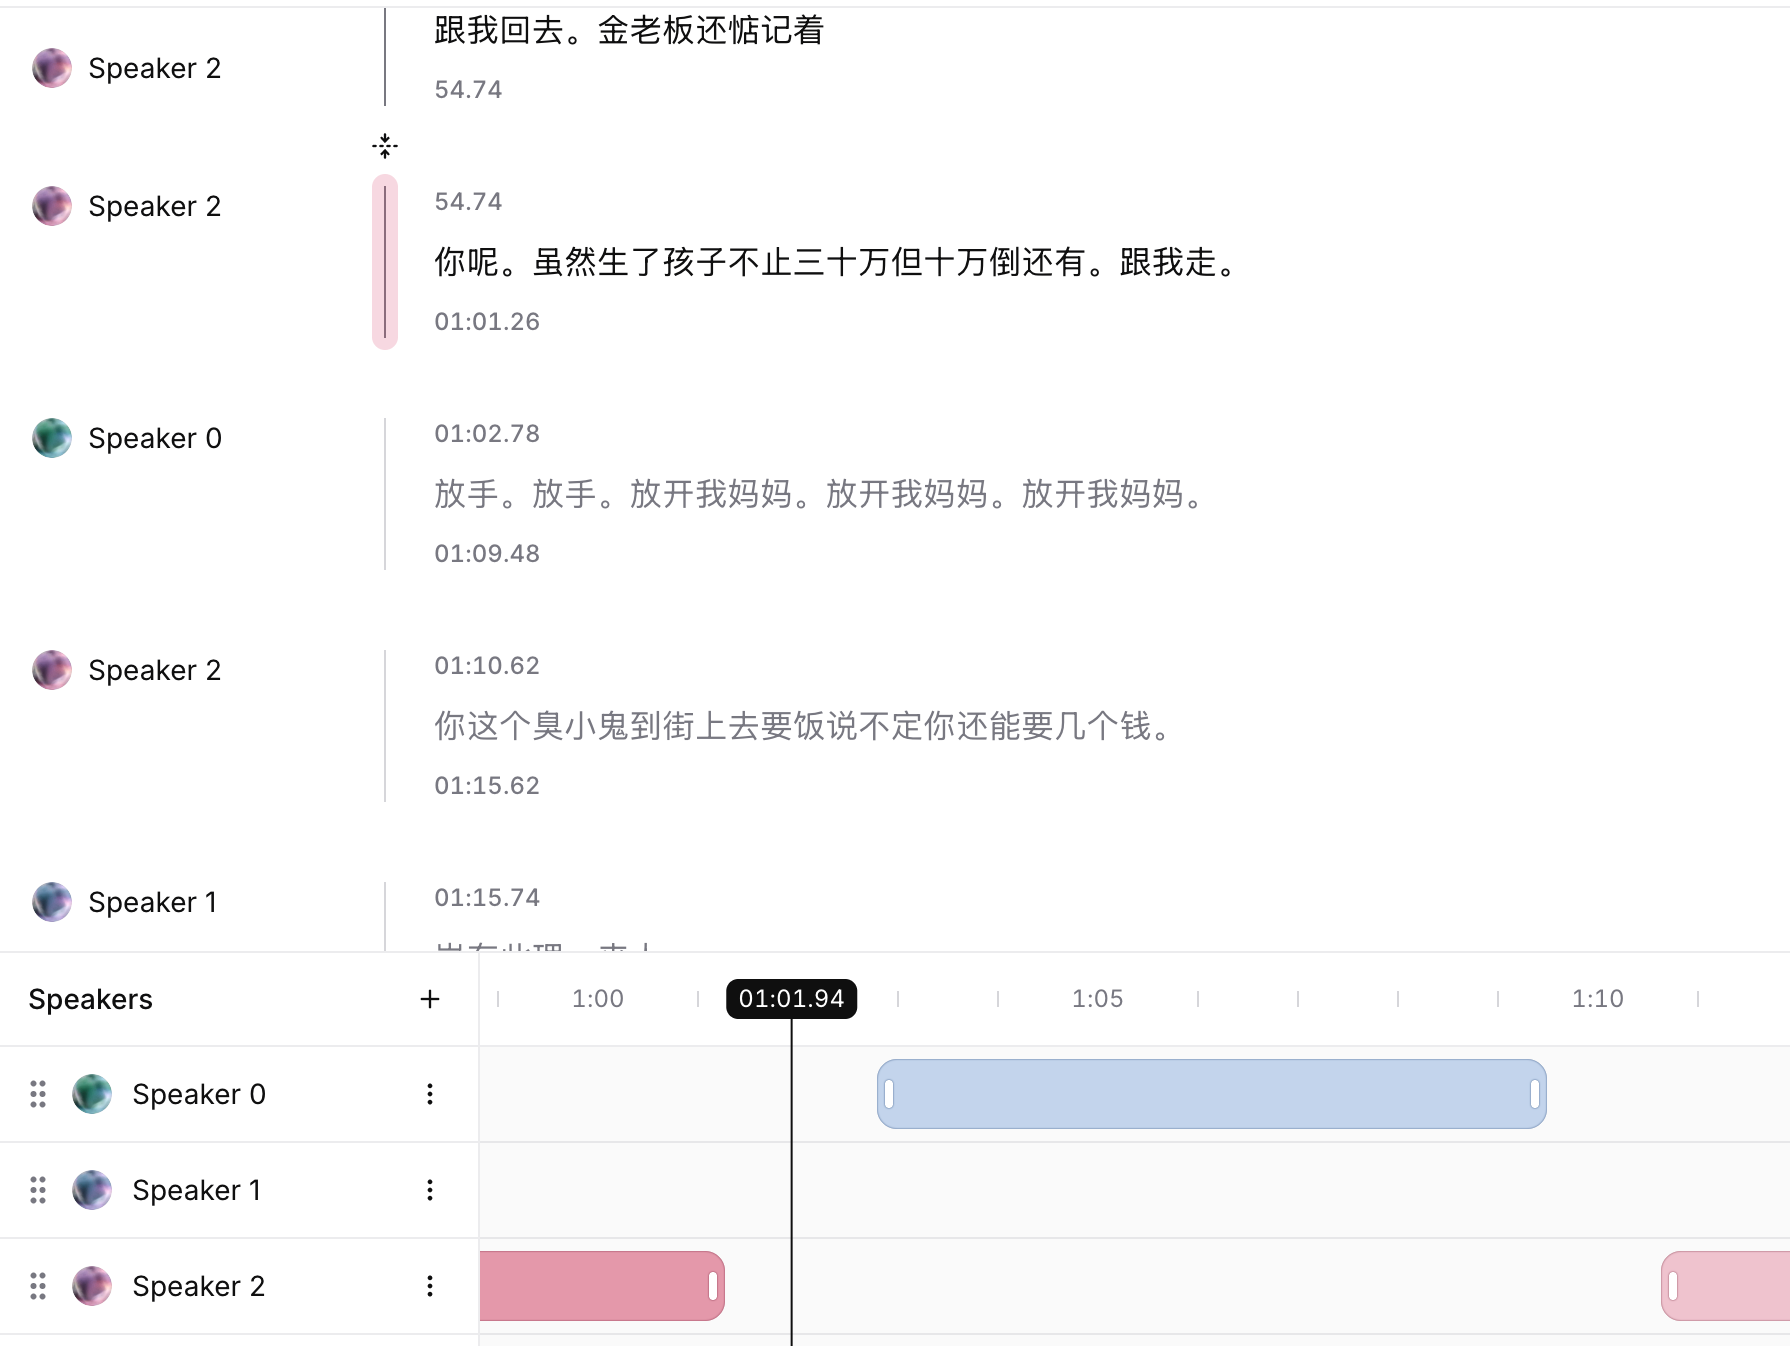
在这个案例中,ElevenLabs 只识别出三名说话人,也就是说,它将两名女孩判断成了同一个人。实际上,视频中共有四名说话人,包括两名男性和两名女性,而 pyannote 只识别出了两人。此类错误会导致整个视频配音任务出现声音一致性问题。
为什么说话人分离仍然困难
从许多基准数据集的结果来看,说话人分离似乎已经接近成熟。
真实视频呈现出的情况却有所不同。
常见挑战包括:
| 挑战 | 影响 |
|---|---|
| 语音重叠 | 多名说话人同时讲话 |
| 背景音乐 | 说话人嵌入的可靠性下降 |
| 声音相似 | 家庭成员或同事的声音可能很接近 |
| 带有情绪的语音 | 笑声、喊叫和耳语会改变声音特征 |
| 简短回应 | “Yeah”“Okay”“Mm-hmm”等回应包含的说话人信息很少 |
| 录音噪声 | 手机收音、回声和交通噪声会降低准确率 |
| 长视频 | 说话人漂移会随时间不断累积 |
现代说话人分离系统在受控条件下表现良好,但面对访谈、视频博客、直播或纪录片等开放场景视频时,准确率可能明显下降。
下面以一段典型短剧为例,对比 VMEG 与主流语音转文本服务商 ElevenLabs 的表现。
Pyannote:
ElevenLabs:
VMEG:
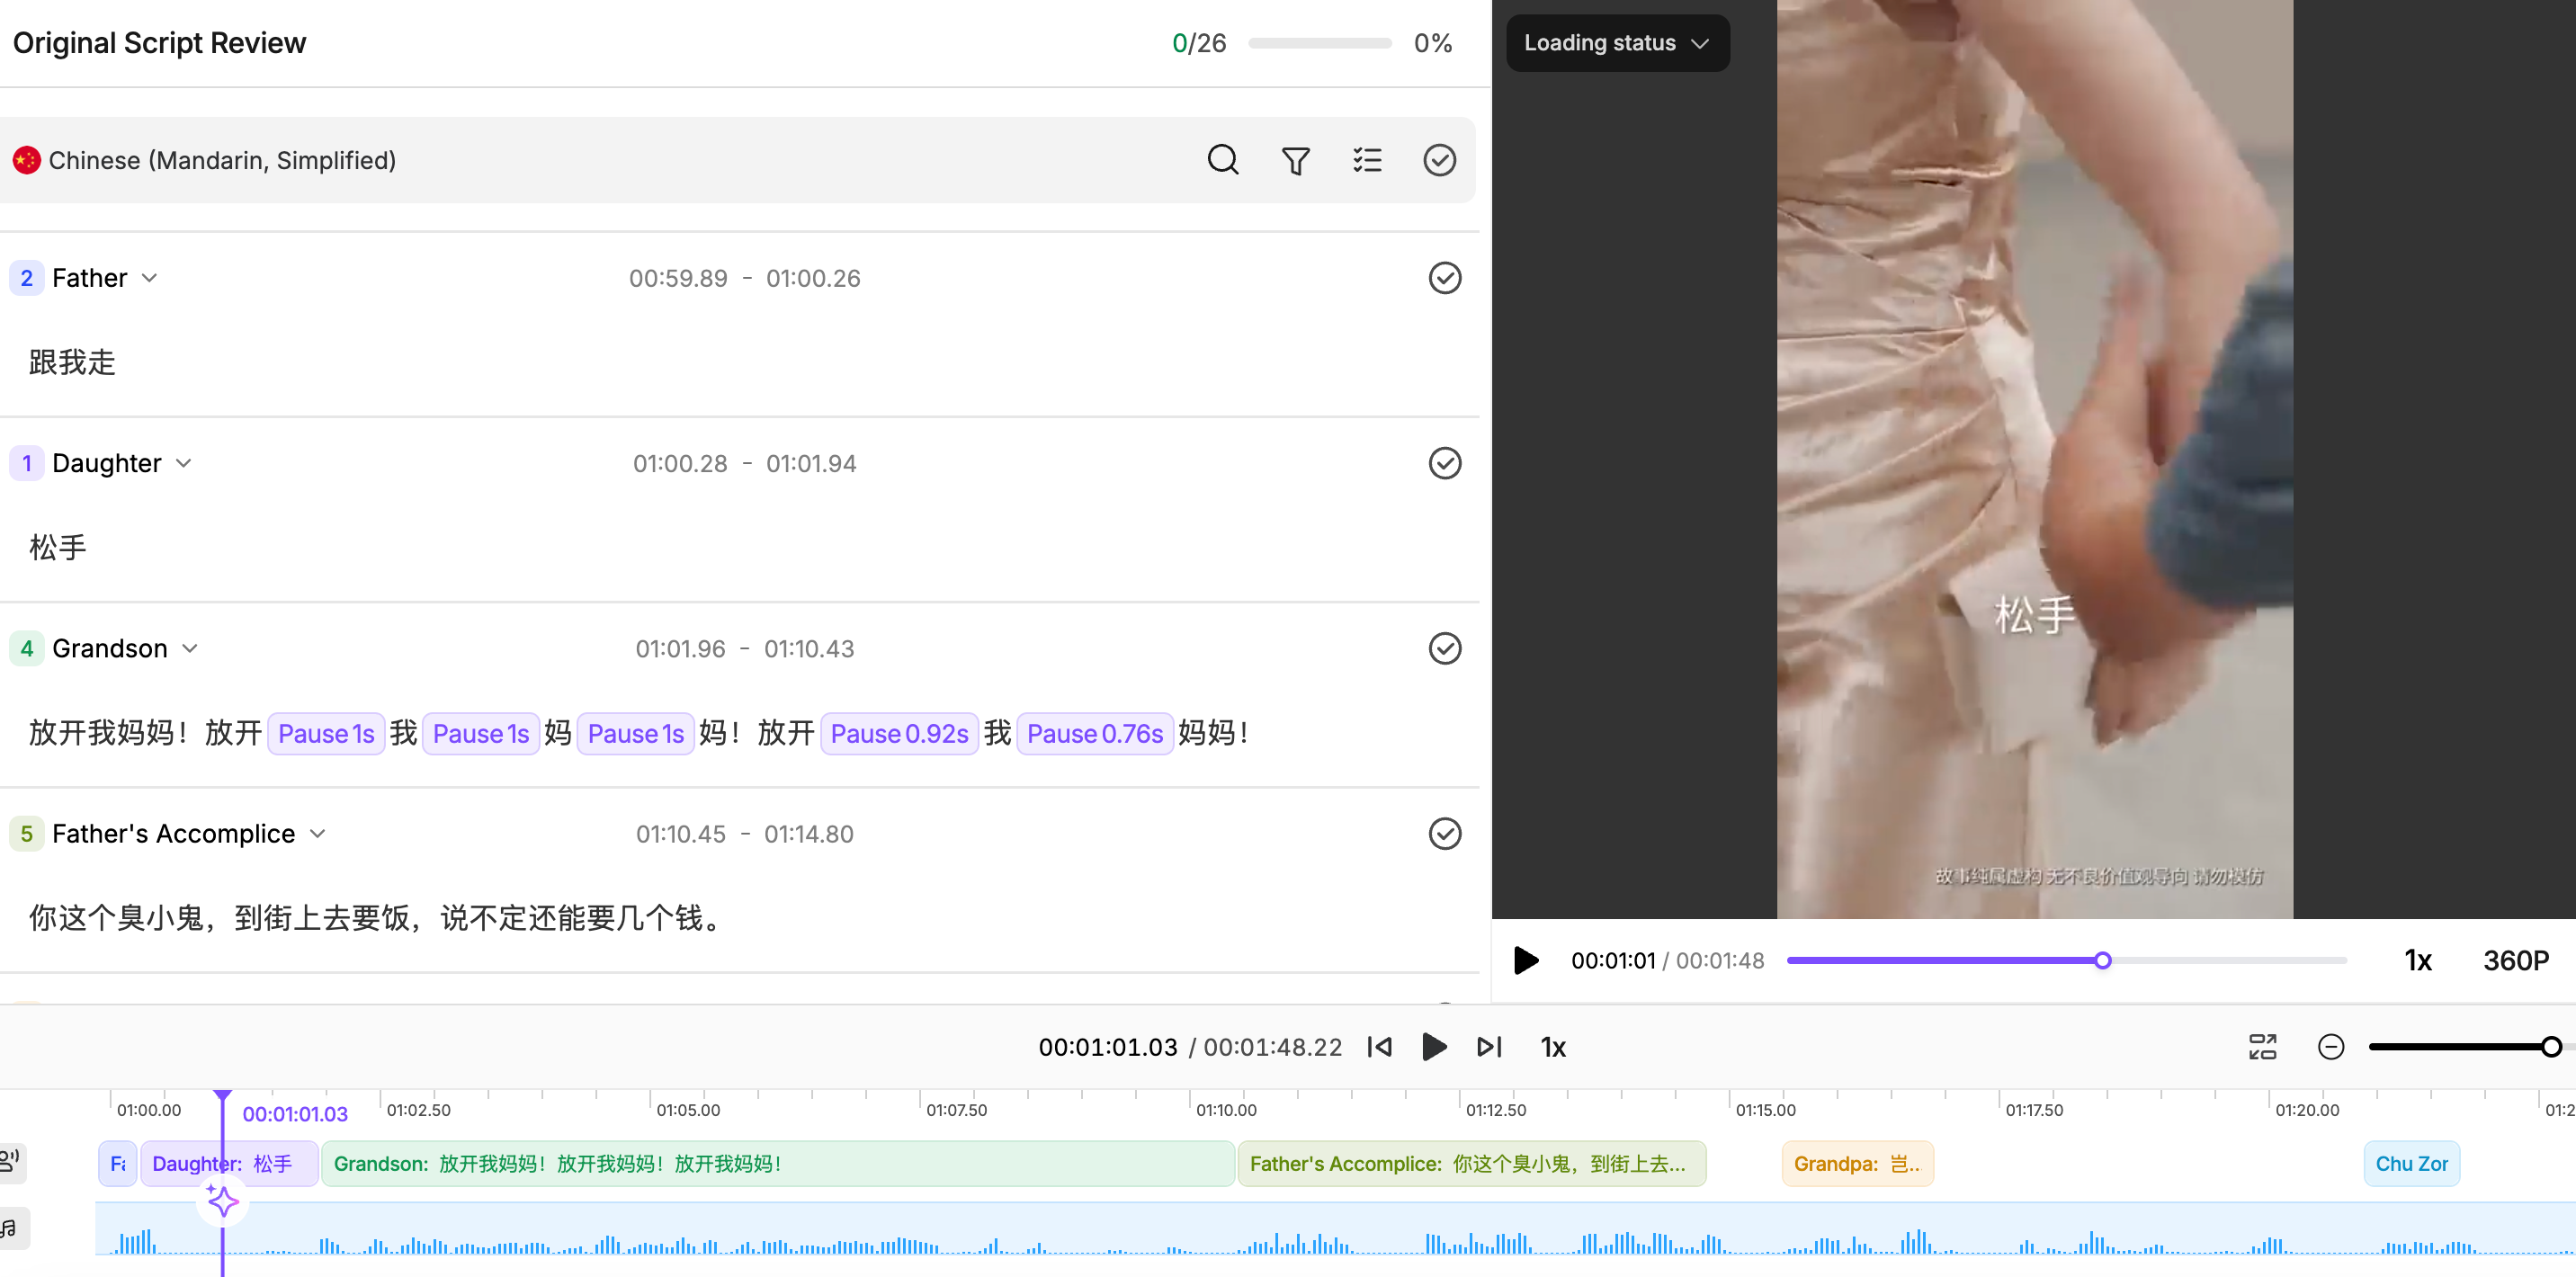
从 00:59.89 到 01:15.00,视频中共有四名说话人:父亲、女儿、孙子和父亲的同伙(可能是父亲的儿子)。VMEG 成功、准确地识别出了四人。然而,ElevenLabs 错误地将女儿和孙子识别为同一名说话人,又将父亲和父亲的同伙识别为同一人。这些错误会在配音过程中造成严重的声音一致性问题。
基准测试只能反映部分情况
说话人分离通常使用说话人分离错误率(DER)进行评估。
DER 衡量三类错误:
- 语音漏检
- 语音误检
- 说话人混淆
在广泛使用的研究数据集上,当前先进系统报告的 DER 通常大致处于以下范围:
| 场景 | 典型 DER* |
|---|---|
| 干净的会议录音 | 5–10% |
| 电话对话 | 8–15% |
| 播客 | 10–20% |
| YouTube 视频 | 15–30% |
| 大量语音重叠或录音噪声严重 | 20–40%+ |
*这些是不同数据集和评估设置中报告的代表性范围。实际表现会受到语音重叠比例、录音质量和评估协议的显著影响。
这些数字说明了一个重点:
在真实媒体场景中,说话人分离远未成为一个已经解决的问题。
隐含的权衡:说话人分离与转写
许多人认为,说话人分离效果越好,转写质量就一定越高。
事实并非如此。
请看下面这段对话:
Speaker A:
I think—

Speaker B:
Exactly.
以可读性为优化目标的转写模型可能输出:
I think exactly.说话人分离模型则更倾向于输出:
Speaker A:
I think—

Speaker B:
Exactly.
这两种输出都有其合理性,只是优化目标不同。
语音识别旨在自然地还原语言内容。
说话人分离旨在准确识别说话人的切换边界。
这两个目标有时会发生冲突。
另一项权衡:说话人分离与字幕分段
字幕系统还会引入另一项约束。
优质字幕应该:
- 保留完整语义
- 降低阅读负担
- 保持每行长度均衡
- 与语音同步
假设有这样一段对话:
Host:
I believe the best solution is—

Guest:
—to start with small experiments.
字幕系统可能更倾向于:
I believe the best solution
is to start with small experiments.
说话人分离系统则倾向于在说话人切换的位置准确断开。
这两种输出都无法适用于所有情况。
因此,彼此独立地优化各个 AI 组件,反而经常会降低字幕质量。
很小的说话人分离错误也可能严重影响用户体验
DER 对每一秒都一视同仁。
用户却不会如此感受。
假设有一段 45 分钟的访谈。
如果系统在第 5 分钟漏掉一次说话人切换,那么在下一次修正之前,之后的每条字幕都可能被归到错误的说话人名下。
从技术指标看:
- DER 只会小幅上升。
从实际体验看:
- 克隆声音会变得不一致,
- 字幕会让人困惑,
- 观众会立刻察觉异常。
因此,生产系统应该优化用户体验,不能只关注基准测试分数。
说话人分离只是其中一个优化目标
视频本地化需要同时优化多个可能相互竞争的目标。
| 组件 | 主要目标 |
|---|---|
| 语音识别 | 最大限度提高转写准确率 |
| 说话人分离 | 最大限度保持说话人一致性 |
| 字幕分段 | 提高可读性 |
| 翻译 | 保留原意 |
| AI 配音 | 使语音时序自然 |
| 唇形同步 | 保持画面同步 |
改善一个目标可能会损害另一个目标。
这也是生产系统与学术基准测试存在明显差异的原因之一。
生产系统的最佳实践
根据我们构建多语言 AI 视频本地化流程的经验,以下几项工程原则能够持续改善最终观看体验。
优化完整流程,而非单个模型
最好的说话人分离模型未必是 DER 最低的模型。
评估时,更应该考察说话人标签会如何影响字幕、翻译、配音和唇形同步。
结合声学信号与语言信号
仅靠说话人嵌入往往不够。
转写时间戳、标点、对话结构和上下文都可以帮助系统进一步校准说话人边界。
避免不必要的说话人切换
频繁更改标签会增加视觉干扰,并导致声音分配不一致。
时间平滑处理通常能够改善整体用户体验。
使用真实生产视频进行评估
会议场景的基准测试很有价值,但客户视频中还会出现音乐、剪辑切换、旁白、重叠语音和多语言对话。
务必使用生产数据进行验证。
评估不能止于 DER
随着视频本地化系统日益复杂,传统的说话人分离指标只能反映部分情况。
未来的评估还应该考虑以下问题:
- 同一名说话人在整段视频中是否始终使用相同的合成声音?
- 翻译是否正确保留了对话内容?
- 字幕是否更容易阅读?
- 配音后的对话听起来是否自然?
- 最终的本地化视频是否提高了用户满意度?
归根结底,用户不会直接感受到说话人分离分数。
他们感受到的是最终成片。
结论
说话人分离远不只是分配说话人标签。
它处于语音识别、字幕生成、翻译、AI 配音和唇形同步的交汇处。
衡量其效果时,不能只看基准测试准确率,还要看它能在多大程度上改善端到端的本地化体验。
有效的生产系统会将这一点纳入设计,从整体上优化流程,在多个相互竞争的目标之间取得平衡,而不是单纯追求某一项指标的最大值。
参考资料
- Bredin, H. 等,pyannote.audio:用于说话人分离的神经网络基础模块。https://github.com/pyannote/pyannote-audio
- NVIDIA NeMo 说话人分离文档。https://docs.nvidia.com/nemo-framework/
- DIHARD 说话人分离挑战赛。https://dihardchallenge.github.io/
- AMI 会议语料库。https://groups.inf.ed.ac.uk/ami/corpus/
- VoxConverse 数据集。https://github.com/joonson/voxconverse
- Park, T. 等,说话人分离综述:深度学习领域的最新进展。https://arxiv.org/abs/2101.09624
- NIST 富转写评测。https://www.nist.gov/itl/iad/mig/rich-transcription-evaluation
- ElevenLabs 语音转文本。https://elevenlabs.io/speech-to-text