持续学习不只发生在模型训练中。
模型从数据中学习模式;规则、指标和实验闭环,则让整个系统学习什么值得优化、什么不能牺牲。对复杂的生产算法来说,后者往往与模型能力同样重要。
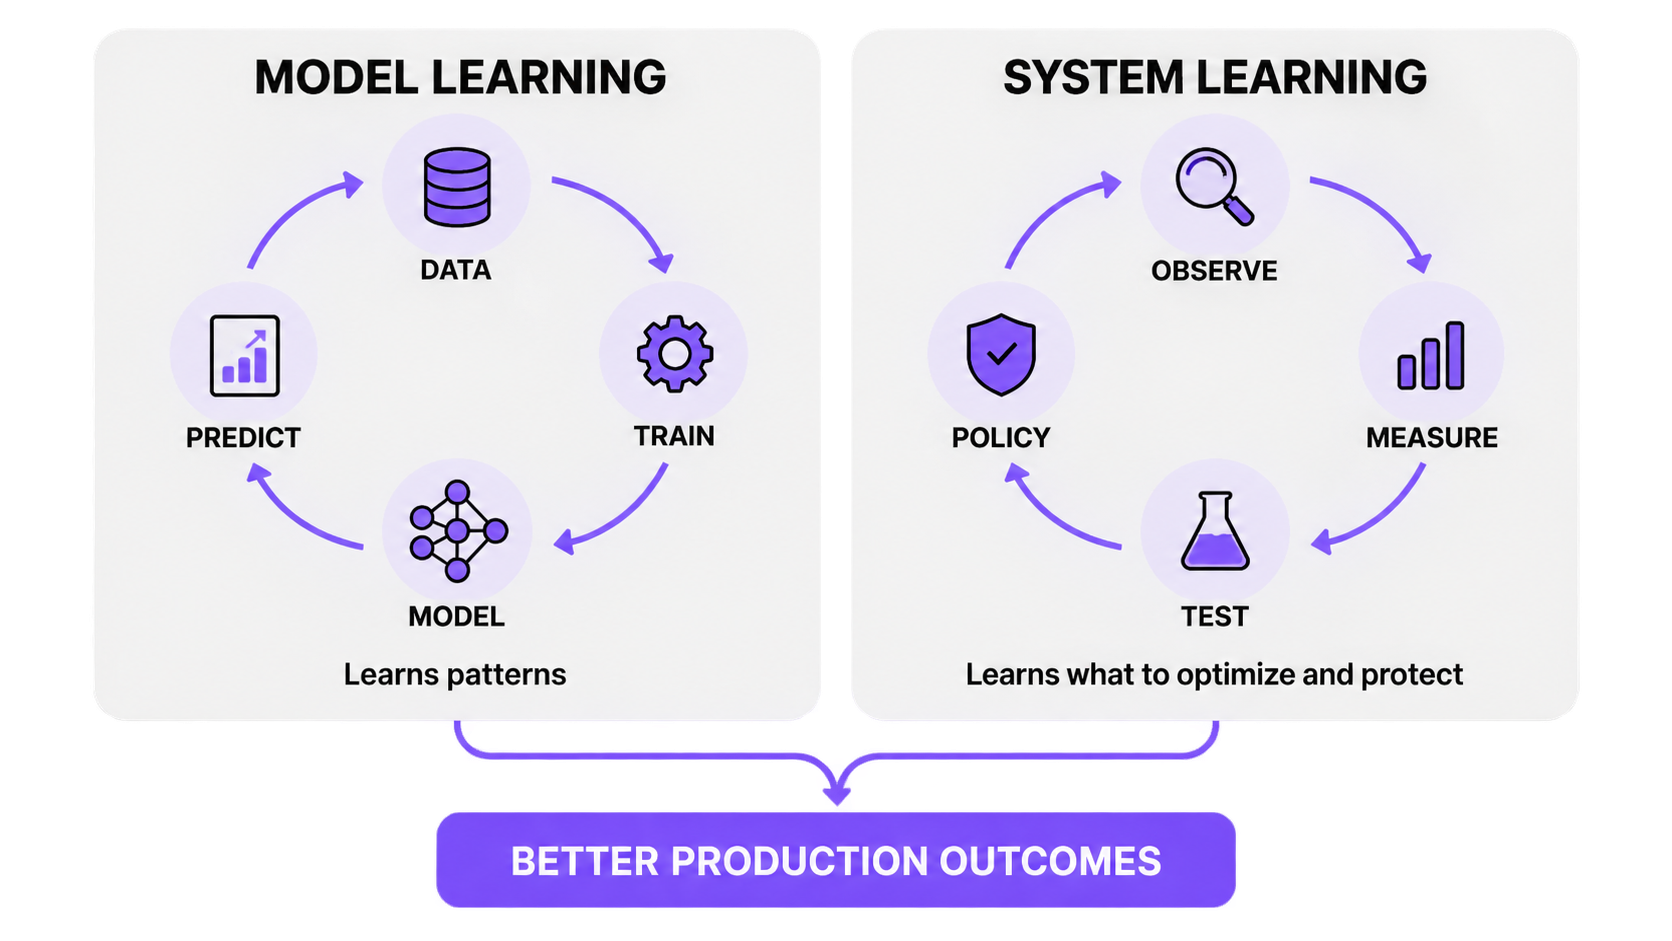
这篇文章通过一个真实的 AI 配音对齐案例,讨论这种系统层面的学习。系统没有重新训练模型,而是观察一个反复出现的问题,追踪造成问题的决策,验证一种更安全的处理方式,再把已经验证的结论变成后续任务可以遵守的规则。
对齐系统需要这种学习,是因为它同时面对多个目标,其中一些要求还是必须守住的质量底线。减少视频片段和轨道可以让处理更简单,但如果因此让配音与对应画面错位,这次改动仍然应该被拒绝。同样,如果画面更平滑的代价是语速变得难以理解,或者时间轴新增空隙与重叠,也不能接受。系统必须先满足这些底线,才能继续比较其他收益。
VMEG 会根据不同使用场景选择不同的对齐策略。不同策略关注的重点并不完全相同,因此系统不会用一套固定权重处理所有视频,而是先选择适合当前场景的策略,再按照这套策略的优先级寻找可接受的结果。
如果把所有目标合成一个加权总分,就等于假设每一种收益和损失都能换算成同一种单位,也要求同一组权重能够稳定适用于不同语言、视频类型、句子长度和使用场景。现实中,为一种场景调好的权重,可能会掩盖另一种场景里的严重问题:系统总分变高了,用户却看到声音落在了错误的画面上。
因此,VMEG 采用分层决策。系统先选择适合当前场景的对齐策略,再由安全检查保护声画时机、可理解的语速和有效的时间轴;只有通过这些检查的候选方案,才继续比较画面是否更平滑、处理是否更简单等次级收益。
这并不排斥评分模型。未来,无论是学习得到的模型还是人工设定的分数,都可以用来给多个已经安全的候选方案排序;但它不应该为了提高总分,而允许任何安全条件被牺牲。
AI 配音对齐为这种学习方式提供了一个具体案例。一个整理视频轨道的步骤让时间轴更简洁,却有时把声音从对应画面上移开。逐步观测暴露了这个冲突,历史数据、同输入视频回放和上线结果则帮助我们判断,应该把什么经验安全地写回系统。
为什么合理的优化也可能做错
对齐流程里有一个“视频片段合并”步骤。它会把相邻的视频区间合在一起,从而减少视频轨道,也可能让画面速度变化更平滑。这些都有价值,但不是最终目标。
时间轴更干净,观看体验仍可能更差。合并可能让译文声音过早或过晚,挤掉下一句需要的无对白时间,或者让某段画面被迫加速。如果只看轨道数量或最终文件,这类负优化很容易被漏掉。
局部优化只有在更重要的观看体验没有变差时,才值得被接受。
观测让系统拥有可以积累的记忆
最终视频只能告诉我们“结果不对”,却不能告诉我们“在哪一步开始不对”。因此,每个重要决策都记录四个时刻:
- 优化前:如果这一步什么都不做,系统会保留的结果。
- 候选方案:这一步建议使用的新时间轴。
- 对比结果:什么变好了、什么变差了,以及接受或拒绝的原因。
- 优化后:真正交给下一步继续处理的时间轴。
这样,一长串规则就变成了一条可以追踪的决策链。我们也不会因为某一步最后接触了输出,就误以为问题一定由它造成。
四类通俗的观测信号
| 观测类别 | 它回答的问题 | 在决策中的作用 |
|---|---|---|
| 最终观看体验 | 译文声音是否仍落在对应画面上?整句话是否离原本位置更远? | 不能变差 |
| 语音与时间轴安全 | 语速是否仍可接受?是否新增空隙、重叠或顺序错误? | 不能变差 |
| 局部收益 | 画面是否更平滑?视频结构是否更简单? | 至少要有一项真实收益 |
| 决策记录 | 哪一步改变了结果?为什么被接受或拒绝? | 让结果可以解释和复盘 |
前两类保护用户体验,第三类判断优化是否完成了自己的任务,第四类让我们能从线上结果中持续学习。
上线前的影子观测发现了什么
在不改变线上结果的前提下,我们观察了 2,035 条可能进入“视频片段合并”的记录。其中 924 条并没有真正让结构变简单,因此直接保留原结果即可。
剩余 1,111 个候选方案确实改变了结构。只有 456 个,也就是 41.0%,在获得局部收益的同时没有损害更重要的信号。另外 655 个,也就是 59.0%,至少让一项受保护体验变差。
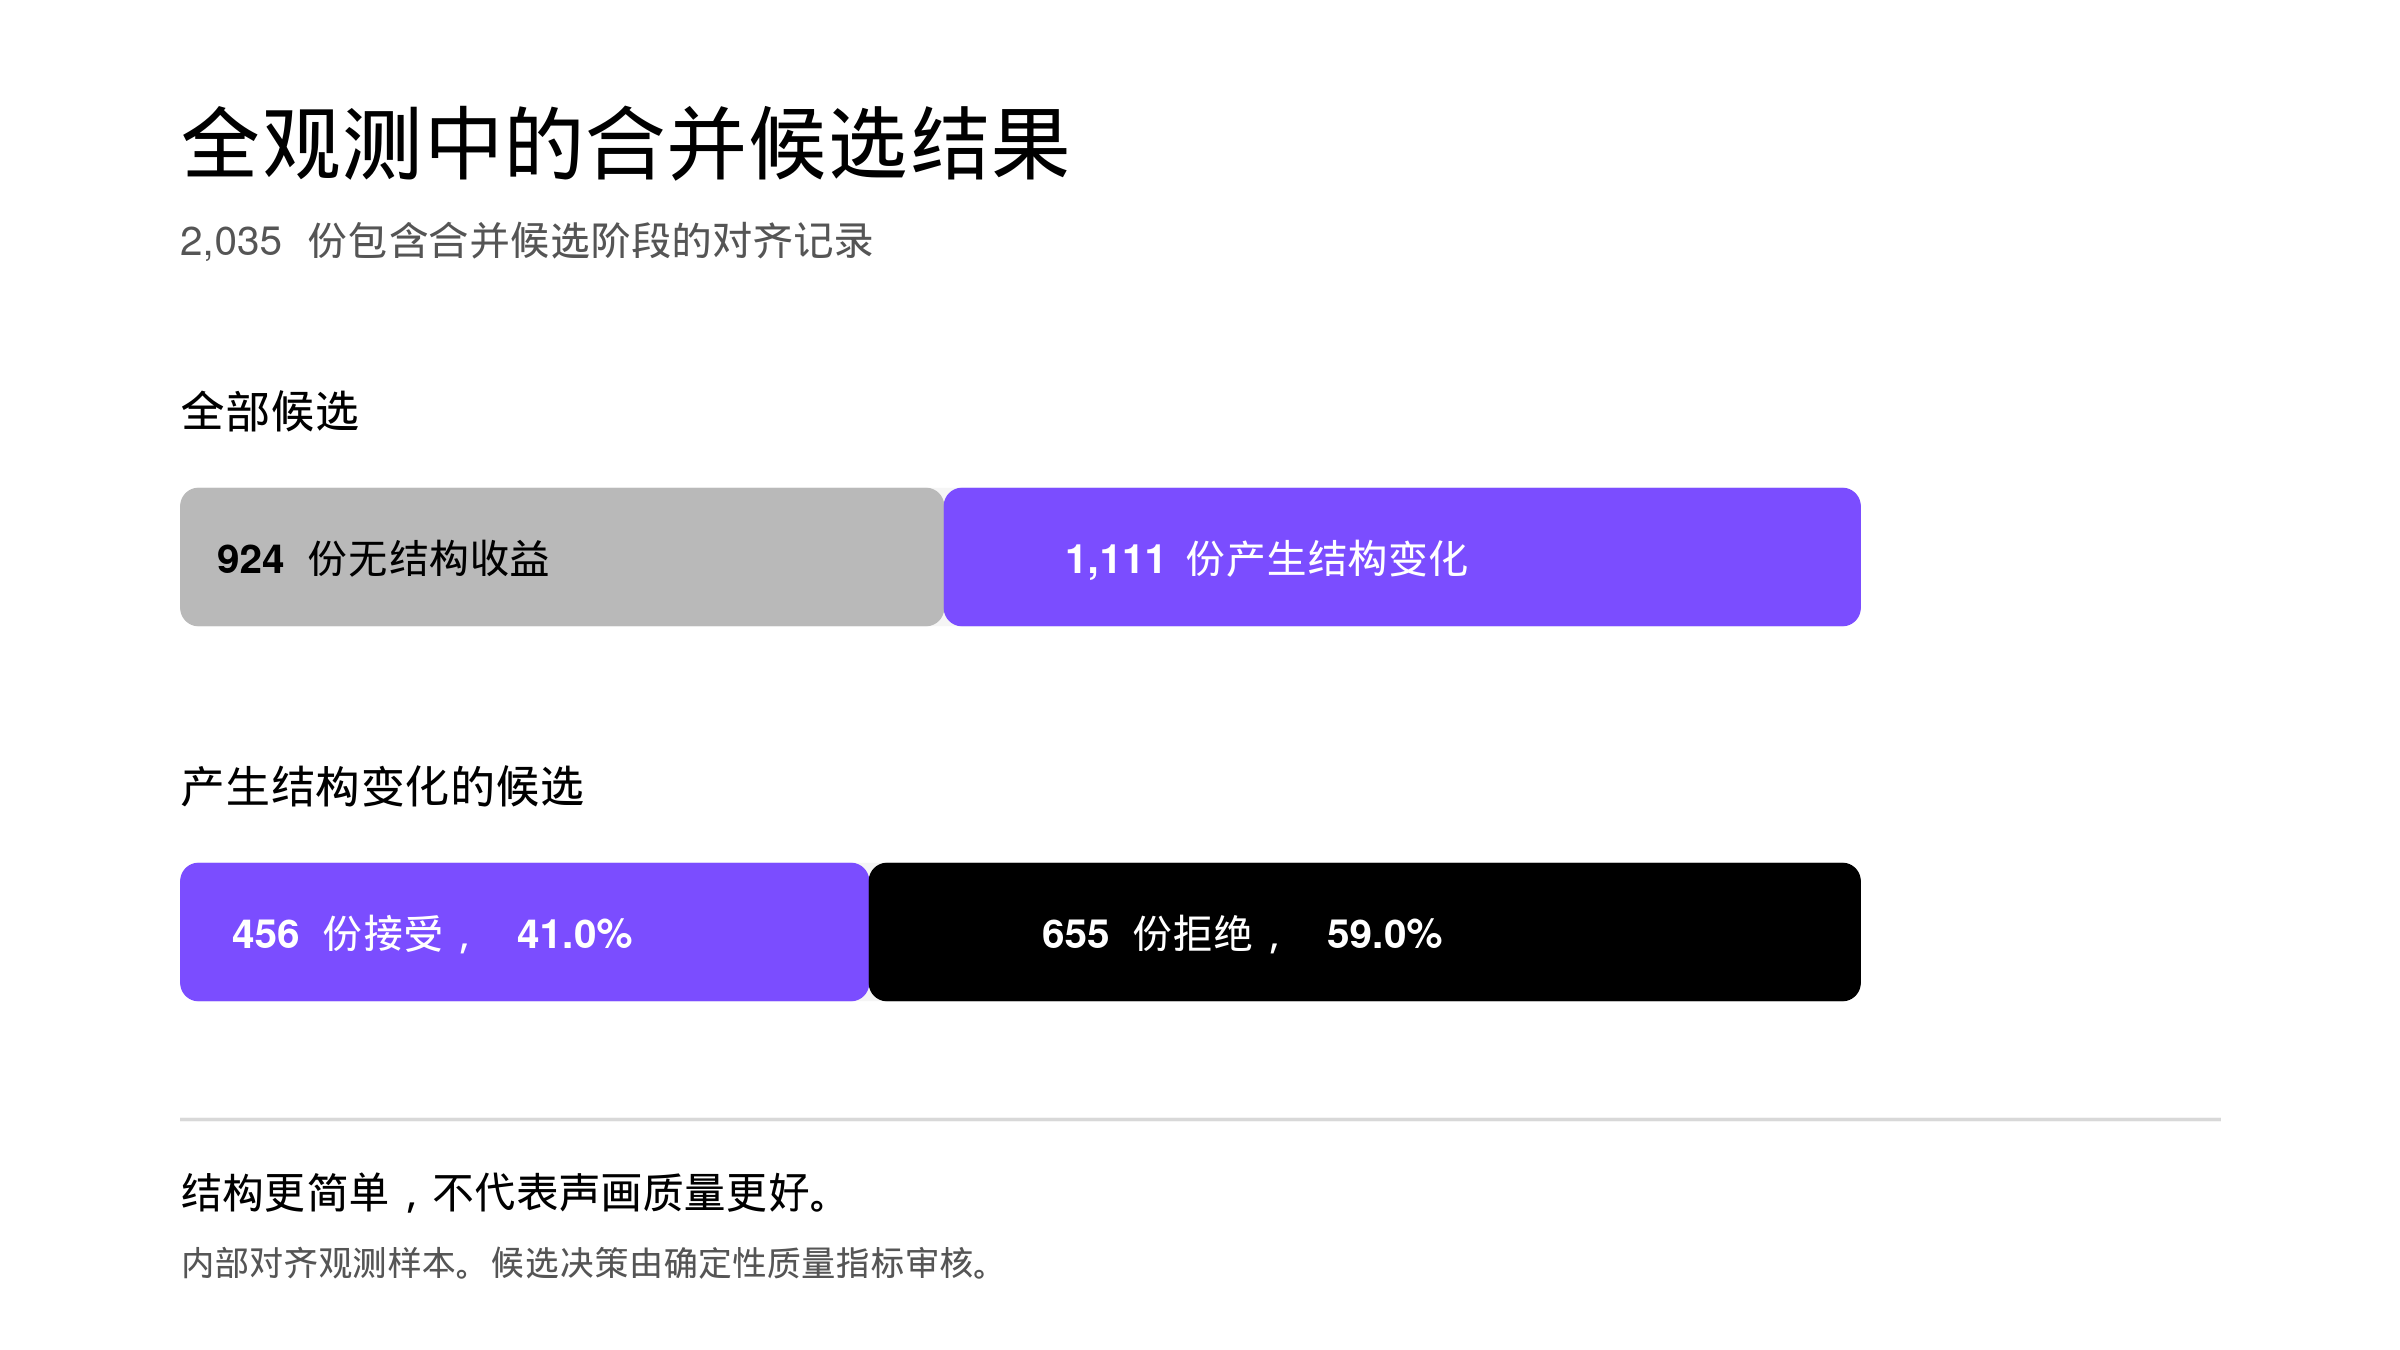
这个结果改变了我们对安全检查的理解:它不是用来处理极少数边缘情况,而是决定大多数真实时间轴改动能否生效的核心步骤。
第一个改动:让每次合并先证明自己值得被接受
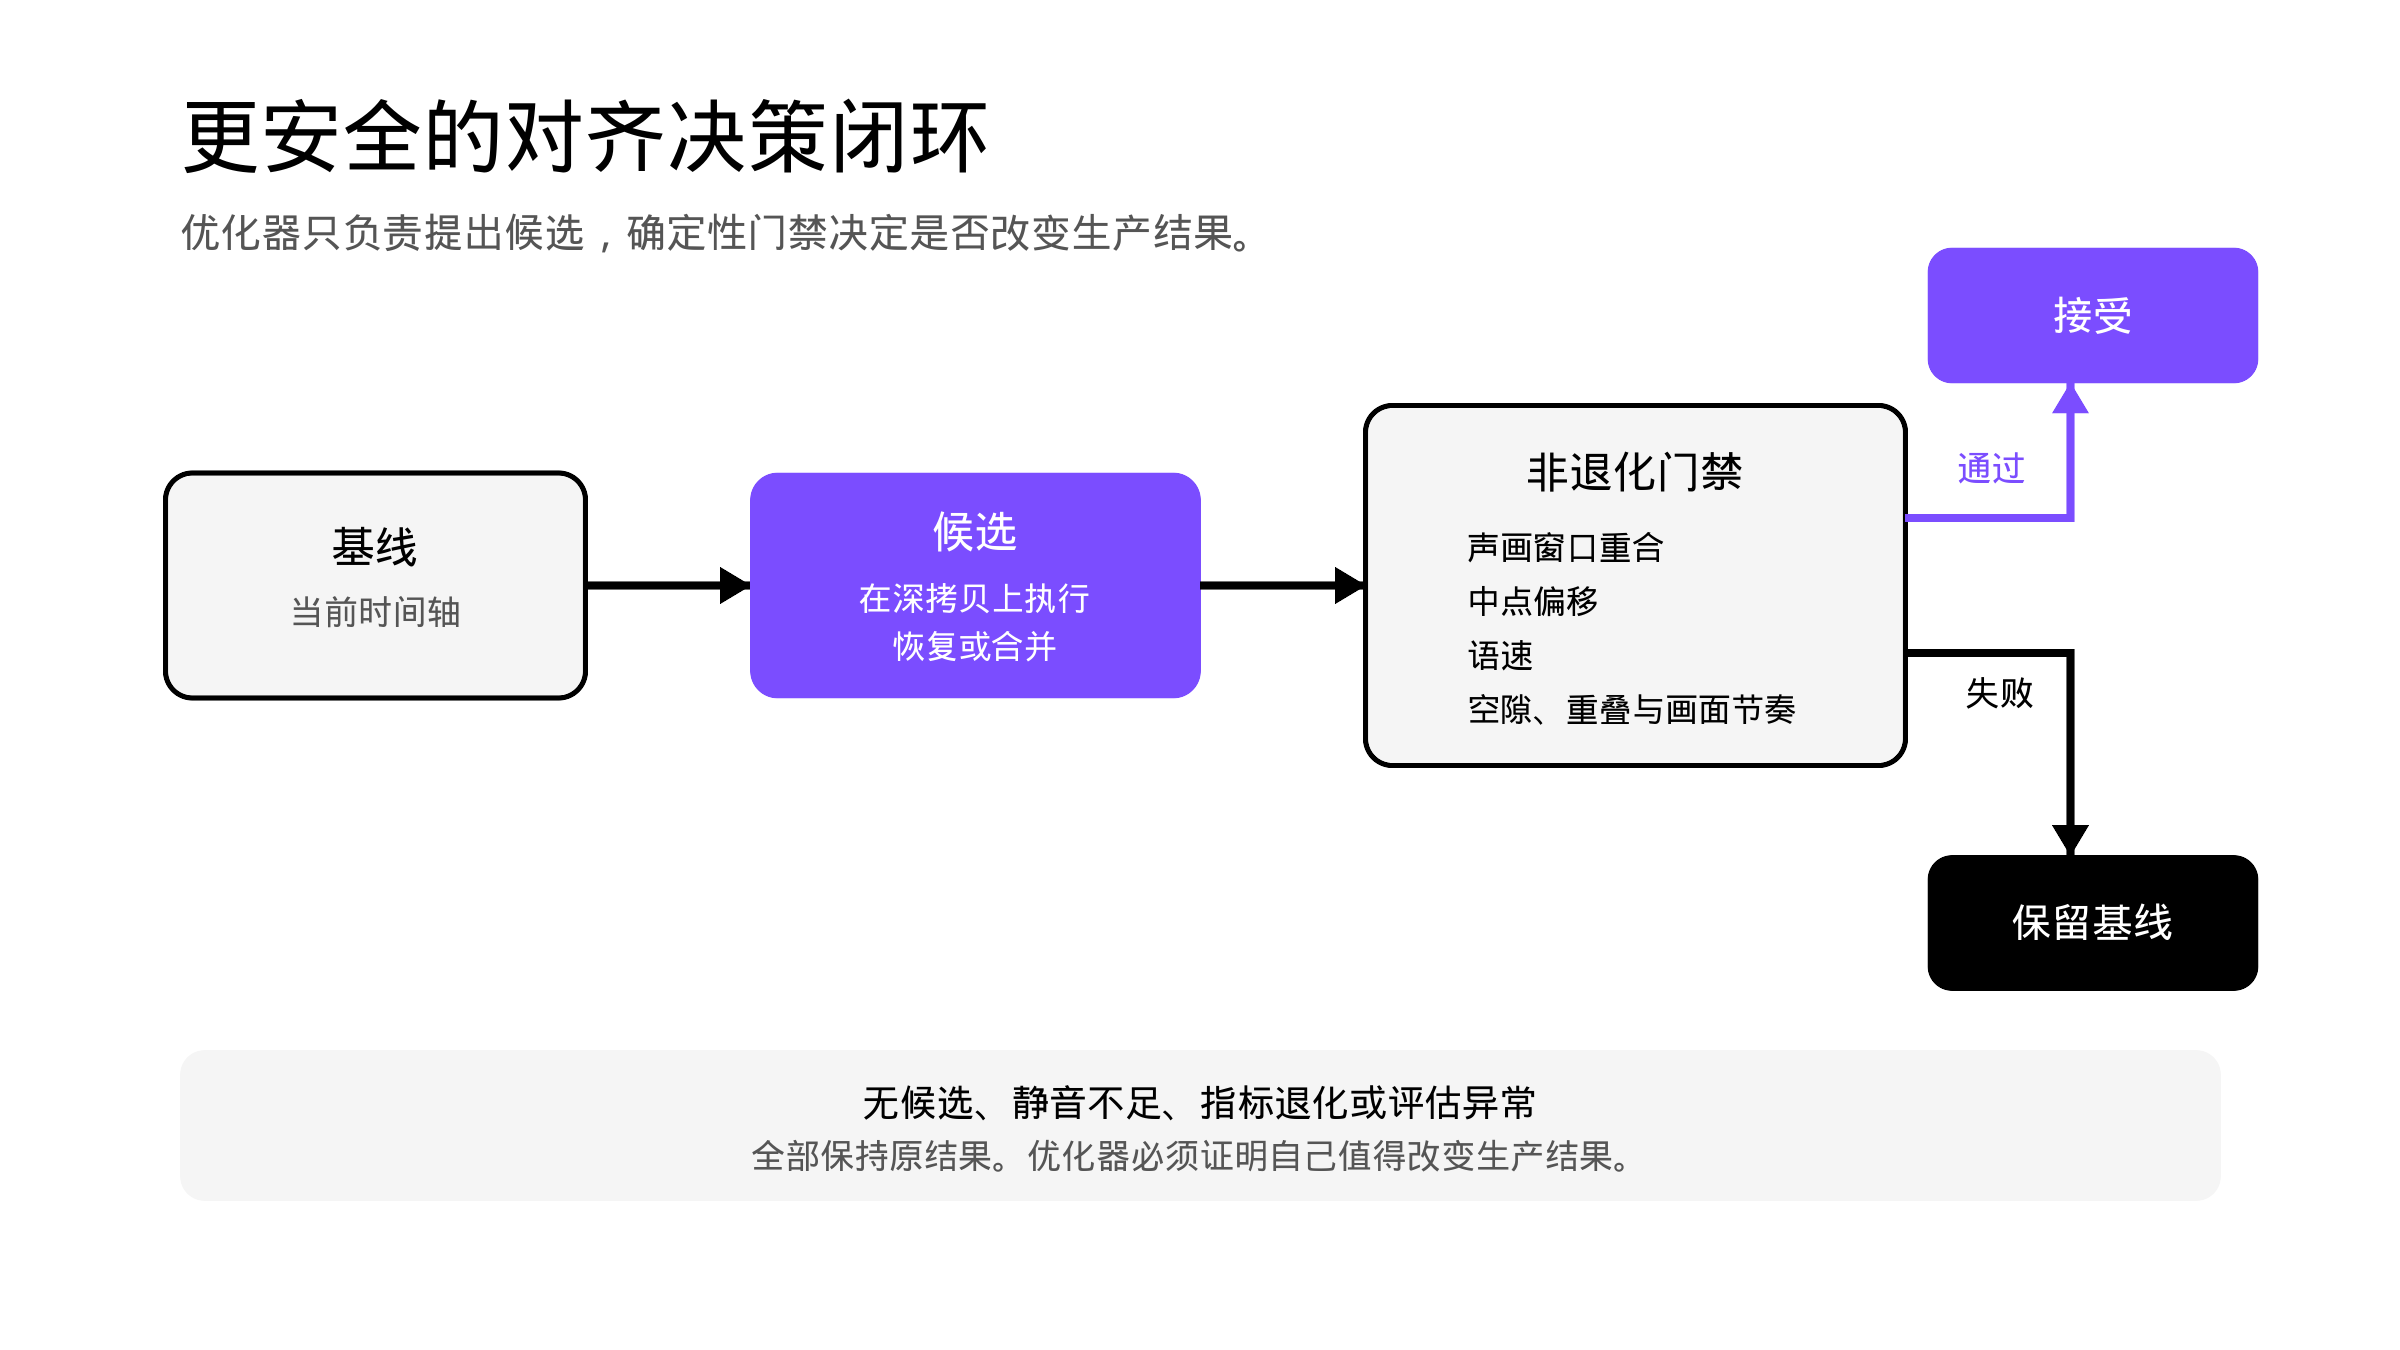
新规则很简单:先生成一个候选时间轴,不立即改动当前结果;再确认它确实带来轨道简化或画面更平滑;然后比较声音与画面的重合程度、整句时间偏移、说话速度、时间轴安全和画面速度。只有确实有收益,而且更重要的指标都没有变差,候选方案才会被采用。
如果对比过程无法完成,系统就保留当前结果。不确定性不能成为改动线上视频的通行证。
第二个改动:利用后方无对白时间,减少画面极端加速
安全检查可以阻止一个坏候选,却不能修复当前结果里已经存在的问题。在一个典型案例中,对齐方案把 7.7 秒源画面压进约 2.47 秒的成片区间,导致中间画面以 3.116 倍速度播放;但同一场景后方其实有一段较长的无对白时间。
为什么画面仍然需要一定加速?跨语言配音会产生时长差。这个案例是中文译越南语:目标句在源片中约占 1.2 秒,生成的越南语 TTS 文件约为 1.71 秒,因此适度调整时间轴是合理的。不过,3.116 倍的极端画面加速并不是语音时长必然造成的;它来自一个更具体的规划问题:前面的语音组已经结束分配,算法却还没有利用后方可用的无对白时间。
可以把这次修复简单理解为:后面有一段没有对白的画面,系统把其中一部分可用时间重新分配给了前面的画面。
修复前,前面的 7.7 秒画面在成片里只有约 2.47 秒,只能以 3.116 倍速度播放。修复后,它获得了约 6.16 秒,速度降到 1.25 倍。为了不打乱声画对应关系,后面的画面、译文声音和字幕一起向后移动。目标句自己的画面速度始终是 1.034 倍,没有变化;TTS 文件、说话速度、背景音和成片总长度也都没有变化。
另一项 merge 安全检查负责保护恢复后的声画时机。它拒绝了一个会让目标声音再次偏离对应画面的时间轴简化方案。与旧版未设门禁的最终结果相比,最终采纳结果把声音与对应画面的重合度从 0 提升到 0.677,整句话中心偏差从 2.756 秒降到 0.253 秒;说话速度保持不变。
下面的视频展示两项改动共同生效后的结果,不是其中任何一项的单独效果。
听测顺序:源片原声 → 上一个版本译片 → 修复后译片。每一段都包含前一句、目标句和后一句。
这项恢复非常克制。如果后方无对白时间不足以完成整个修正,就不做任何移动。方向看起来正确,并不足以接受一个只完成一半的方案。
为什么两个改动必须一起工作
- 安全检查保护当前结果。它阻止时间轴整理用更差的声画时机换取更简单的结构。
- 无对白时间恢复在证据充分时改善当前结果。它不改变声音,却能减少不必要的画面加速。
只做安全检查,某些原本就过快的画面仍然得不到修复;只做时间恢复,后续的合并步骤又可能撤销改善。两者结合后的顺序很清楚:提出恢复方案、检查恢复、形成新的当前结果、提出合并方案、检查合并,最后再完成整条时间轴检查。
上线后发生了什么
随后,我们回收了 2026 年 9 月 17 日 09:13 UTC 至 9 月 18 日 04:18 UTC 的线上记录。样本包含 1,389 个任务、2,634 条观测记录。其中 2,548 条完整走过对齐流程,86 条因为只有字幕而跳过,观测过程没有出现失败。
“视频片段合并”共提出 2,401 个候选方案,接受 268 个,拒绝 2,133 个。被拒绝的方案中,有 1,024 个会让至少一项更重要的质量信号变差。被接受的 268 个方案里,声音与画面的重合、整句时间位置、说话速度和时间轴安全都没有变差。
“无对白时间恢复”共触发 33 次,接受 29 次。29 个被接受的案例里,最高画面播放速度全部下降,典型降幅为 0.359 倍速;28 个案例的声画时机改善,1 个保持不变;所有案例的说话速度都没有变化。
这些线上结果已经给出了明确结论:安全检查能够稳定拦住有害改动,“无对白时间恢复”则在适用案例中减少极端画面加速,而且没有改变音频。对上线任务的实际查看进一步确认,这种改善既反映在指标里,也能在播放中直接感知。
如何确认数字变化真的能被人感知
视频听测采用连续窗口,保留前一句、目标句、后一句和背景轨。上一个版本与修复版使用完全相同的译文音频和背景声音,唯一改变的是视频对齐时间轴;同时加入源片片段,方便判断原声本来对应哪一段画面。
这种设计隔离了对齐改动本身的影响。在音色、文案、语速和配乐完全相同的条件下,修复版让译文声音更稳定地落在对应画面上,也明显减少了极端画面加速。线上任务抽查呈现出相同趋势。结合受控回放和线上检查,可以确认这次改动带来了明显、可感知的声画一致性提升。
生产算法的持续学习闭环
在这种学习中,新知识不一定要变成模型参数。它也可以成为更清楚的观测指标、必须守住的质量底线、候选方案的接受规则、可重复的视频回放方法,或者更安全的上线决策。整个过程可以不断重复:
- 观测每个重要步骤,而不只看最终输出。
- 把必须保护的观看体验与次要工程收益分开。
- 先生成候选方案,不立即改动线上结果。
- 只有候选确实有收益,而且受保护信号都不变差,才接受它。
- 用完全相同的音频对比新旧画面时机,确认指标改善可以被人感知。
- 用线上数据继续判断这种改善在整体任务中有多常见。
结论
这次最重要的结果不只是一项对齐修复。系统从线上证据中学到了一条可以重复使用的原则:局部工程收益只有在更重要的观看体验没有变差时,才值得被接受。
这条经验最终进入了观测指标、安全检查、视频回放方法和上线流程。模型本身没有改变,但整套算法系统更清楚什么值得优化、什么必须保护。这就是系统层面的持续学习:持续观察、解释原因、验证方案、沉淀结论,再继续测量下一次结果。
参考文献
- D. Sculley 等,《Hidden Technical Debt in Machine Learning Systems》,NeurIPS 2015。
- Saleema Amershi 等,《Software Engineering for Machine Learning: A Case Study》,ICSE 2019。
- Rob Ewaschuk,《Monitoring Distributed Systems》,Google Site Reliability Engineering。
- Aleksander Fabijan 等,《Safe Velocity: A Practical Guide to Software Deployment at Scale Using Controlled Rollout》,ICSE 2019。