为什么 WER、BLEU、MOS 和唇形同步评分还不够
AI 配音已经从研究演示快速发展为生产系统。如今,只需几分钟就能完成视频翻译、配音和唇形同步。
但这也带来了一个不那么直观的问题:
我们如何判断结果是否真的足够好?
人们很容易想到用已有指标评估配音系统:
- 用 WER 评估语音识别
- 用 BLEU 或 COMET 评估翻译
- 用 MOS 评估语音质量
- 用说话人相似度评估声音克隆
- 用 SyncNet 评分评估唇形同步
这些指标都很有用。
但单独使用其中任何一项,都无法判断观众是否会觉得配音视频真实可信。
原因很简单:
AI 配音不是一项单一任务,而是对表演的重建。
成功的配音既要保留含义、身份、时序、情绪、表达方式和视听一致性,又要用另一种语言生成自然的语音。
而这些目标之间可能相互冲突。
译文可能非常准确,却因为太长而无法适配画面。
声音可能与原说话人高度相似,但说出句子时情绪不对。
视频的唇形同步可能非常出色,语音听起来却极不自然。
一段 60 分钟的视频可能各项平均分都很高,却包含两个观众马上就能发现的严重错误。
因此,正确的问题或许不是:
“这段配音的质量分数是多少?”
而应该是:
“对于这段特定视频,哪些质量维度最重要?我们又能多可靠地衡量每个维度?”
不存在单一的配音质量分数
来看下面这个简短场景:
原文:
“你做了什么?!”
假设翻译后的版本是:
“你做了什么?”
译文可能完全正确。
克隆声音与说话人的相似度可能达到 0.90。
音频的信号质量可能非常出色。
唇形同步模型也可能给出很高的同步评分。
但如果生成的声音语气平静,没有表现出难以置信的喊叫,这段配音听起来仍然不对。
再看另一个例子:
原文:
“真不敢相信你居然做到了。”
译文很好,情绪准确,说话人的声音也对,但生成语音持续 2.8 秒,而原镜头只给说话人留了 1.9 秒。
结果可能会与下一位说话人的语音重叠。
同样,各个独立环节看起来都不错,视频层面的结果却失败了。
这正是配音质量天然具有多维属性的原因。
可以用下面这个概念模型来理解:
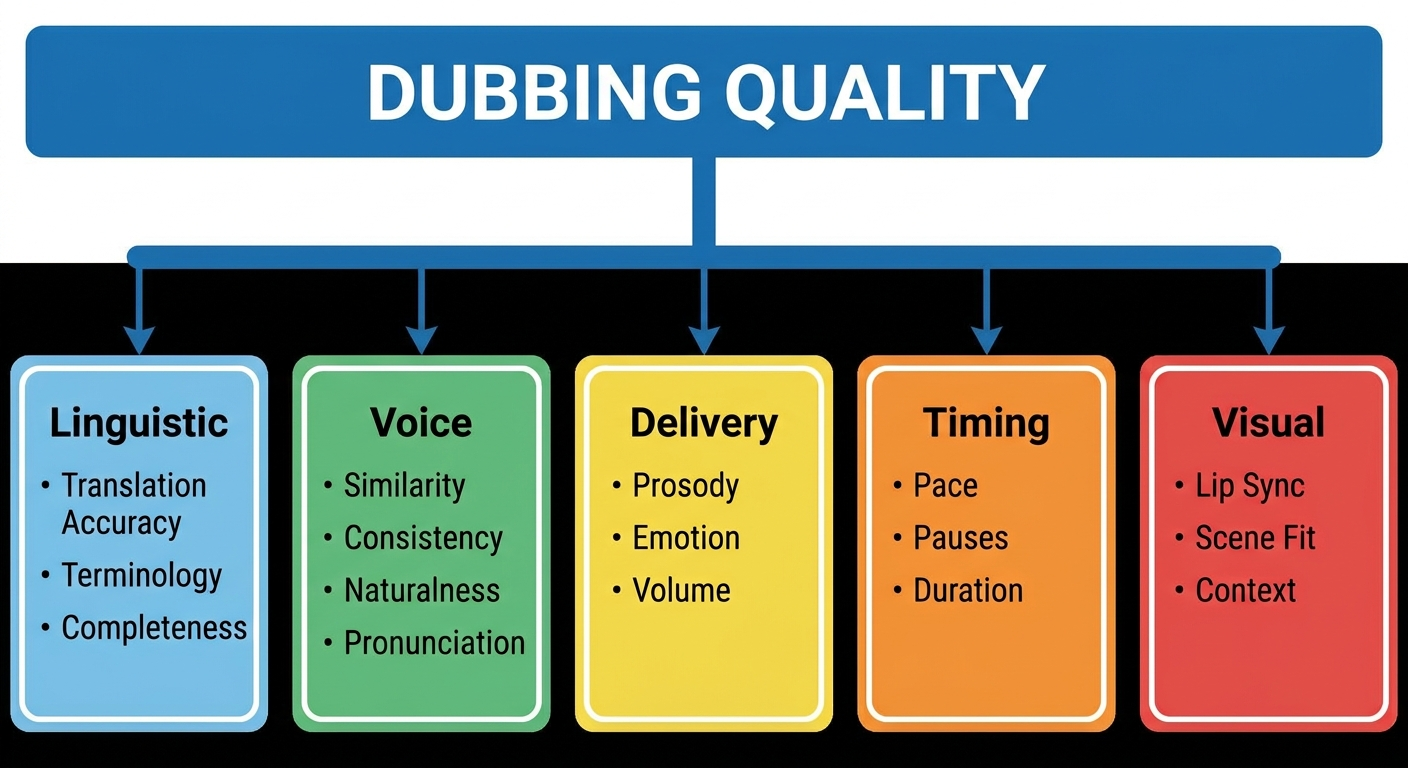
在这些维度之上,还有另一个维度:
整段视频的一致性。
我们究竟应该衡量什么?
我会把评估问题大致划分为七个维度。
| 维度 | 我们想知道什么 | 衡量方式示例 |
|---|---|---|
| 翻译 | 是否保留了原意? | COMET、人工评估、术语准确率 |
| 声音 | 说话人听起来是否仍像本人? | 说话人嵌入相似度、人工偏好 |
| 自然度 | 语音听起来是否像真人? | MOS、神经网络语音质量指标 |
| 表演 | 表达方式是否正确? | 韵律、情绪、音高、节奏、停顿 |
| 时序 | 是否适配原始表演? | 时长比、语音重叠、停顿对齐 |
| 视觉 | 是否适配视频画面? | 唇形同步/视听同步指标 |
| 一致性 | 整段视频是否连贯一致? | 说话人、术语、声音、风格和叙事一致性 |
这已经更接近人类实际评价配音内容的方式。
有意思的是,这不只是工程经验。
一项针对专业人工配音的大规模研究分析了 319.57 小时的视频、674 集节目、54 部作品和 9,215 名说话人。研究发现,声音自然度和翻译质量尤为重要;同时还表明,除了台词本身,源音频中的重音和情绪等特征也会影响人工配音。
换句话说:
专业配音本身就是多维的。
为什么要用不同的方式评估 AI 配音?
翻译准确是必要条件,但还不够
最直观的指标是语言质量。
我们可以检查:
- 含义是否正确?
- 名称是否正确?
- 数字是否正确?
- 技术术语是否正确?
- 是否有内容缺失?
- 译文在目标语言中是否自然?
- 文化相关内容是否处理得当?
- 整段视频中的术语是否一致?
BLEU 等传统机器翻译指标可用于基准测试,COMET 等较新的指标则尝试提高与人工翻译评价的相关性。
但即使翻译指标无可挑剔,也无法判断一句话作为口语对白是否成立。
例如:
“你在开玩笑吗?”
根据上下文不同,这句话可能有几十种合理译法。
即使文本翻译得再好,也无法告诉我们演员应该表现出哪种语气:
- 愤怒,
- 觉得好笑,
- 震惊,
- 讽刺,
- 失望,
- 还是真的感到困惑。
2024 年一项关于端到端语音到语音配音翻译评估的讨论提出了基本相同的观点:以文本为中心的传统指标无法反映自然度、目标声音相似度、口音和节奏等重要属性。
因此:
翻译质量衡量说了什么,配音质量还必须衡量是怎么说的。
说话人相似度:角色听起来还是同一个人吗?
声音克隆又引入了一个维度。
对于每位说话人,我们都可以提出一个问题:
生成声音是否保留了原说话人的身份特征?
说话人嵌入可以提供一种有用的自动化信号。
例如:
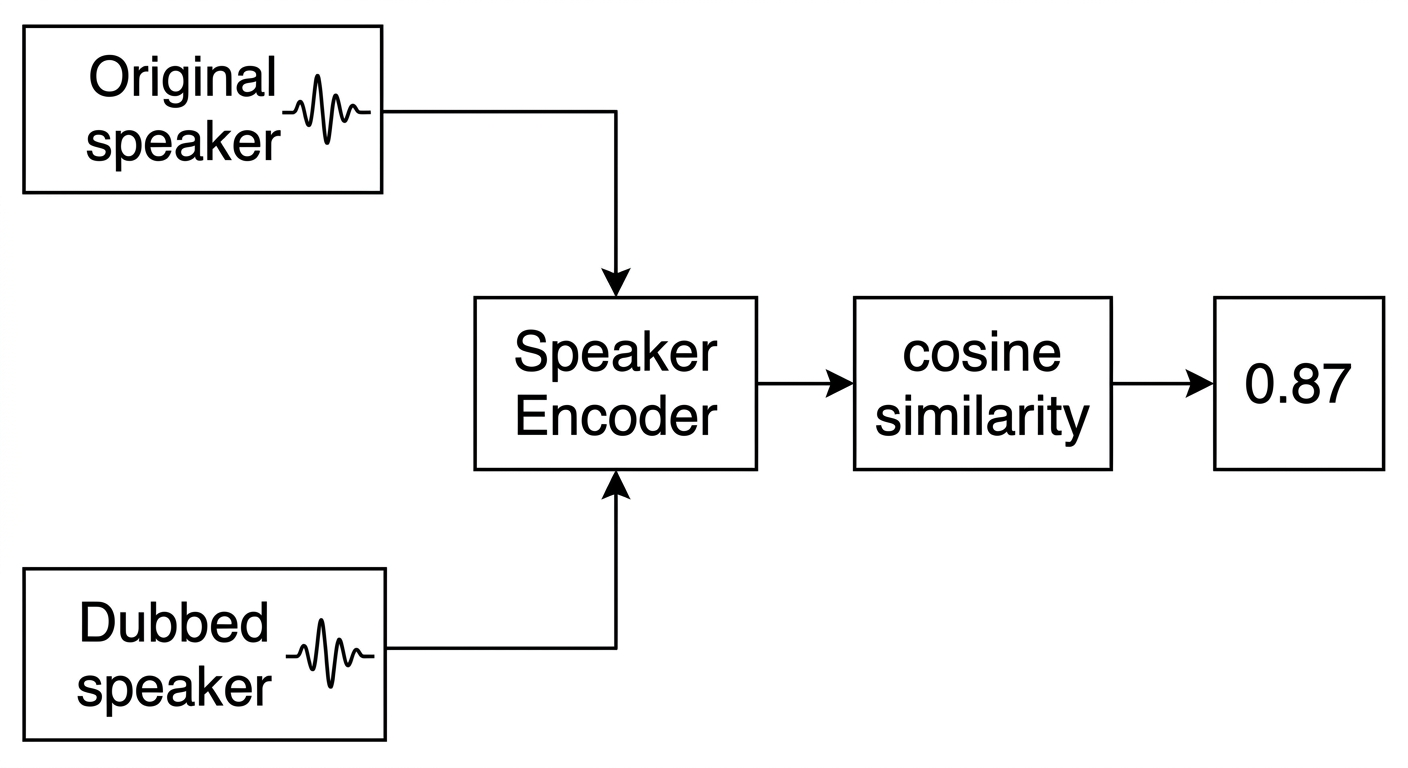
但说话人相似度存在一个重要局限。
相似不等于一致。
假设有一部由一名旁白讲述的 30 分钟纪录片。
生成声音的相似度可能如下:
Segment 1    similarity = 0.91
Segment 2    similarity = 0.89
Segment 3    similarity = 0.92
...
Segment 57   similarity = 0.90
Segment 58   similarity = 0.64
平均值可能仍然非常漂亮。
但第 58 个片段听起来可能完全像另一个人。
因此,我们需要区分:
说话人相似度
这段生成声音与原说话人是否相似?
以及:
说话人一致性
在整段视频中,这段生成声音是否始终能被识别为同一位说话人?
对于长视频内容,这一区别尤其重要。
近期研究还表明,即使是复杂的音频语言模型,也无法可靠地判断这个问题。ACL 2026 的一项基准测试 SpeakerSleuth 在四个数据集和 12 个大型音频语言模型上评估了 1,818 个经人工验证的样本。这些模型难以可靠地发现声音层面的说话人不一致;加入文本上下文后,表现甚至可能大幅下降,因为模型往往优先考虑文本连贯性,而忽略声音证据。
这个结果很值得关注。
它意味着:
即使一个 AI 模型能够理解对话内容,也未必能可靠判断声音是否真的一致。
自然度不只是“声音好不好听”
传统语音合成评估通常使用 MOS,即平均意见分。
由人类听众收听生成语音并为其质量打分。
例如:
1 ── Very poor
2 ── Poor
3 ── Fair
4 ── Good
5 ── Excellent
MOS 仍然很有价值,因为归根结底,受众是人。
但它有一个根本局限:
听众可能给声音自然度打出 4.5/5,同时只给整体配音打 2/5。
为什么?
因为自然度只是其中一个组成部分。
一段合成效果出色的声音仍然可能:
- 使用了错误的情绪,
- 语速过快,
- 停顿位置不对,
- 听起来像错误的角色,
- 与下一位说话人的语音重叠,
- 与视频画面矛盾,
- 或念错角色的名字。
由此可以得出一条重要原则:
语音质量和配音质量是两个不同的评估问题。
韵律:连接文字与声音的缺失层
这是本文需要重点强调的维度之一。
韵律包括:
- 音高
- 重音
- 节奏
- 语调
- 强调
- 停顿
- 措辞分句
- 语速
例如:
“你真的那么做了。”
文字完全相同。
但是:
YOU really did that?听起来不同于:
You REALLY did that?而后者又不同于:
You really did THAT?文本没有变化。
表演却完全不同。
自动配音研究已经明确指出,要让翻译语音在原视频语境中听起来自然,时长、唇部动作、手势、音色、情绪、韵律和环境特征都是需要考虑的属性。
因此,一套实用的评估框架不仅要衡量说了什么,还要衡量如何表达。
说话速度应该作为独立指标
说话速度值得从一般时序问题中单独拆分出来。
假设原说话人说:
"I don't think this is going to work."语速为每秒 3.8 个单词。
翻译后的版本可能以如下语速生成:
2.4 words/second或者:
5.1 words/second两者都可能有问题。
我们可以衡量:
语速比
其中,P 可以是每秒单词数、每秒音节数或每秒音素数。
但这仍然不够。
好的配音并不一定要使用完全相同的语速。
不同语言的信息密度和语音结构并不相同。
真正的目标更接近:
目标语言中的表演能否自然还原原始表演,同时适配可用时长?
对于说话速度特征差异很大的语言,这一区别尤为重要。
近期针对时长感知型多语言配音的研究说明了这个问题有多重要:EMNLP 2025 的一个系统通过显式约束翻译时长,在保持 COMET 翻译评分具备竞争力的同时,与没有显式长度约束的翻译相比,语音重叠相对改善最高达到 24%。
这个结果很重要,因为它说明了一个基本事实:
翻译质量与时序质量相互关联,但两者不是同一个目标。
情绪:句子即使正确,表达仍可能出错
情绪尤其难以自动评估。
我们可以把原始语音分类为:
Anger:       0.82
Sadness:     0.03
Joy:         0.05
Neutral:     0.10
然后与生成的表演进行比较。
但情绪不只是一个分类标签。
人类演员会通过以下方式表达情绪:
- 音高
- 响度
- 语速
- 停顿
- 音质
- 重音
- 发音方式
- 呼吸
- 时序
因此,即使系统能够预测:
“这是一个愤怒的句子”
它仍然需要解决一个难得多的问题:
“这位特定说话人应该如何用目标语言表现愤怒?”
这正是配音更接近表演重建而非普通语音合成的原因之一。
音量与音频连续性比想象中更重要
还有一些看似普通的维度,一旦出错就会格外明显。
例如:
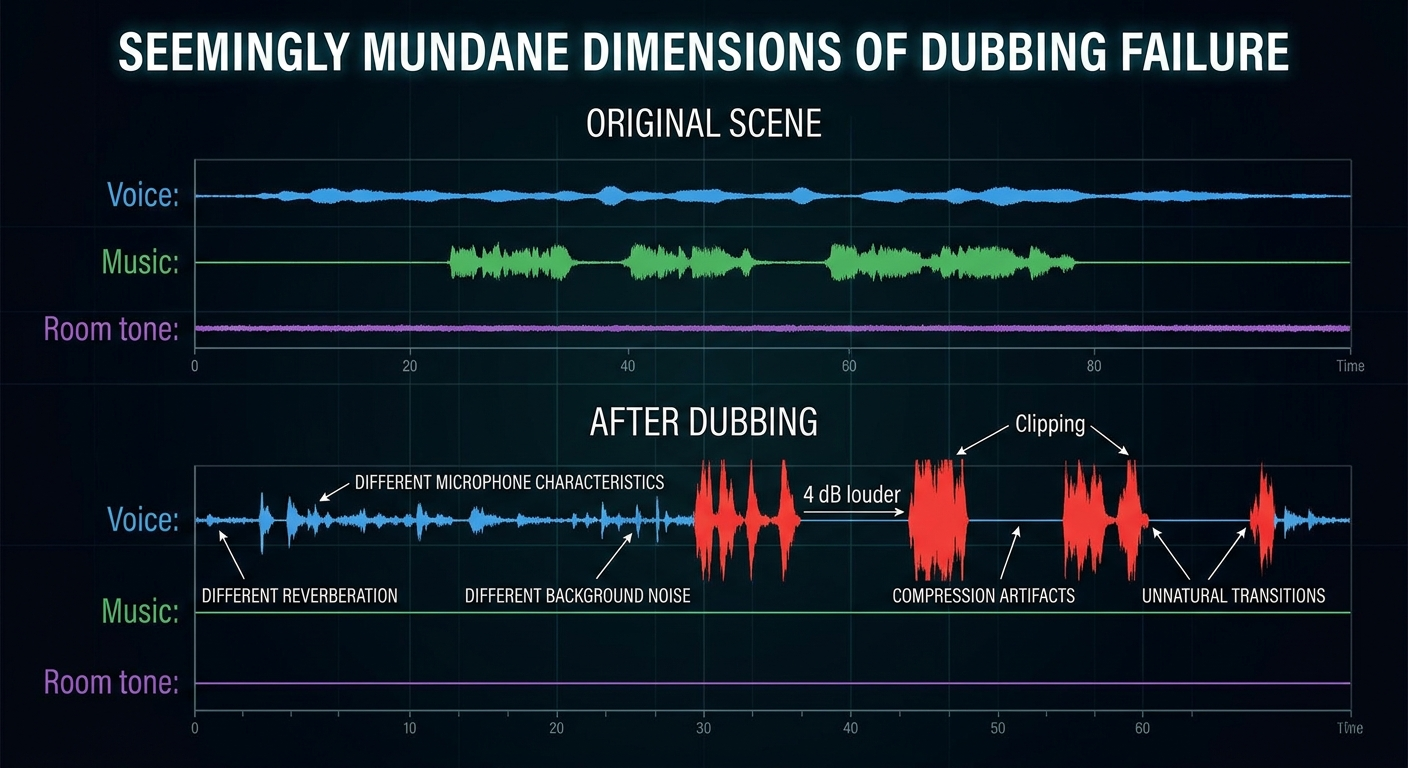
生成声音可能突然比前后对白高出 4 dB。
也可能存在:
- 不同的混响,
- 不同的麦克风特征,
- 不同的背景噪声,
- 削波失真,
- 压缩伪影,
- 不自然的过渡。
翻译指标或说话人相似度指标可能发现不了这些错误。
但它们会让观众立刻觉得视频不自然。
2026 年有关人工与 AI 配音评估的研究还将声音设计与同步、声音一致性与表现力、叙事连贯性和翻译并列,认为这些领域仍然需要人工判断。
唇形同步很重要,但唇形同步不等于配音质量
唇形同步可能是 AI 配音中最直观的指标。
SyncNet 等系统可以提供以下自动化衡量结果:
- LSE-D——唇形同步误差距离
- LSE-C——唇形同步置信度
通常,LSE-D 越低、LSE-C 越高,说明视听同步效果越好。这些指标广泛用于说话人头像和唇形同步研究。
它们非常有用。
但请比较下面两个版本:
版本 A
Translation:       95%
Voice similarity:  92%
Naturalness:       91%
Emotion:           88%
Lip sync:          70%
版本 B
Translation:       95%
Voice similarity:  65%
Naturalness:       62%
Emotion:           40%
Lip sync:          98%
哪个版本更好?
答案并不明显。
对于特写的戏剧场景,版本 A 可能更有真实感。
对于说话人的嘴部始终清晰可见的 YouTube 口播视频,唇形同步则可能需要更高的权重。
这说明了一条重要原则:
指标衡量的是某项属性,却不能决定这项属性有多重要。
视频类别会改变“高质量”的定义
在这一点上,评估框架会变得格外值得探讨。
并非所有视频都需要相同的质量侧重点。
| 教程 | 播客 | 剧情 | 喜剧 | 音乐 | |
|---|---|---|---|---|---|
| 翻译 | ●●● | ●●● | ●●● | ●●● | ●● |
| 说话人 | ●● | ●●● | ●●● | ●●● | ●●● |
| 情绪 | ● | ●● | ●●● | ●●● | ●●● |
| 语速 | ●●● | ●● | ●●● | ●●● | ●●● |
| 唇形同步 | ● | — | ●●● | ●● | ●● |
| 节奏 | ● | ● | ●● | ●●● | ●●● |
一个非常擅长处理教程的配音系统,未必适合歌曲。
同样,针对电影优化的系统可能会把计算资源浪费在播客的唇形同步上,而播客中可能根本看不到说话人。
因此,我想引入视频类别可行性画像这一概念。
不要只问:
“这个系统能给视频配音吗?”
而应该问:
“对于哪些类别的视频,这个系统能够稳定产出可接受的结果?”
最严重的错误不一定最常出现
这是实际生产中的另一条重要经验。
假设一段 60 分钟的视频包含:
- 20 处轻微发音问题
- 10 处略显不自然的停顿
- 5 处较小的时序偏差
- 1 处说话人分配错误
- 1 处产品名称翻译完全错误
简单的平均指标可能会得出结论:
98.5% 的内容质量良好。
但如果错误的产品名称出现在最重要的场景中呢?
观众感受到的质量可能远低于 98.5%。
这说明生产系统需要考虑严重程度的评估机制。
例如:
| 错误 | 频率 | 严重程度 | 操作 | 喜剧 | 音乐 |
|---|---|---|---|---|---|
| 轻微发音偏差 | 高 | 低 | 通过 | ●●● | ●● |
| 轻微语速不匹配 | 中 | 低 | 通过 | ●●● | ●●● |
| 不自然的停顿 | 中 | 中 | 通过 | ●●● | ●●● |
| 术语错误 | 低 | 高 | 复核 | ●●● | ●●● |
| 说话人错误 | 低 | 极高 | 通过 | ●● | ●● |
| 对白缺失 | 低 | 极高 | 复核 | ●●● | ●●● |
| 关键场景情绪错误 | 低 | 高 | 复核 | ||
| 严重的唇形同步失败 | 低 | 高 | 通过 | ||
| 时序 | 89 | 高 | 通过 | ||
| 音量 | 97 | 高 | 通过 | ||
| 唇形同步 | 91 | 高 | 通过 | ||
| 音频质量 | 95 | 高 | 通过 |
因此,可以用下面这个概念模型来理解:
更合理的是:
因此,生产质量检查不能只计算一个平均分。
片段级质量与视频级质量
这又引出了另一个区别。
生产系统应该按多个粒度进行评估。
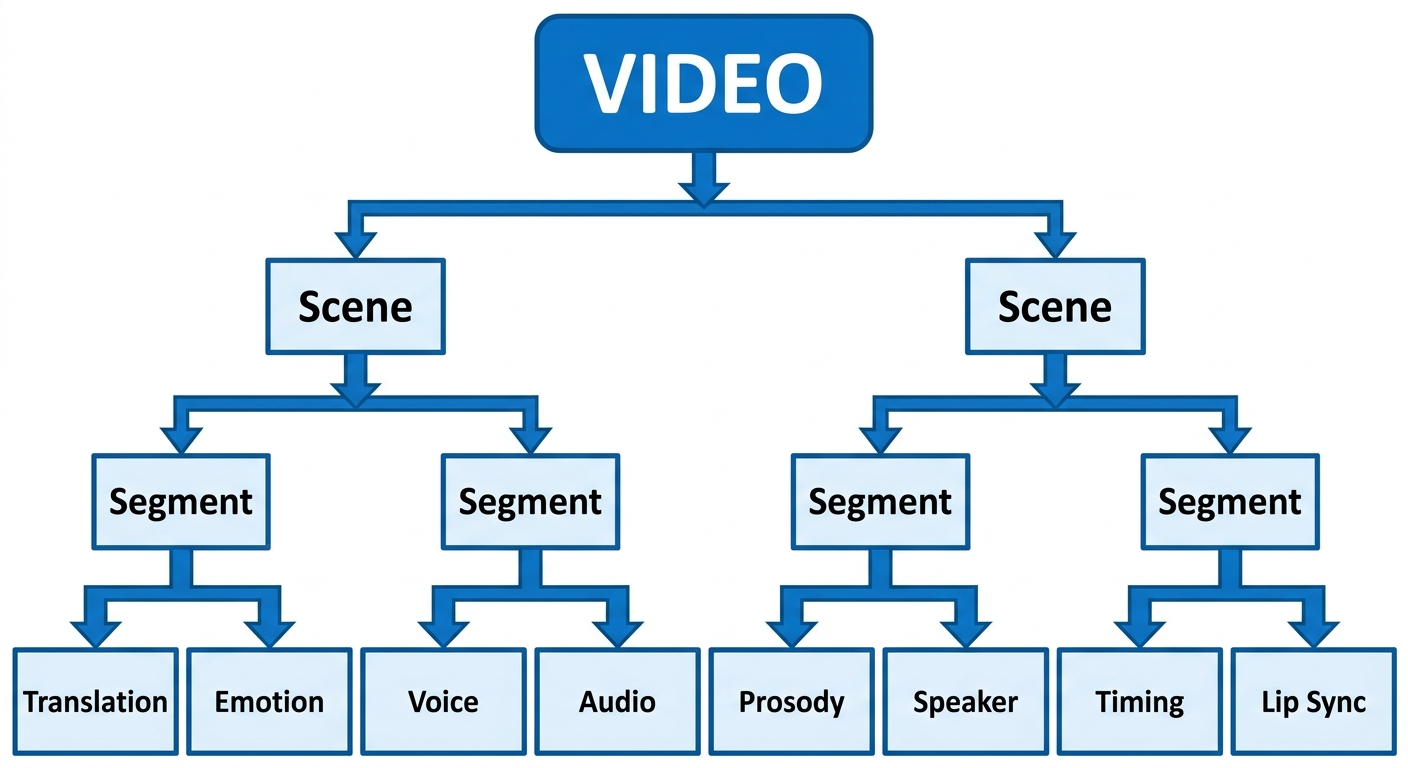
片段级质量检查
可以告诉我们:
“第 183 个片段的说话人不匹配。”
场景级质量检查
可以告诉我们:
“这三个镜头之间的情绪基调变化不自然。”
视频级质量检查
可以告诉我们:
“这个角色的声音在本集播放过程中逐渐变得不一致。”
这一层级结构很重要,因为不同错误发生在不同尺度上。
LLM 能评判 AI 配音吗?
这正在成为一个顺理成章的发展方向。
多模态模型有望同时检查:
- 原始视频,
- 配音后的视频,
- 转写文本,
- 译文,
- 说话人信息,
- 时间戳,
并生成结构化评估。
例如:
Translation:       9.2 / 10
Speaker identity:  8.8 / 10
Naturalness:       8.5 / 10
Emotion:           7.1 / 10
Timing:            8.0 / 10
Lip sync:          7.6 / 10

Critical issues:
- Segment 183: wrong speaker
- Segment 227: emotional mismatch
- Segment 311: target speech overlaps next speaker
这对大规模生产极具吸引力。
但我们仍需谨慎。
近期 SpeakerSleuth 的结果给出了很好的警示:当前的大型音频语言模型可能不擅长判断声音层面的说话人一致性,文本上下文甚至会影响模型,使其倾向于错误答案。
因此,答案可能不是:
“让 LLM 判断一切。”
更合理的做法是:
对可衡量的属性使用专门的客观指标,用多模态模型完成上下文推理,再由人工处理影响较大的主观决策。
更完善的评估架构
由此可以构建一个三层评估系统。
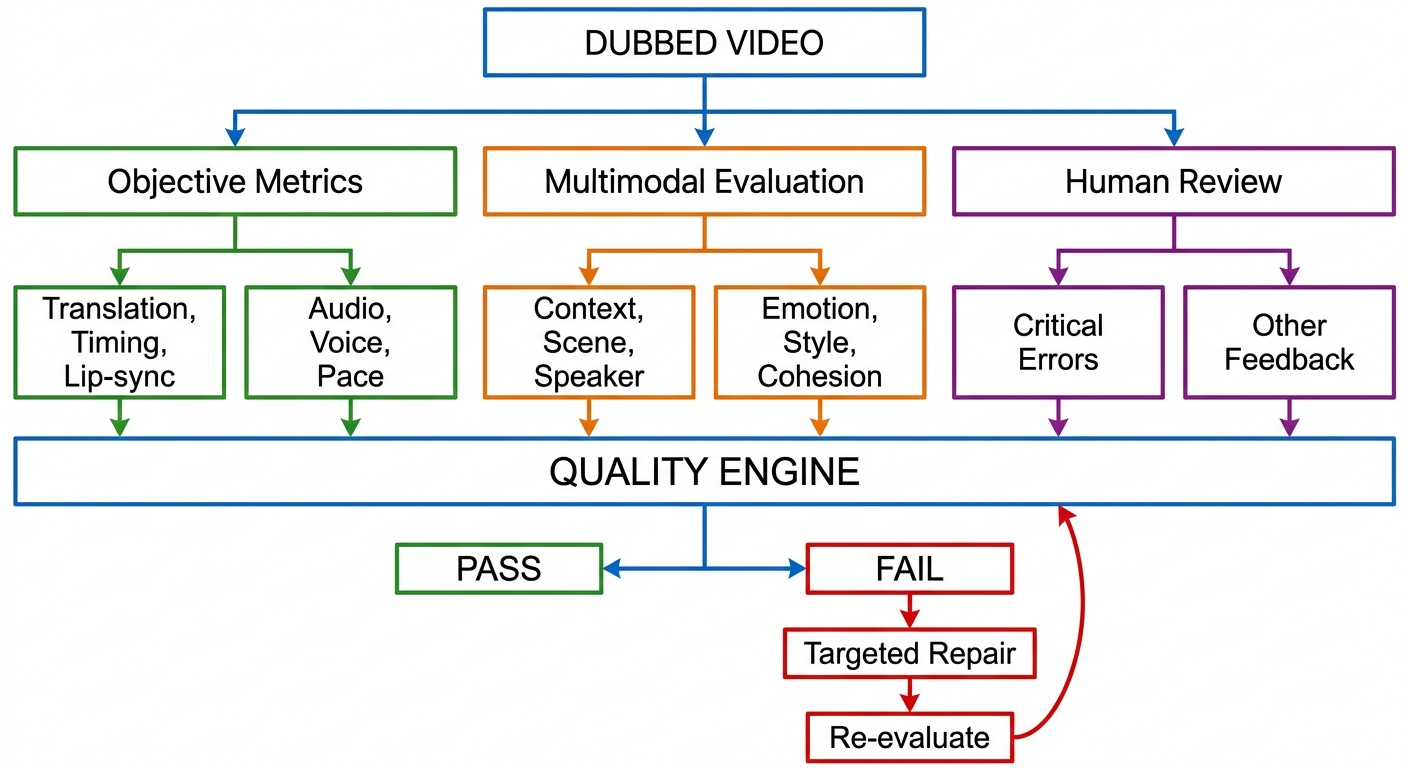
这与下面这种流程有本质区别:
Generate → Watch → Looks OK在生产规模下,我们需要:
生成 → 衡量 → 诊断 → 修复 → 重新衡量
质量评分卡
因此,实际系统可以生成类似下面的评分卡:
| 类别 | 分数 | 置信度 | 操作 |
|---|---|---|---|
| 翻译 | 96 | 高 | 通过 |
| 术语 | 98 | 高 | 通过 |
| 说话人相似度 | 93 | 高 | 通过 |
| 说话人一致性 | 87 | 中 | 复核 |
| 自然度 | 91 | 中 | 通过 |
| 韵律 | 84 | 中 | 复核 |
| 情绪 | 78 | 低 | 复核 |
| 语速 | 94 | 高 | 通过 |
| 时序 | 89 | 高 | 通过 |
| 音量 | 97 | 高 | 通过 |
| 唇形同步 | 91 | 高 | 通过 |
| 音频质量 | 95 | 高 | 通过 |
更重要的是,我们不一定要把这些数字压缩成一个标量。
我们可以改为生成:
OVERALL
──────────────
GOOD

⚠ 3 segments require review

Segment 183
  Speaker consistency    FAIL

Segment 227
  Emotion                WARNING

Segment 311
  Timing                 FAIL
这样的结果更便于采取行动。
VMEG 可以从中得到什么启示
VMEG 处理的视频本地化任务规模很大,不可能人工观看每一段成片。
这改变了需要解决的工程问题。
目标不能只是:
构建更好的配音模型。
还应该是:
构建一个能够持续判断自身输出是否可信的系统。
这也体现了上一篇文章所介绍架构的重要性。
端到端智能,流水线级控制。
AI 模型可以从全局理解视频。
但生产系统需要暴露中间决策:
Video
 ↓
Transcript
 ↓
Speaker map
 ↓
Translation
 ↓
Segmentation
 ↓
Timing
 ↓
Voice assignment
 ↓
Speech generation
 ↓
Audio mixing
 ↓
Lip sync
 ↓
Quality evaluation
每个阶段都提供了衡量质量的机会。
而且,当某个环节出错时,我们未必需要重新生成整段视频。
如果问题是:
Segment 183
Speaker = wrong
就应该修复说话人分配。
如果问题是:
Segment 227
Duration = 3.4s
Target = 2.5s
就应该修复时序或翻译。
如果问题是:
Segment 311
Emotion = neutral
Expected = angry
就应该重新生成这段表演。
这样才能让配音系统可调试。
从“质量评分”走向“质量工程”
这或许是更重要的启示。
下一代 AI 本地化系统不会只按底层模型的质量接受评价。
人们还会看它能否可靠回答:
哪里出了问题?
以及:
能否只修复出错的部分?
还有:
如何确认修复确实改善了结果?
这样一来,评估就形成了反馈闭环:
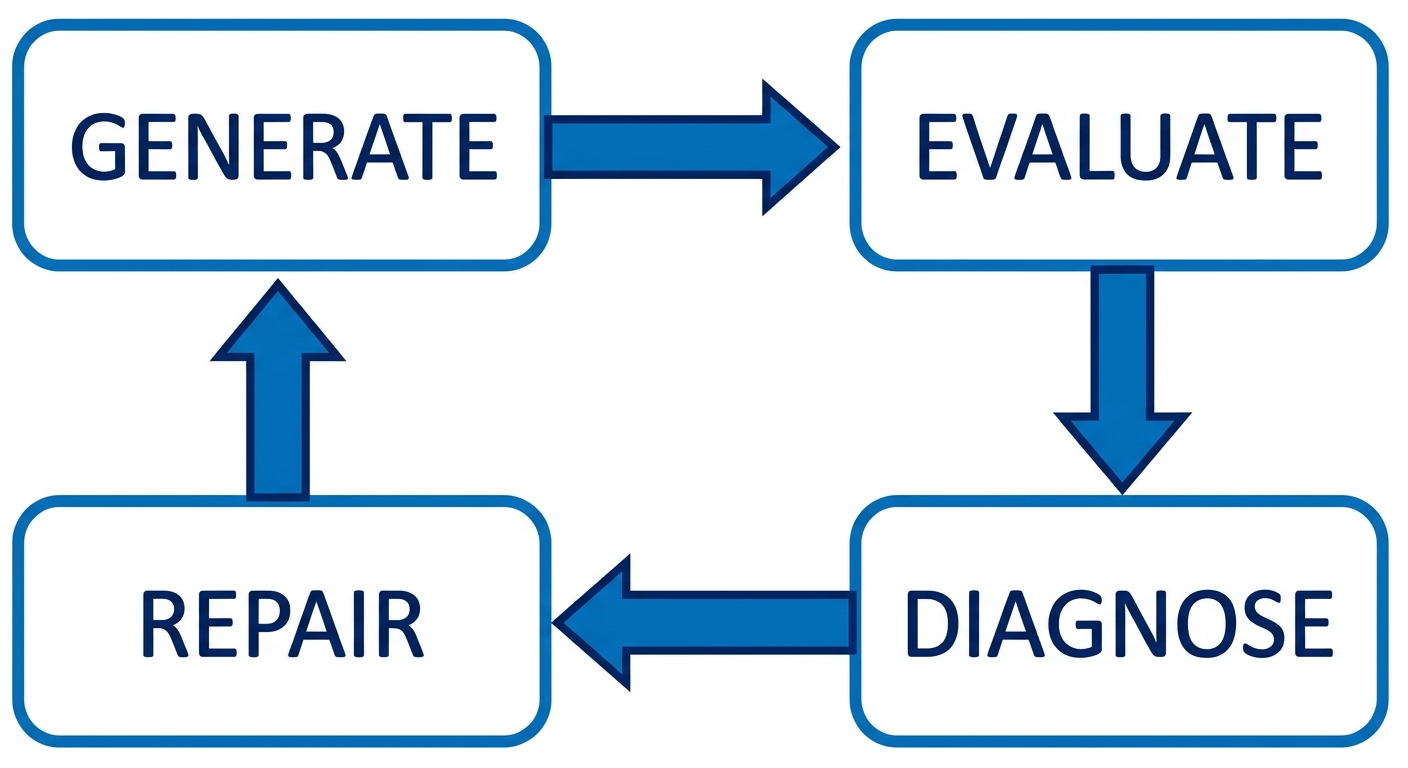
这就是生产级 AI 的核心。
未来:用配音质量向量取代单一分数
最实用的抽象方式,或许是用一个质量向量表示每段配音视频:
其中:
- T = 翻译准确度
- S = 说话人相似度/一致性
- N = 自然度
- P = 韵律
- E = 情绪
- R = 节奏/语速/时序
- V = 视觉同步
- C = 上下文一致性
各项权重不一定需要固定。
对于教程:
对于剧情片:
对于播客:
对于音乐视频:
与单一的“AI 配音评分”相比,这种方式更符合质量的实际情况。
结论:优秀配音是系统整体的属性
评估 AI 配音时,最大的错误就是孤立地评估各个组成部分。
翻译可以非常出色。
TTS 可以非常出色。
声音克隆可以非常出色。
唇形同步也可以非常出色。
最终视频却仍然可能很差。
因为观众不会分别体验这些组成部分。
他们体验到的是一场完整的表演。
因此,AI 配音需要一套更全面的评估框架,用于衡量:
含义、声音身份、一致性、自然度、韵律、情绪、语速、时序、音频质量、视觉同步和上下文连贯性。
更重要的是,这套框架还需要理解,对于正在进行本地化的特定视频,哪些维度最重要。
因此,AI 配音评估的未来很可能不是一个单一基准。
它会成为一套质量系统:
衡量每一个重要维度,发现真正影响质量的问题,进行局部修复,并持续验证结果。
归根结底:
模型质量不等于视频质量。
而且:
AI 配音视频的质量,取决于重建表演的质量。
参考文献
- Brannon、Virkar 与 Thompson,“Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing,” TACL 2023。该研究涵盖 319.57 小时内容、54 部专业制作作品、674 集节目和 9,215 名说话人。 ACL Anthology
- Federico 等,“Evaluating and Optimizing Prosodic Alignment for Automatic Dubbing,” Interspeech 2020。 ISCA Archive
- Bane,“Evaluating End-to-End Speech-to-Speech Translation for Dubbing: Challenges and New Metrics,” AMTA 2024。 ACL Anthology
- Won 等,“End-to-End Multilingual Automatic Dubbing via Duration-based Translation with Large Language Models,” EMNLP 2025。 ACL Anthology
- Lee 等,“SpeakerSleuth: Can Large Audio-Language Models Judge Speaker Consistency across Multi-turn Dialogues?” ACL 2026。 ACL Anthology
- Spiteri Miggiani,“Quality in interlingual AI dubbing: Exploring machine and human intersections,” Paralleles,2026。 University of Geneva / Paralleles
- 如需了解多语言视频配音和评估指标的更全面技术综述,可参阅 2023 年发表于 Frontiers in Signal Processing 的综述。 Frontiers