AI 配音的未来,很可能是端到端多模态智能与流水线级控制的结合。
AI 配音正在进入一个值得关注的阶段。
多年来,主流方案一直是由多个专用模型串联而成:
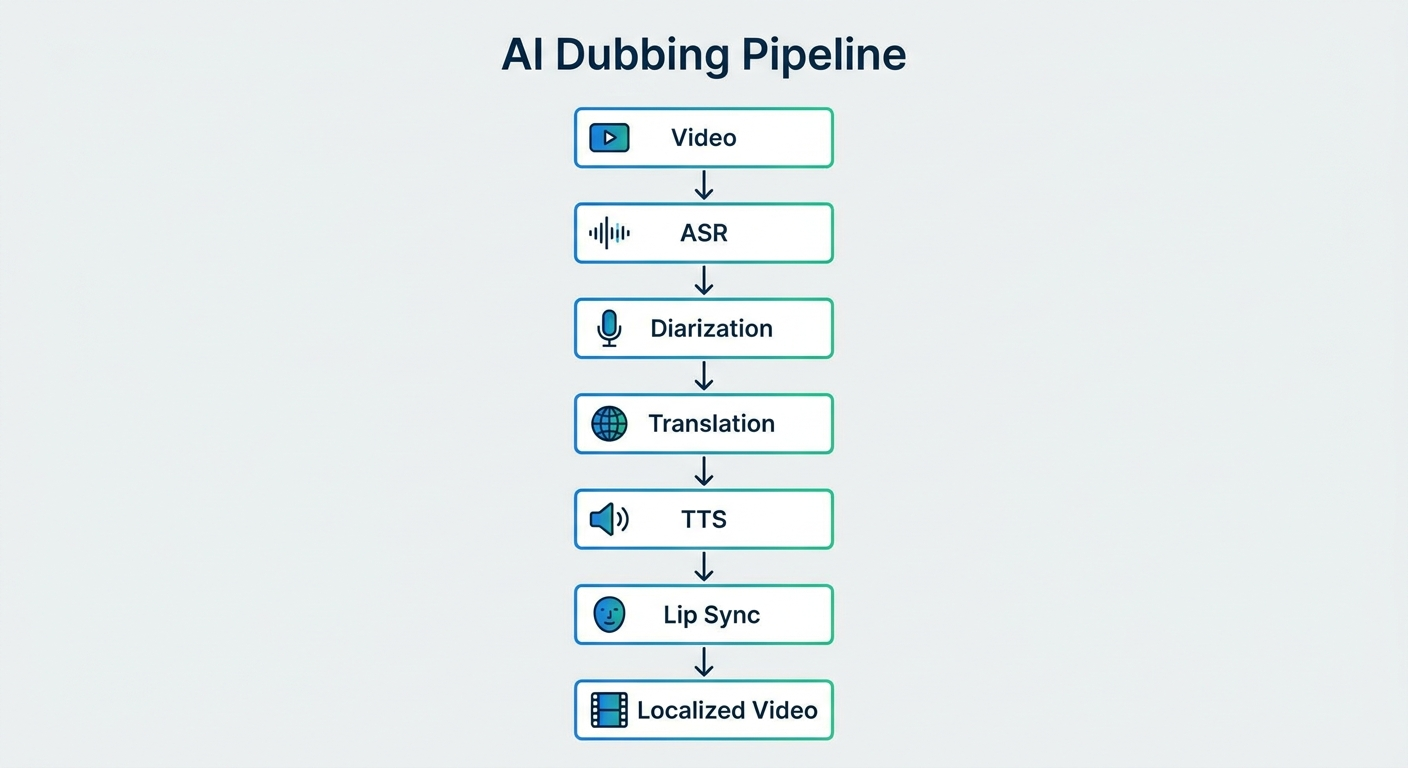
随后,多模态基础模型改变了业界的讨论方向。
过去需要将视频拆解为音频、文本和图像,如今能力日益增强的模型已经可以直接理解视频。例如,Google 的 Gemini 模型能够同时处理视频和音频,理解事件并对特定时间戳进行推理。当前上下文长度为 1M 的 Gemini 模型,在默认媒体分辨率下最多可处理一小时视频,在低分辨率下则可处理三小时视频。
与此同时,商业配音系统的集成度也在不断提高。HeyGen 现已将视频翻译封装为单一 API 操作,整合翻译、声音克隆和口型同步;ElevenLabs 的 Dubbing v2 则明确以保留原说话人的语气、节奏、表达方式和情感意图为目标。
那么,AI 配音的未来是否就是:
输入视频 → 一个模型 → 输出配音视频?
我们认为并非如此。
更值得期待的方向是:
端到端智能与流水线级控制相结合。
端到端的理想形态
端到端系统的吸引力很直接。
设想一下,上传一部两小时的电影,然后提出要求:
“把它配成日语,保留每个角色的声音和情感,使对白与原始表演同步,然后返回制作完成的视频。”
理想的系统如下:
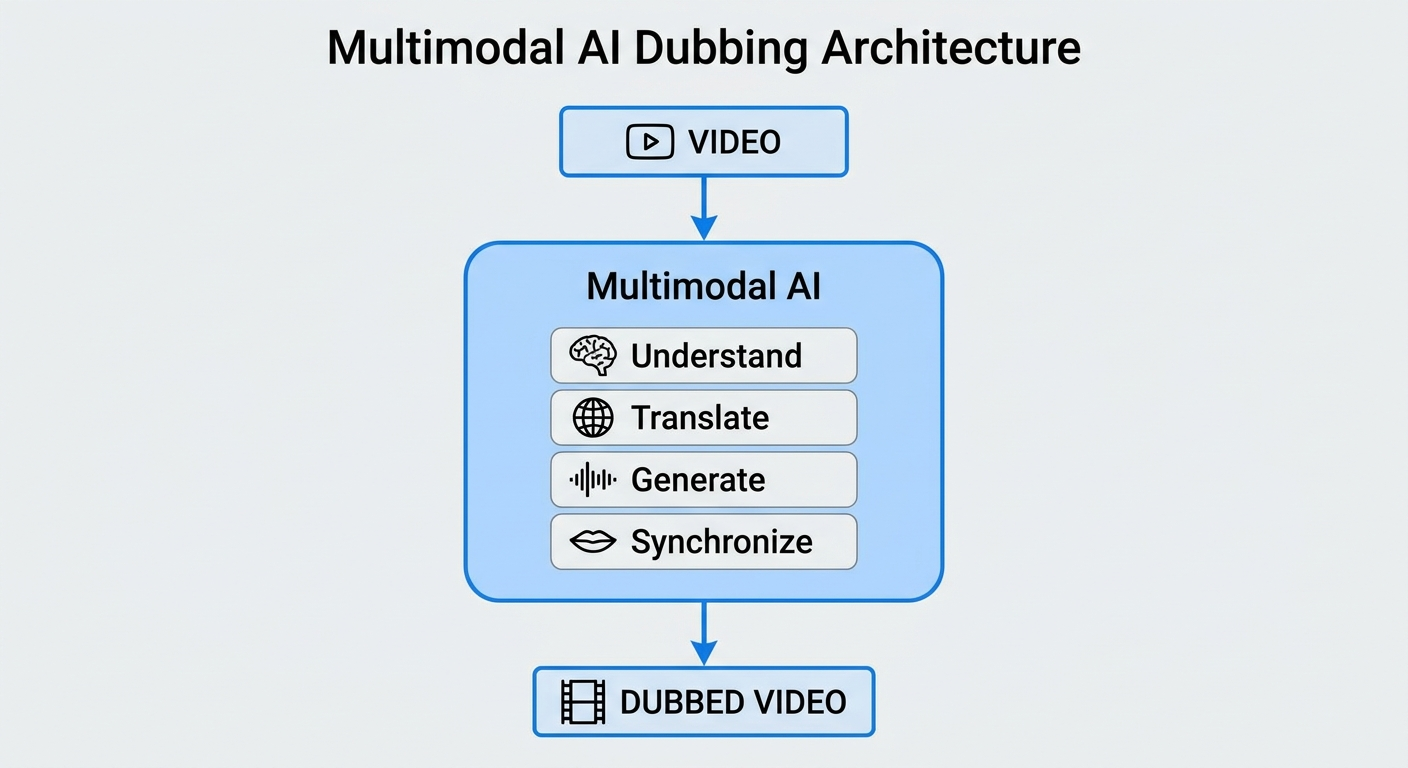
追求这种架构有充分的理由。
全局上下文
单个模型有望综合判断:
- 谁在说话,
- 此前发生了什么,
- 画面中出现了什么,
- 说话人之间是什么关系,
- 对话处于怎样的情绪状态,
- 以及某句话在整个场景中的含义。
这与在多个独立模型之间传递孤立文本有本质区别。
减少信息瓶颈
传统流水线中的每一个接口都可能造成信息损失。
例如:
Audio
  ↓
ASR
  ↓
Text
文本或许保留了说话内容,却可能丢失以下信息:
- 情感,
- 音高,
- 说话风格,
- 犹豫停顿,
- 呼吸声,
- 背景语境。
如果这些信息从未传递到下游,后续的翻译模型就无法将其还原。
联合优化
从理论上看,端到端系统可以直接围绕最终目标进行优化:
本地化后的视频在观感和听感上,是否像原视频的自然本地语言版本?
而不是分别优化 ASR、翻译、TTS 和口型同步。
这不只停留在理论层面。近期研究已经开始在端到端自动配音系统中明确地联合处理翻译与时长控制。EMNLP 2025 的一项研究通过显式约束译文时长,在 COMET 翻译评分保持竞争力的同时,使语音重叠度相对提升最高达 24%。
生产环境不同于演示
假设某个端到端系统生成了一段效果出色的 30 分钟配音视频。
然后你发现:
说话人 7 有 12 秒使用了错误的声音。
该怎么办?
如果整个系统确实采用单体架构,可选择的处理方式可能少得出乎意料。
全部重新生成?
修改提示词后再次运行模型?
然后寄希望于问题不再出现?
生产系统通常不会这样运作。
生产环境会提出更具体的问题:
- 错误发生在哪里?
- 能否定位受影响的片段?
- 能否只修复这个片段?
- 能否保留其他所有内容?
- 能否由人工审核修正结果?
- 能否复现结果?
- 能否自动验证修复过程没有引入其他问题?
这时,流水线的价值便再次显现。
中间表示的潜在价值
以一项生产级配音任务为例。
我们可以把视频表示为一组结构化产物,而不是将其视为一个不透明的整体:
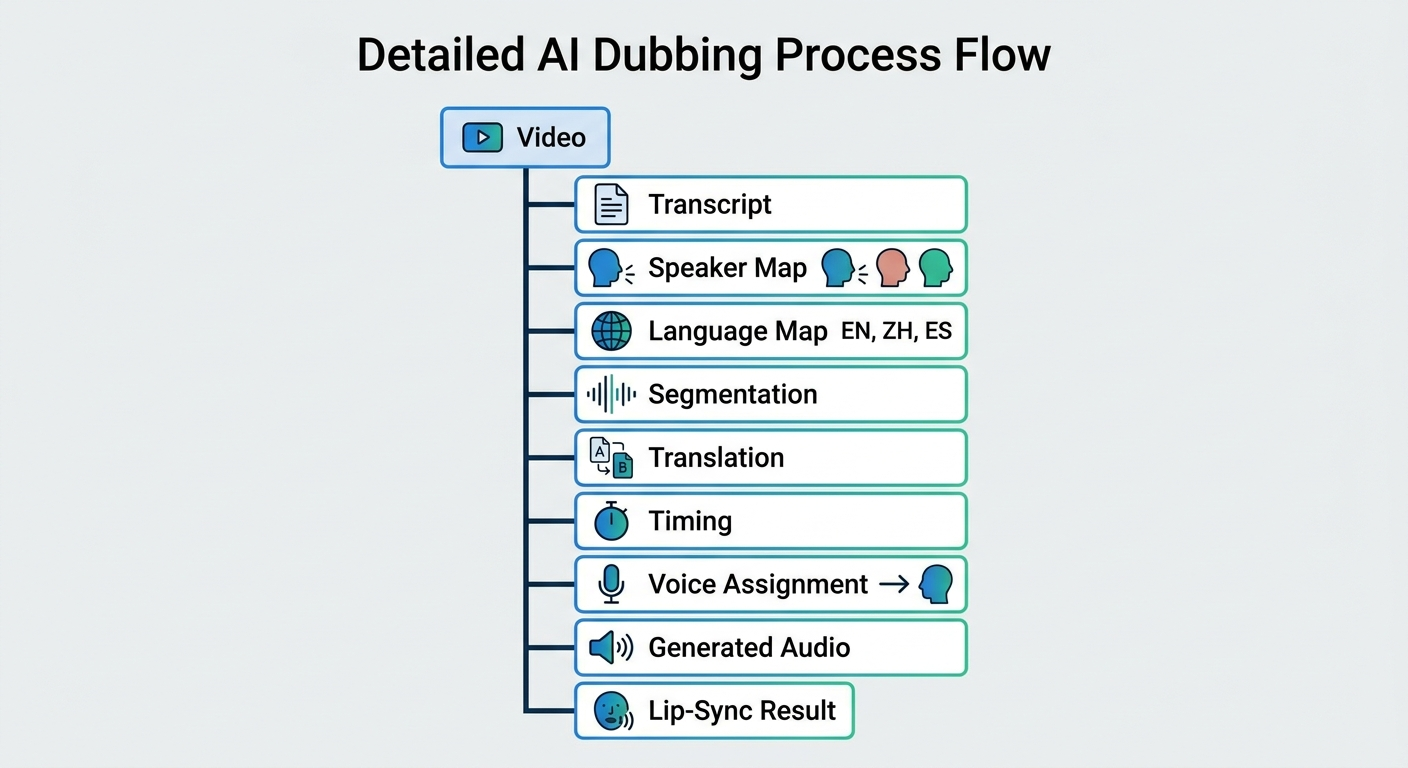
这些不只是实现细节。
它们还是控制点。
翻译有误,就编辑译文。
说话人有误,就纠正说话人。
时间有误,就调整时间。
某个 TTS 片段发音错误,就重新生成该片段。
口型同步失败,就重新执行视觉处理阶段,不必丢弃整个本地化结果。
这正是流水线的根本优势:
它让 AI 系统变得可观测、可恢复。
端到端智能不等于端到端不透明
区分这两个概念非常重要。
“端到端”可以描述系统的智能能力。
但它不一定要描述系统的运作边界。
生产级架构可以使用能力强大的多模态模型理解整个视频,同时保留结构化的中间表示。
从概念上看:
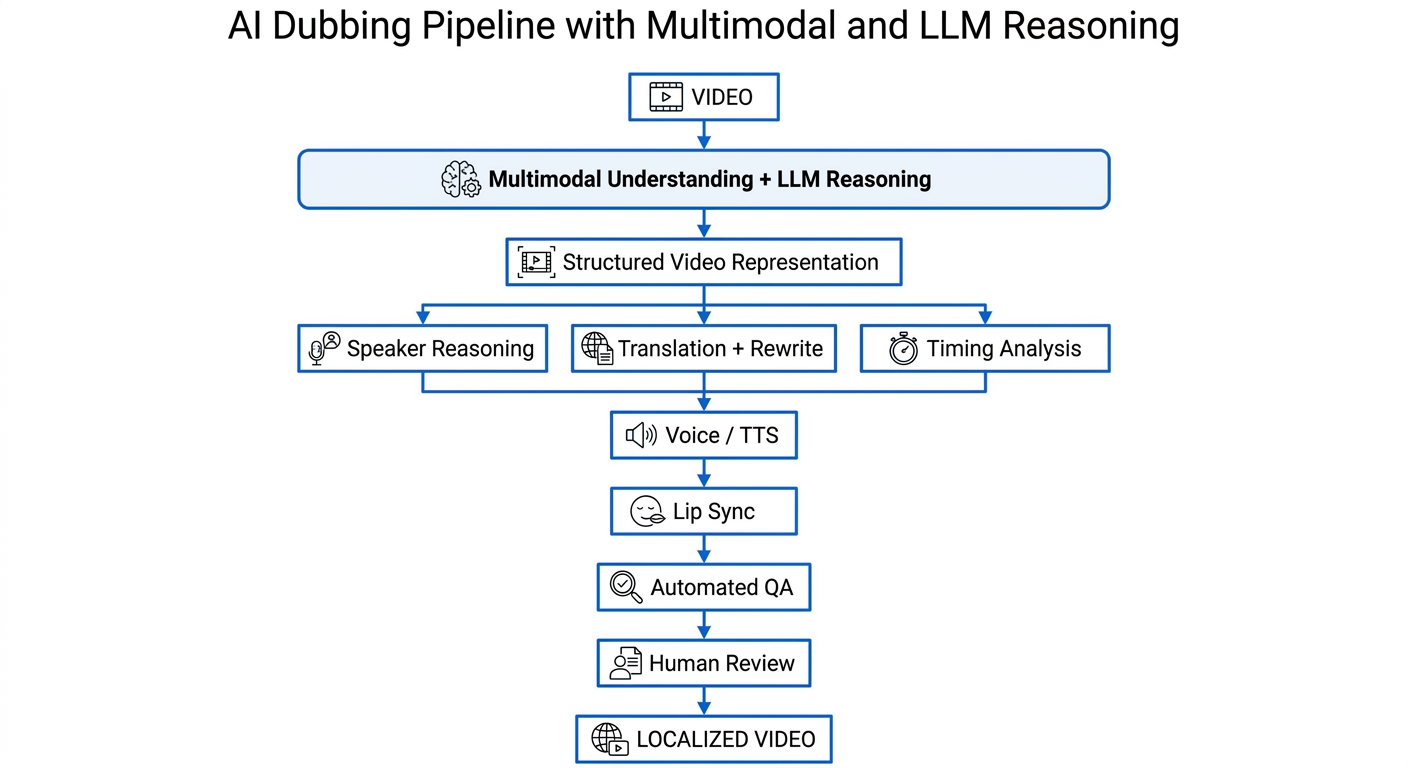
模型的智能能力不断提升。
流水线的可控性也在持续增强。
三种架构方案
我们可以对比三类主要方案。
| 传统流水线 | 集成式配音 | 多模态模型 + 可控流水线 | |
|---|---|---|---|
| 理解方式 | 专用模型 | 集成式处理 | 多模态推理 |
| 上下文 | 通常局限于局部或特定阶段 | 更完善的全局上下文 | 全局上下文 + 结构化上下文 |
| 模块化程度 | 高 | 中 | 高 |
| 中间产物 | 多 | 通常隐藏或仅部分开放 | 明确开放 |
| 调试 | 相对容易 | 较难 | 更容易 |
| 局部重新生成 | 能力强 | 视具体系统而定 | 能力强 |
| 人工审核 | 天然适配 | 支持程度不断提高 | 核心能力 |
| 全局推理 | 有限 | 较强 | 强 |
| 专用模型 | 容易替换 | 耦合度较高 | 容易替换 |
| 生产控制 | 高 | 中 | 高 |
| 端到端优化 | 有限 | 强 | 持续增强 |
我们认为,行业正在向第三种架构发展。
商业系统已开始朝这一方向发展
当今的商业系统也说明,真正的争论其实不是“流水线还是端到端”。
两者已经开始融合。
HeyGen
HeyGen 提供了高度集成的视频翻译体验,可在一套工作流中完成翻译、声音克隆、音频生成和口型同步。其 API 将视频翻译公开为单一操作,并提供速度模式和精准模式。
但它的 API 同时提供校对阶段,允许用户在翻译前提取、审核和编辑转录文本。
这是一个重要的架构信号。
用户感受到的是端到端产品体验。
但生产控制仍需要中间表示。
HeyGen 视频翻译
ElevenLabs
ElevenLabs 的 Dubbing v2 是另一个值得关注的例子。
据该公司介绍,这个模型能够保留原始表演,包括语气、节奏、表达方式和情感意图,而不是根据转录文本生成彼此割裂的语音。目前,它支持超过 90 种语言的配音。
但它的 API 明确采用基于项目的组织方式。
源转录文本和译文都以可编辑数据表示,当前 API 支持修改单个片段,并只重新生成发生变化的区域。
同样,这款产品具有很高的集成度。
但其生产工作流仍然是结构化的。
ElevenLabs 配音
多模态基础模型改变了架构的另一端
另一项重要进展是通用多模态模型的兴起。
以 Gemini 为例,它可以直接处理视频和音频,从视频中提取信息,回答与特定时间戳有关的问题,并结合视觉与音频内容进行推理。Google 文档显示,在默认媒体分辨率下,每秒视频约需 300 个 token;在低分辨率下,每秒约需 100 个 token。当前上下文长度为 1M 的模型可处理的时长上限取决于媒体分辨率,分别可达一小时或三小时。
这种能力带来了一种完全不同的架构。
过去是:
Video
 ↓
ASR
 ↓
Text
 ↓
LLM
现在则越来越能够采用:
Video
 ↓
Multimodal Reasoning
 ↓
Structured Understanding模型既能理解说了什么,也能理解正在发生什么。
这对配音尤其重要。
因为适合的声音、情感、节奏和译文往往取决于视觉场景。
多模态不等于端到端配音
这一点尤其需要强调。
能够理解视频的模型,不会自动成为能够生成生产级配音视频的模型。
视频理解和视频生成有着不同的要求。
配音系统仍需解决以下问题:
- 说话人一致性
- 翻译
- 术语
- 时间
- 声音身份
- 发音
- 韵律
- 语音生成
- 音频混合
- 口型同步
- 质量保证
多模态模型可以成为连接这些任务的推理层。
但它不一定会取代所有专用模型。
这与现代软件系统的工作方式类似:系统使用通用推理层,同时依靠专用服务完成存储、搜索、渲染、编码等操作。
为什么需要流水线级控制
生产系统至少有六个理由需要明确的控制点。
可观测性
发生问题时,需要知道问题出现在哪个环节。
Bad video
   ↓
???
这样的信息无法指导后续处理。
但下面的信息可以:
Bad video
   ↓
Lip sync ✓
TTS ✓
Timing ✓
Translation ✗
。
局部重新生成
一句话出错,不应导致整个三小时视频都要重新生成。
理想流程如下:
3-hour video
     ↓
10,000 segments
     ↓
1 bad segment
     ↓
Regenerate 1 segment
     ↓
Reassemble
大规模生产尤其依赖这一点。
人工审核
AI 系统不需要完全排除人工参与。
它需要让人工干预变得高效。
审核人员应当能够检查:
Original
Speaker
Transcript
Translation
Timing
Voice
Generated Audio
并且只修正必要的部分。
质量门禁
每个阶段都可以设置自动检查。
例如:
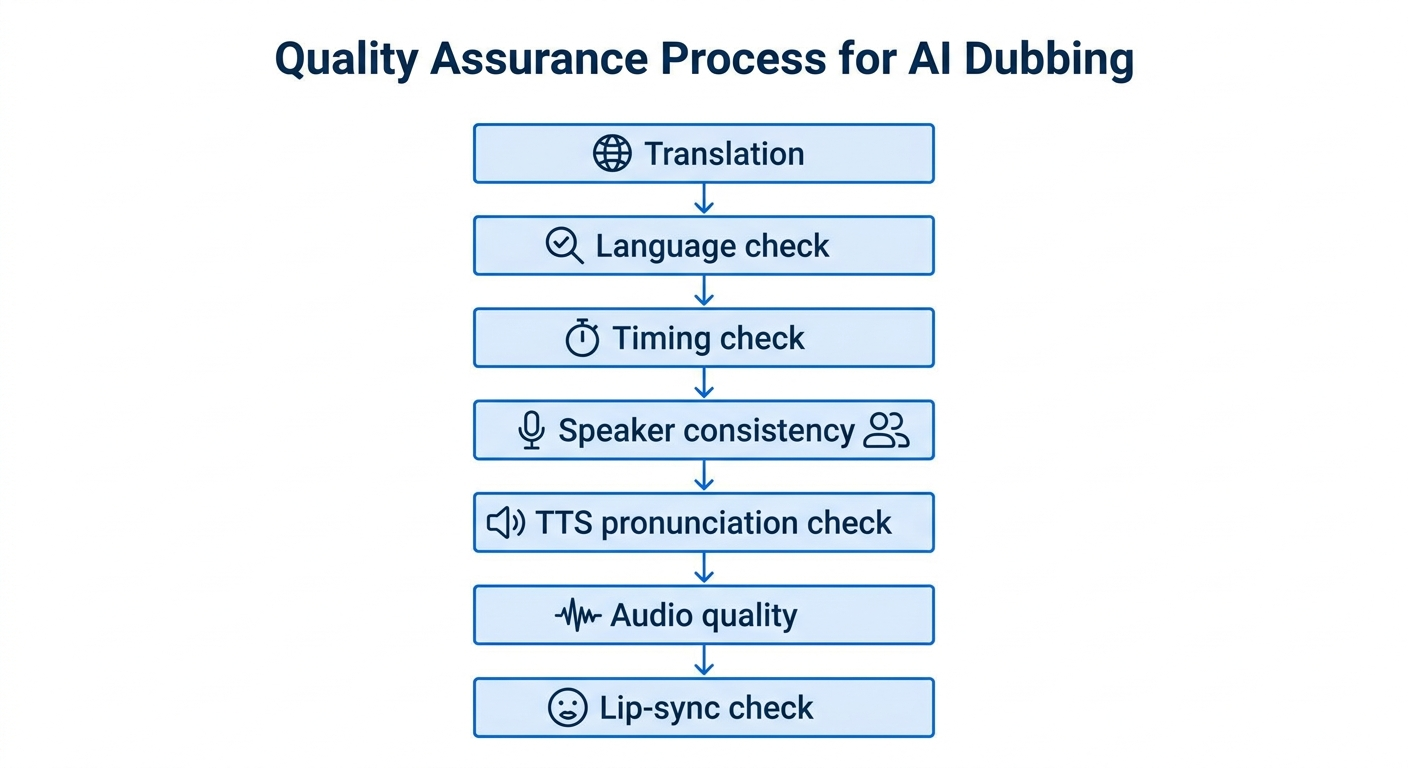
系统可以在错误向下游传播之前拒绝不合格的结果。
可复现性
生产系统需要回答这样的问题:
“为什么我们上个月重新生成这段视频时,效果和现在不一样?”
借助明确的中间产物,可以记录:
- 模型版本
- 提示词
- 译文
- 时间戳
- 声音 ID
- 配置
- 质量检查结果
如果所有信息都隐藏在一次不透明的生成调用中,回答这个问题就困难得多。
成本与延迟
并非每段视频的每个处理阶段都需要使用成本最高的模型。
生产系统可以按需选择:
- 简单片段使用快速模型,
- 困难片段使用更大的模型,
- 高价值操作使用专用模型,
- 仅在置信度较低时进行额外推理。
使用单一的单体模型很难做到这一点。
可校对的 AI
VMEG 的实践经验深刻影响了我们的架构设计。
我们每天处理数万项 AI 视频本地化任务。其中约有 10% 的任务时长超过一小时,我们处理过的最长项目超过三小时,有时还涉及数十位说话人。
在这样的规模下,问题不再只是:
“AI 能否产出优质结果?”
真正的问题是:
“我们能否稳定地产出优质结果,发现问题并完成修复,而且每天重复这一过程数万次?”
这会改变整个架构。
一段长视频可能需要经过:
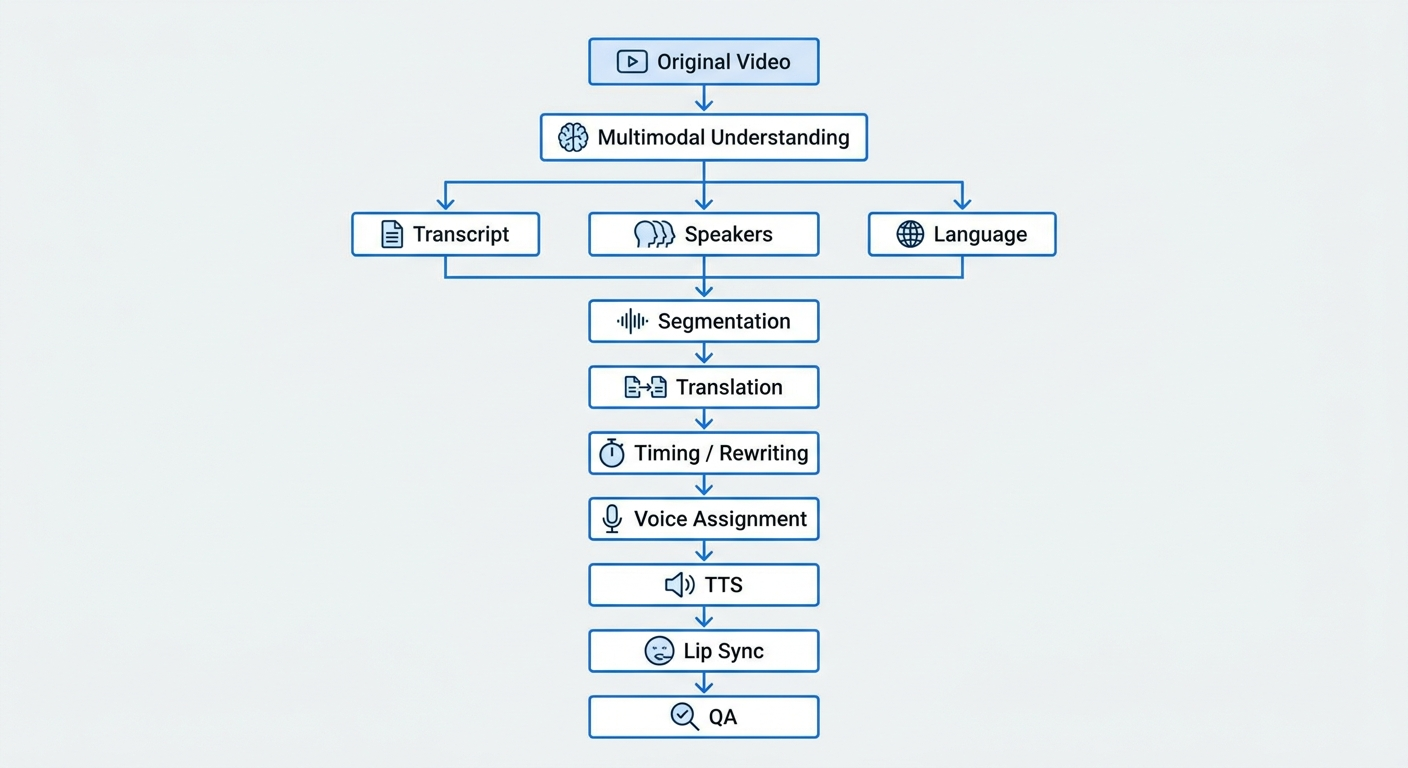
每个关键阶段的输出都应当可以校对。
这意味着 AI 系统不能只产出最终答案。
它还要生成一系列可检查的决策。
一个值得关注的悖论
这里存在一个悖论。
随着模型能力增强,我们或许会认为流水线将逐渐消失。
实际情况可能正好相反。
更强的模型会让流水线变得更智能。
能力有限的流水线可能如下:
ASR → Translator → TTS → Lip Sync现代流水线则可能如下:
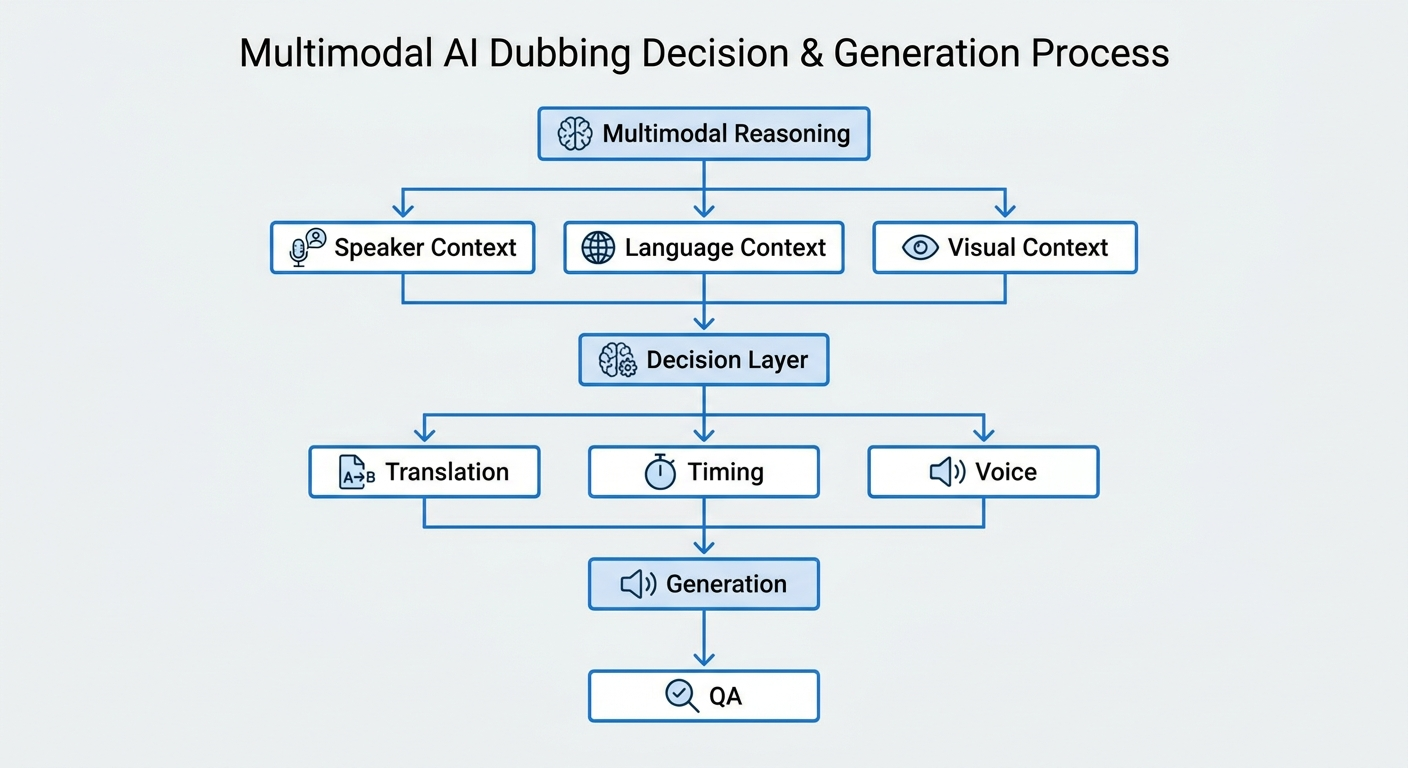
流水线不再只是由简单转换步骤组成的序列,而逐渐成为围绕智能模型构建的控制系统。
哪些任务适合端到端处理?
并非所有部分都需要永远保持模块化。
有些任务越来越适合采用联合建模。
例如:
多模态理解
过去需要分别询问:
谁在说话?
正在发生什么?
当前是什么情绪?
上下文是什么?
多模态模型可以综合推理所有这些问题。
翻译 + 时长
近期研究表明,翻译和时长可以联合优化,不必先完成翻译,再设法将生成的语音强行压入原始时长。前文提到的 EMNLP 2025 研究通过明确考虑时长的翻译方式,使语音重叠度相对提升最高达 24%。
情感 + 韵律 + 时长
近期的配音研究也开始将情感、韵律、时长和视觉对齐视为相互关联的任务,而不是完全独立的问题。发表于 AAAI 2026 的 InstructDubber 使用多模态输入和基于指令的推理,在生成对齐的配音之前提取语速和情感信息。
端到端智能非常适合这类场景。
哪些环节应保持模块化?
另一些边界之所以有价值,正是因为它们提供了控制能力。
例如:
- 编辑转录文本
- 重新分配说话人
- 审核译文
- 选择声音
- 修正时间
- 重新生成音频
- 重新生成口型同步结果
- 最终质量检查
这些不一定是流水线的弱点。
它们是保障可靠性的接口。
目标不是消除所有中间阶段。
而是让这些阶段变得更智能。
重新定义“端到端”
也许我们不应再把“端到端”理解为:
由一个模型完成所有工作。
更合适的定义或许是:
系统围绕最终用户体验进行优化,同时让智能组件能够结合完整上下文进行推理。
按照这一定义,系统仍然可以包含多个专用组件。
智能能力是端到端的。
执行过程是模块化的。
中间产物是可检查的。
故障是可恢复的。
端到端智能 + 流水线级控制
由此可以得到一种我们认为最适合生产级 AI 配音的架构:
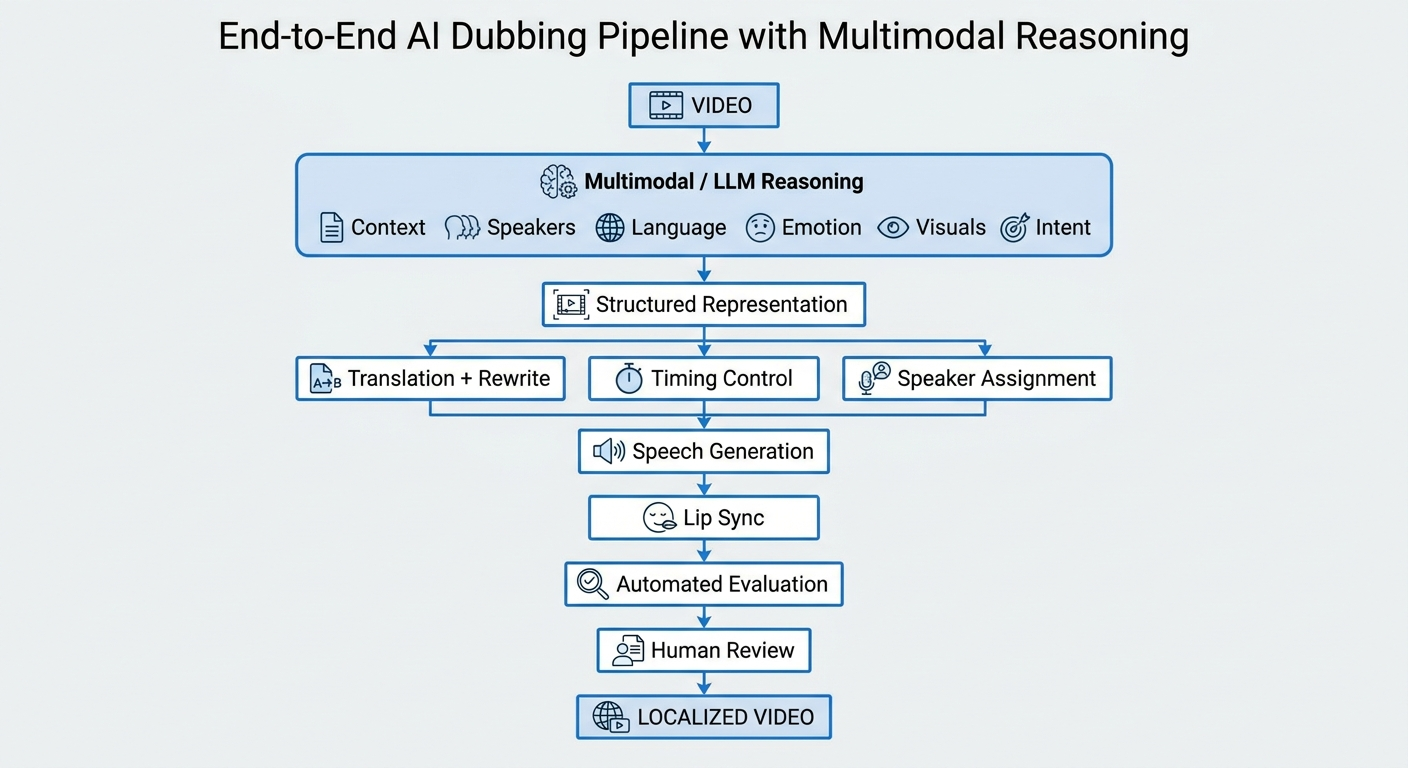
原则很简单:
用端到端智能理解问题,用流水线级控制可靠地解决问题。
未来可能的形态
下一代 AI 配音不会永远沿用今天的流水线形态。
但它也未必会变成一个巨型模型。
我们预计,两种方向将逐步融合。
现在
Specialized models
        +
Hand-designed pipeline
不久的将来
Multimodal reasoning
        +
Specialized generation
        +
Structured pipeline
更长期
Highly integrated multimodal models
        +
Inspectable intermediate representations
        +
Adaptive production orchestration
模型会变得更加端到端。
系统会变得更加智能。
但对控制、可观测性和质量保证的需求不会消失。
它们反而会变得更加重要。
结论
围绕端到端模型和流水线的讨论,往往被描述为一道二选一的问题。
我们认为没有必要如此。
端到端模型擅长理解上下文、关联不同模态,并对复杂视频进行整体推理。
流水线则擅长让系统变得可观测、可控制、可恢复,也更易于规模化。
AI 配音同时需要两者。
AI 配音的未来,很可能是端到端多模态智能与流水线级控制的结合。
最有竞争力的架构未必使用最少的模型。
它更可能将强大的智能能力与出色的检查、修正、重新生成和验证能力结合起来,覆盖每一项重要决策。
生产级 AI 系统的成功标准,不是能否生成一段令人印象深刻的视频。
真正的成功,是能够稳定地生成数万段视频,发现棘手问题并高效修复,同时保证从转录文本的第一个词到本地化视频的最后一帧都符合质量要求。
端到端智能,流水线级控制。
这种架构或许能推动 AI 配音从出色的演示走向可靠的生产应用。
参考资料与延伸阅读
多模态视频理解
- Google Gemini — Video Understanding — 介绍直接理解视频和音频、感知时间戳的推理,以及当前的长视频处理能力。
- Google Gemini — Long Context — 介绍多模态长上下文处理的背景。
商业 AI 配音
- HeyGen Video Translation — 集成视频翻译、声音克隆和口型同步;HeyGen 目前宣称支持超过 175 种语言及方言。
- HeyGen Video Translation API — 从 API 层面介绍集成式视频翻译,以及精准模式和速度模式。
- ElevenLabs Dubbing v2 — 保留原始表演特征的多语言配音。
- ElevenLabs Dubbing API — 基于项目的配音方案,支持编辑源语言和目标语言片段,以及重新生成工作流。
研究
- Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing — 一项基于来自 54 部专业制作作品的 319.57 小时视频开展的研究,分析人工配音的约束和特点。
- End-to-End Multilingual Automatic Dubbing via Duration-based Translation with Large Language Models — 面向配音的端到端时长感知翻译研究;报告显示,语音重叠度相对提升最高达 24%。
- InstructDubber: Instruction-based Alignment for Zero-shot Movie Dubbing — 综合视频、剧本、语速、情感和时长进行多模态推理,以完成电影配音。
- From Speaker to Dubber: Movie Dubbing with Prosody and Duration Consistency Learning — 研究如何使配音同时与原始表演的情感特征和时间特征保持一致。