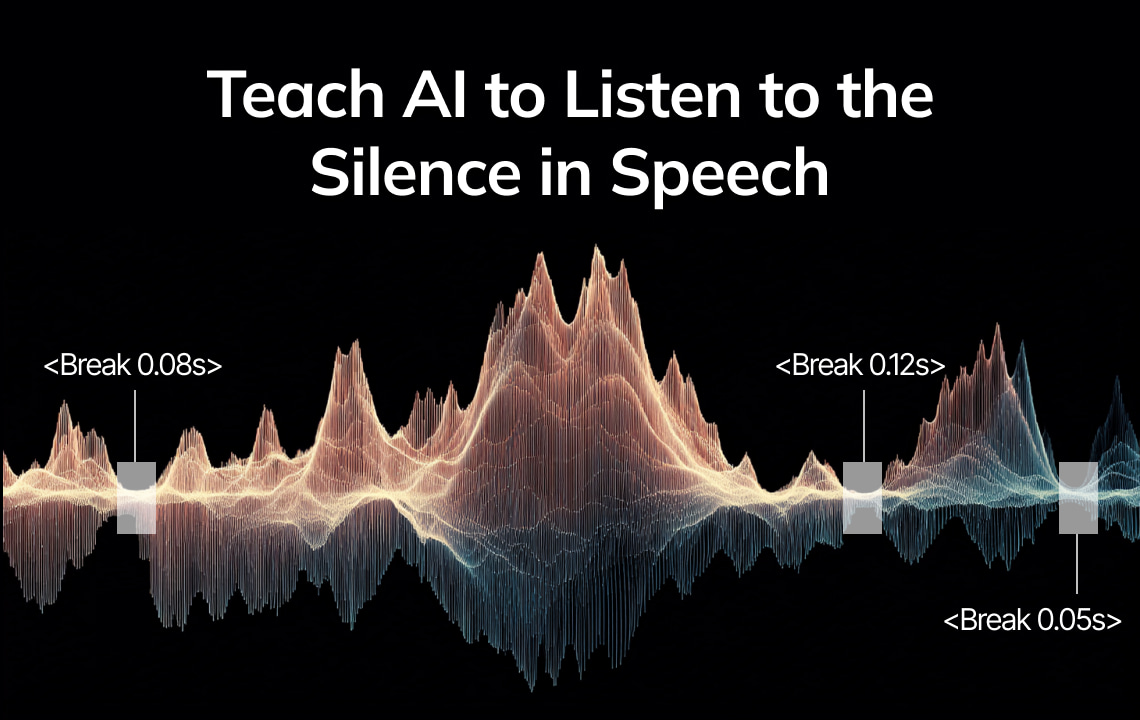
在让机器说话更像人类的漫长探索中,我们一直关注用词准确性、逼真的语调,甚至声音质感。但我们可能都忽略了藏在字句之间的一个秘密。它承载着呼吸、情绪与思绪,那就是停顿。
今天,我们想分享一项看似细微、实则以人为本的重要进展:我们让机器学会了理解人类的沉默。
机器的“机械感”从何而来?
设想两个版本的配音:
- 版本 A:发音无可挑剔,一口气说到底,信息连珠炮般涌来,不留一丝间隙。
- 版本 B:在关键时刻略作停顿,在转折前留下悬念;它的节奏本身就在告诉你:“这很重要”“让我们想一想”“故事即将出现转折”。
哪个版本更能打动你?答案不言而喻。
我们早已习惯,人类的言语并非一条平滑的直线,而是由高峰、低谷和呼吸构成的山峦般的声音景观。那些恰到好处的沉默,是言语的标点、情绪的载体,也是听众大脑消化信息的宝贵缓冲。
传统机器配音的“机械感”很大程度上源于此:它们拥有好听的声音,却缺少一颗懂得如何“呼吸”的心。
传统机器配音的“机械感”很大程度上源于此:它们拥有好听的声音,却缺少一颗懂得如何“呼吸”的心。
不止于标点:从“语法规则”到“生命节奏”
一个很直观的想法是,让机器遵循标点规则即可。句号停久一些,逗号停短一些。
但真实世界中的言语远比这更鲜活、更复杂。
- 人在兴奋时,可能不顾标点,一口气说完整段话。
- 人在回忆或思考时,任何一个词后面都可能出现停顿,那里未必有逗号。
- 不同语言有着各自固有的节奏。十个汉字承载的信息量,可能需要一连串快速的西班牙语音节才能表达;而日语的节奏则蕴藏在假名与助词的密集组合之中。
标点只是文本的骨架,真实的停顿才是流淌在声音中的血液。
我们的答案:复现生命的“呼吸印记”
于是,我们改变了思路。不再命令机器“根据规则猜测”,而是引导它“通过数据聆听”。
- 聆听痕迹:我们使用自动语音识别(ASR)技术。它不仅输出文本,更有价值的是,还会记录每个词在时间轴上“出现”与“结束”的时间戳。
- 解读沉默:我们分析词语之间的时间间隔。那些异常延长的间隙,正是原说话人留下的真实“呼吸孔”。这并非随机的空白,而是语言的韵律与思绪的痕迹。
- 文化适配:我们针对不同语言校准聆听的“灵敏度”。对于中文和日语这类节奏紧凑的语言,我们捕捉更细微的停顿;对于泰语和缅甸语这类连续书写的语言,则使用更宽的阈值来感知其更为舒展的节奏。
本质上,我们是在把声音的“生命节奏”,也就是那些承载着犹豫、强调、回忆与情绪的沉默,转化为机器能够理解的标签,再让 TTS 在音频中将其复现出来。
一个简单示例,感受“呼吸”的分量
原说话人可能会这样说:
“我们的新模型可以实时处理数据……(自然吸气并转入下文)……并在数秒内给出结果。”
标准的文本转语音(TTS)会平铺直叙地说:
“我们的新模型可以实时处理数据,并在数秒内给出结果。”
经过系统“聆听”后,生成的内容是:
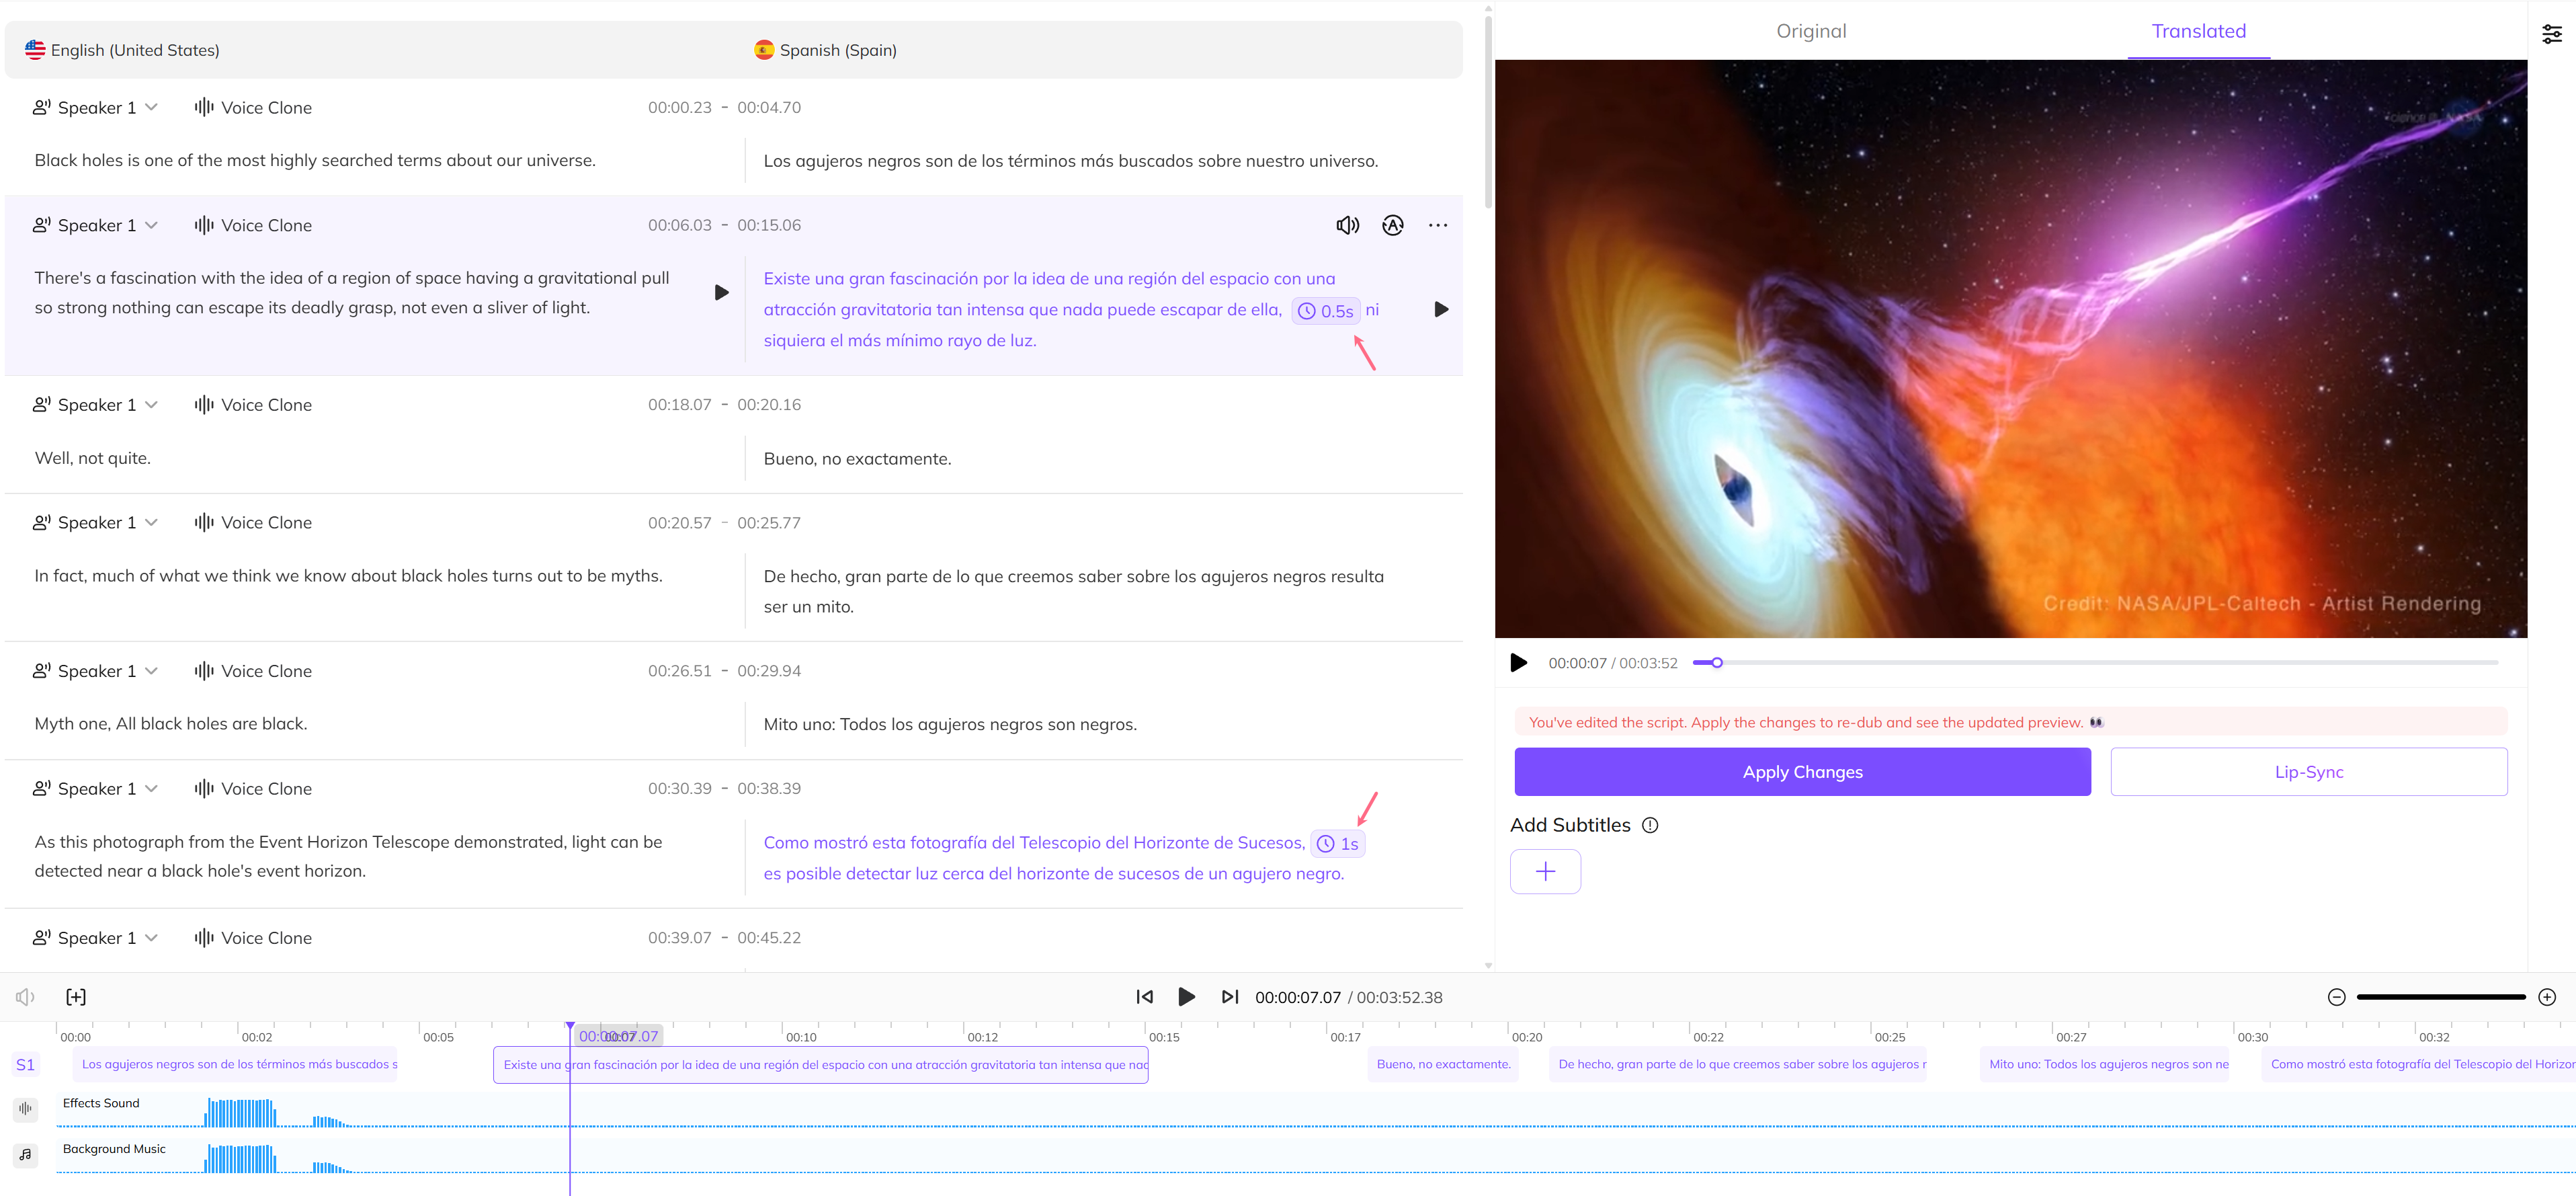
“我们的新模型可以实时处理数据 <break time="300ms"/>并在数秒内给出结果。”
“我们的新模型可以实时处理数据 <break time="300ms"/>并在数秒内给出结果。”
这 300 毫秒并非冰冷的算法参数。它是从原始音频中“采集”的一段真实沉默,是说话人为你留下的思考时间。
为什么插入标签,而不是拉伸音频?
因为我们追求的是“精准”,而不是“同质化”。这就像经验丰富的指挥家,只在乐句结束时抬起指挥棒,而不会让整段乐章以相同幅度全面放慢。插入
<break> 标签可以让我们:- 精细控制:在真正需要的位置准确插入静音。
- 确保绝对可靠:保证每次停顿都处于合理范围内,避免出现不自然的过长间隙。
- 保持广泛兼容性:让这份已被理解的“沉默”能够由主流 TTS 引擎准确“演绎”。
守护这份“理解”,避免误用
任何精密机制都需要可靠的防护措施。因此,我们设置了多重保障:
- 不确定时保持克制:如果语音识别质量较差,我们宁可不添加任何停顿,也不植入错误的“呼吸”。
- 过滤虚假“沉默”:识别并忽略由识别错误造成的异常过长间隔。
- 保证输出纯净:清除可能被意外添加的多余格式,确保最终指令清晰明确。
- 量化“自然度”:将停顿精度统一为 10ms,避免不自然的细微抖动,让节奏流畅而稳定。
最终,我们带来了哪些改变?
机器学会沉默之后,变化细微,却能让人真切感受到。
- 讲述故事时,声音有了悬念感。
- 表达观点时,声音有了力量感。
- 铺陈描述时,声音有了画面感。
用户或许无法准确说出其中的技术原理,但他们的反馈都指向最本质的感受:“这个声音听起来更真实。”“听着不赶,很舒服。”
这种“自然感”,恰恰藏在那些被精准复现、看似微不足道的沉默之中。
一个类比
如果把一句话比作一条小路,词语是铺路的石块,那么词与词之间的时间就是石块之间的间距。
我们所做的,是观察哪些间距被自然拉宽了,那些位置就是讲说话人思维中的“呼吸点”。随后,我们在原处铺上一层柔软的时间地毯,也就是一个
我们所做的,是观察哪些间距被自然拉宽了,那些位置就是讲说话人思维中的“呼吸点”。随后,我们在原处铺上一层柔软的时间地毯,也就是一个
<break> 标签,让声音能在那里停顿和呼吸。未来之路
这只是开始。未来,我们希望机器不仅能复现沉默,还能理解沉默背后的情绪:它是疑惑时的迟疑,还是强调之后的庄重?是转折之前的留白,还是感动之下的无言?
我们期待机器能够根据目标语言的文化节奏,智能调整这份“沉默”,让翻译后的声音不仅语义准确,韵律也自然协调。
这样一来,机器生成的就不再只是一串正确的词语,而是开始拥有生命的节奏。
我们让机器学会了理解言语中未曾说出口的部分。
VMEG 视频翻译器
了解 AI 如何通过静默语音识别与节奏建模感知言语中的沉默,让机器捕捉人类说话时的停顿、情绪与呼吸。