配音听起来赶了或拖了,能不能靠「每秒多少音节、音量抖了几次」判定这句合不合格?不能。源片经常噪音大、被剪过、说话不清楚,时间戳也不准。包络法和强制对齐得到的音节率,都可能与实际听感不一致。相对的听感语速,即配音相对原片拉长或压短的程度,再按这个语言对的习惯校正,在下面 14 句里和耳朵同向。
人配音时,片子长短主要跟译文走,对不上更愿意松时间,也不愿猛改语速(Brannon et al., 2023)。当时间窗口过于严格时,合成语音会过快、过慢、或邻句不匀;边界稍松,听感会好一些(Federico et al., 2020)。合成后再整段变速,可懂度和自然度会掉(Sahipjohn et al., 2024;Choi et al., 2025)。所以我们对齐:少改播放速度,先展开邻句时间,再改写译文。变速放最后。材料是线上反馈语速不均的 14 句印地语配印度英语。
语音学已经知道什么
跨语言比较很少用词/分钟,通常数音节或音素。实验室能解释「日语往往比汉语说得快」;配音要问的是这句译语听着自然不自然。
Pellegrino et al.(2011)七种语言:信息装得密的,音节往往说得慢。他们那批材料上,日语大约每秒 7.84 个音节,英语 6.19,普通话 5.18。快慢对冲并不保证每秒信息量一样:日语相对越南语大约 0.74,英语大约 1.08。Coupé et al.(2019)扩到 17 种语言,信息量均值大约每秒 39 bit(标准差约 5),音节率均值大约 6.63。这是整体倾向,不是每一句配音的及格线。这次也没有估信息量。
这次用到的两种算法,先用白话说。
第一种叫包络方法。不看字,只看音量曲线上鼓起来的包,把能量峰值作为音节核的近似,据此估计单位时间内的音节数,再除以时长(Mermelstein, 1975;Morgan & Fosler-Lussier, 1998;Wang & Narayanan, 2007;De Jong & Wempe, 2009)。好处是不用转写。这些方法多半在同一种语言、干净材料上对照人工音节位置做过验证。源片一切、底噪一跳,鼓包就不再等于音节。
第二种叫强制对齐的音节率。将文本与语音强制对齐,再统计时间窗内的音节数。工具是 Montreal Forced Aligner(McAuliffe et al., 2017;GitHub)。源片和配音各数一次再相除:大于 1 像是配音更快。短句、说话不清楚、印地语对英语时,切分误差会被放大。音节率和音素率衡量的是不同层面的语速特征,不能直接互换。(Trouvain & Möbius, 2014)。
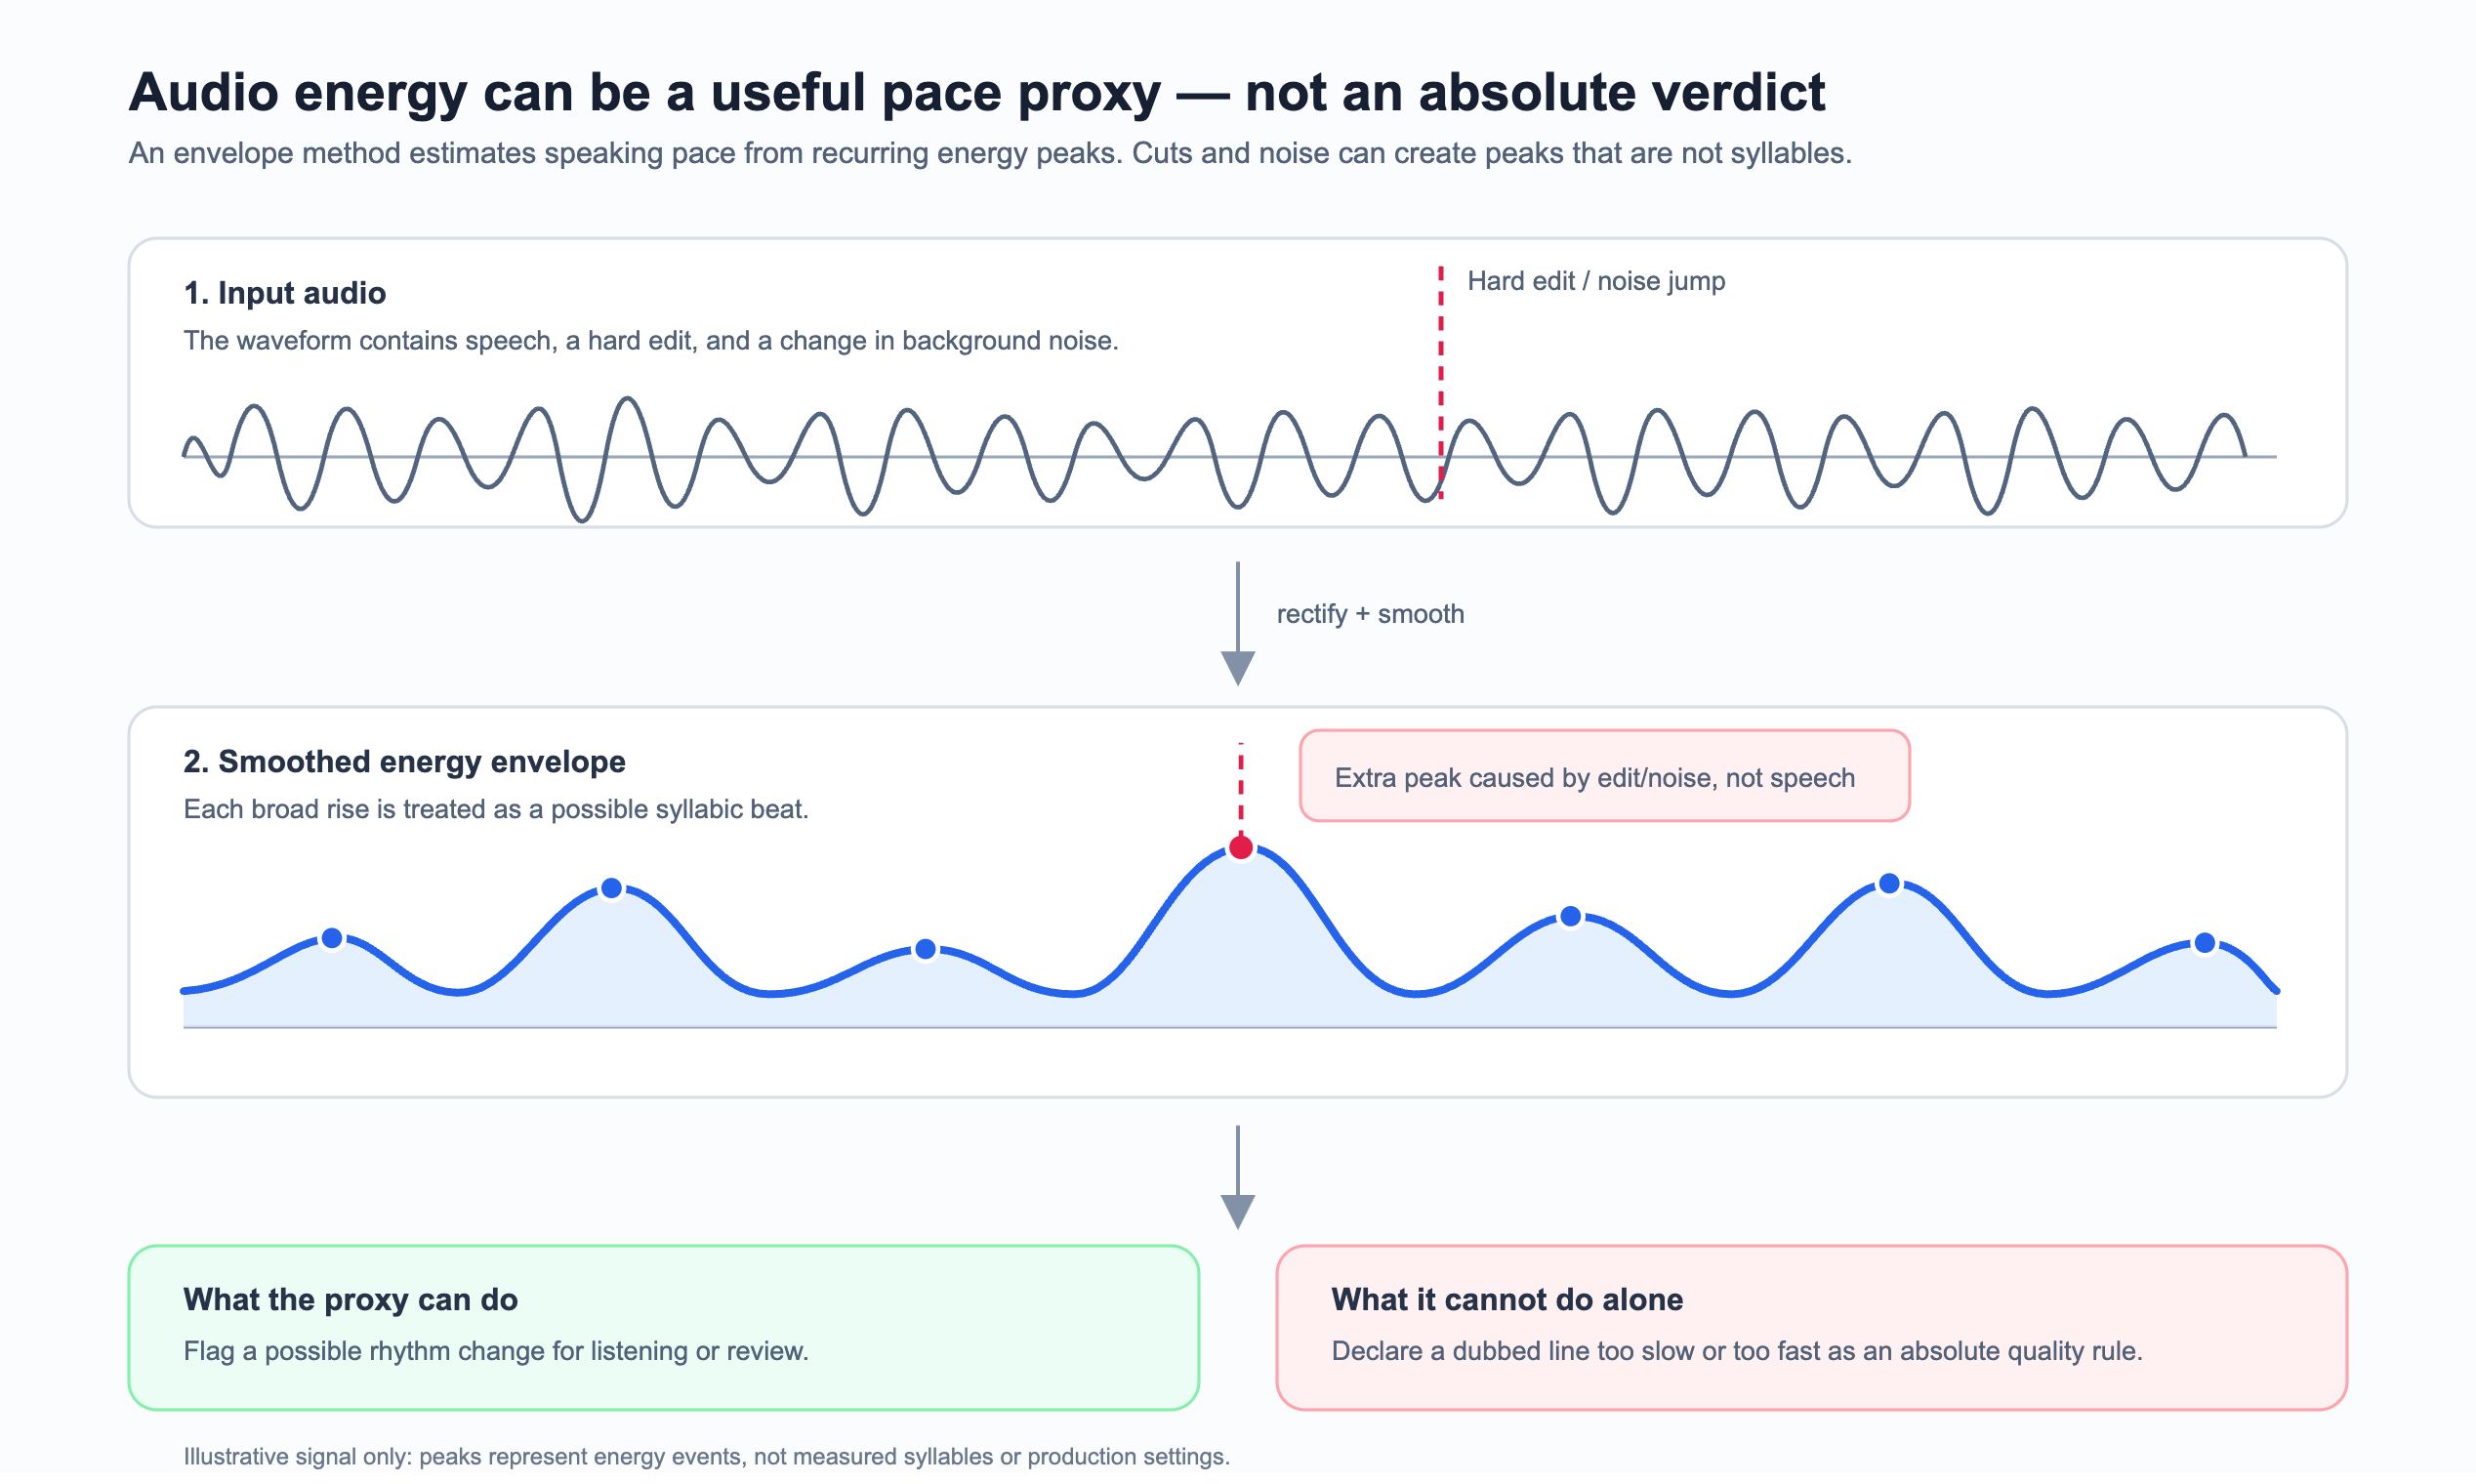
听感也不等于某一种计数。Pfitzinger(1998, 1999)发现人觉得快慢,往往要同时看音节率和音素率(相关大约 0.88–0.91)。听外语时,人还常常觉得对方更快(Pfitzinger & Tamashima, 2006;Bosker & Reinisch, 2017)。配音面对的是译语听众加画面,不是实验室平均音节率。
四种情况
每种情况听成片。材料:14 句印地语配印度英语。
情况一:包络为什么有时会失效
听成片:并不拖,还略快。Madam, No, Saturn with Rahu can go to hell, sorry. Every child brings their own karma. 包络判比源片慢,听感语速不慢。源片有剪辑硬切,底噪跟着跳,能量峰被抬高,源侧被算快,译文就被误判成慢。
成片:
源片(能听到切音和底噪跳变):
情况二:强制对齐的音节率为什么有时会失效
听成片:不慢。She needs training, she doesn't need remedies. 14 句里最短的一句。强制对齐的音节密度明显低于源片,听感语速正常。短窗上切分一歪,跨语言再比音节率,就会把正常短句判慢。
成片:
源片:
情况三:听感语速能抓住「配过来不自然」
听成片三句。中间这句:Child, the area around your home is opening up, because she can read energy. 听感语速和包络都判慢,和耳朵同向。音素率、音节率相对源片却大于 1,像是配音更快。源片本身也慢,咨询谈话本来就不赶;跨语言直接比较音节率,无法区分“目标语言本身的节奏差异”和“配音相对于画面的实际听感偏差”。
成片(三句):
源片(三句):
情况四:按听感语速微调邻句,快慢可以更顺
还是这三句。邻句一个偏赶、一个偏拖。我们正在实验:按听感语速把边界挪一点点。还不是线上默认。先听当前成片,再听微调之后。
当前成片(三句):
同一段三句,打开听感语速邻句边界微调之后(实验中):
对齐和改写怎么保自然语速
Chaume(2012)把对白同步拆成三件:出声起止跟不跟这张嘴、口型像不像、动作讲不讲得通。时长对上,只是第一件。它不要求译语用和源语言一样的说话速度把字说完。
Brannon et al.(2023)看了 54 部成片、三百多个小时。译文长短和配音时长的相关大约 0.52(0 为无关,1 为完全跟着走),语速和时长大约 0.16。西、德语配音员的语速波动还低于英语原片。人被迫二选一时,更愿意打破时间约束,也不愿改语速。
对齐上,位置还是要靠近原片,否则口型对不上;起止可以稍松,合成语音就不必被拉得过快或过慢(Federico et al., 2020)。合成上,有一类模型开口时就把长度说对,而不是生成后再整段拉伸;后一种会伤可懂度(Sahipjohn et al., 2024;Choi et al., 2025)。改写译文也是一条路(Saboo & Baumann, 2019)。我们仍然保留变速,只是放在最后。
所以现在这套是:展开相邻块、必要时改写,播放速度放最后。
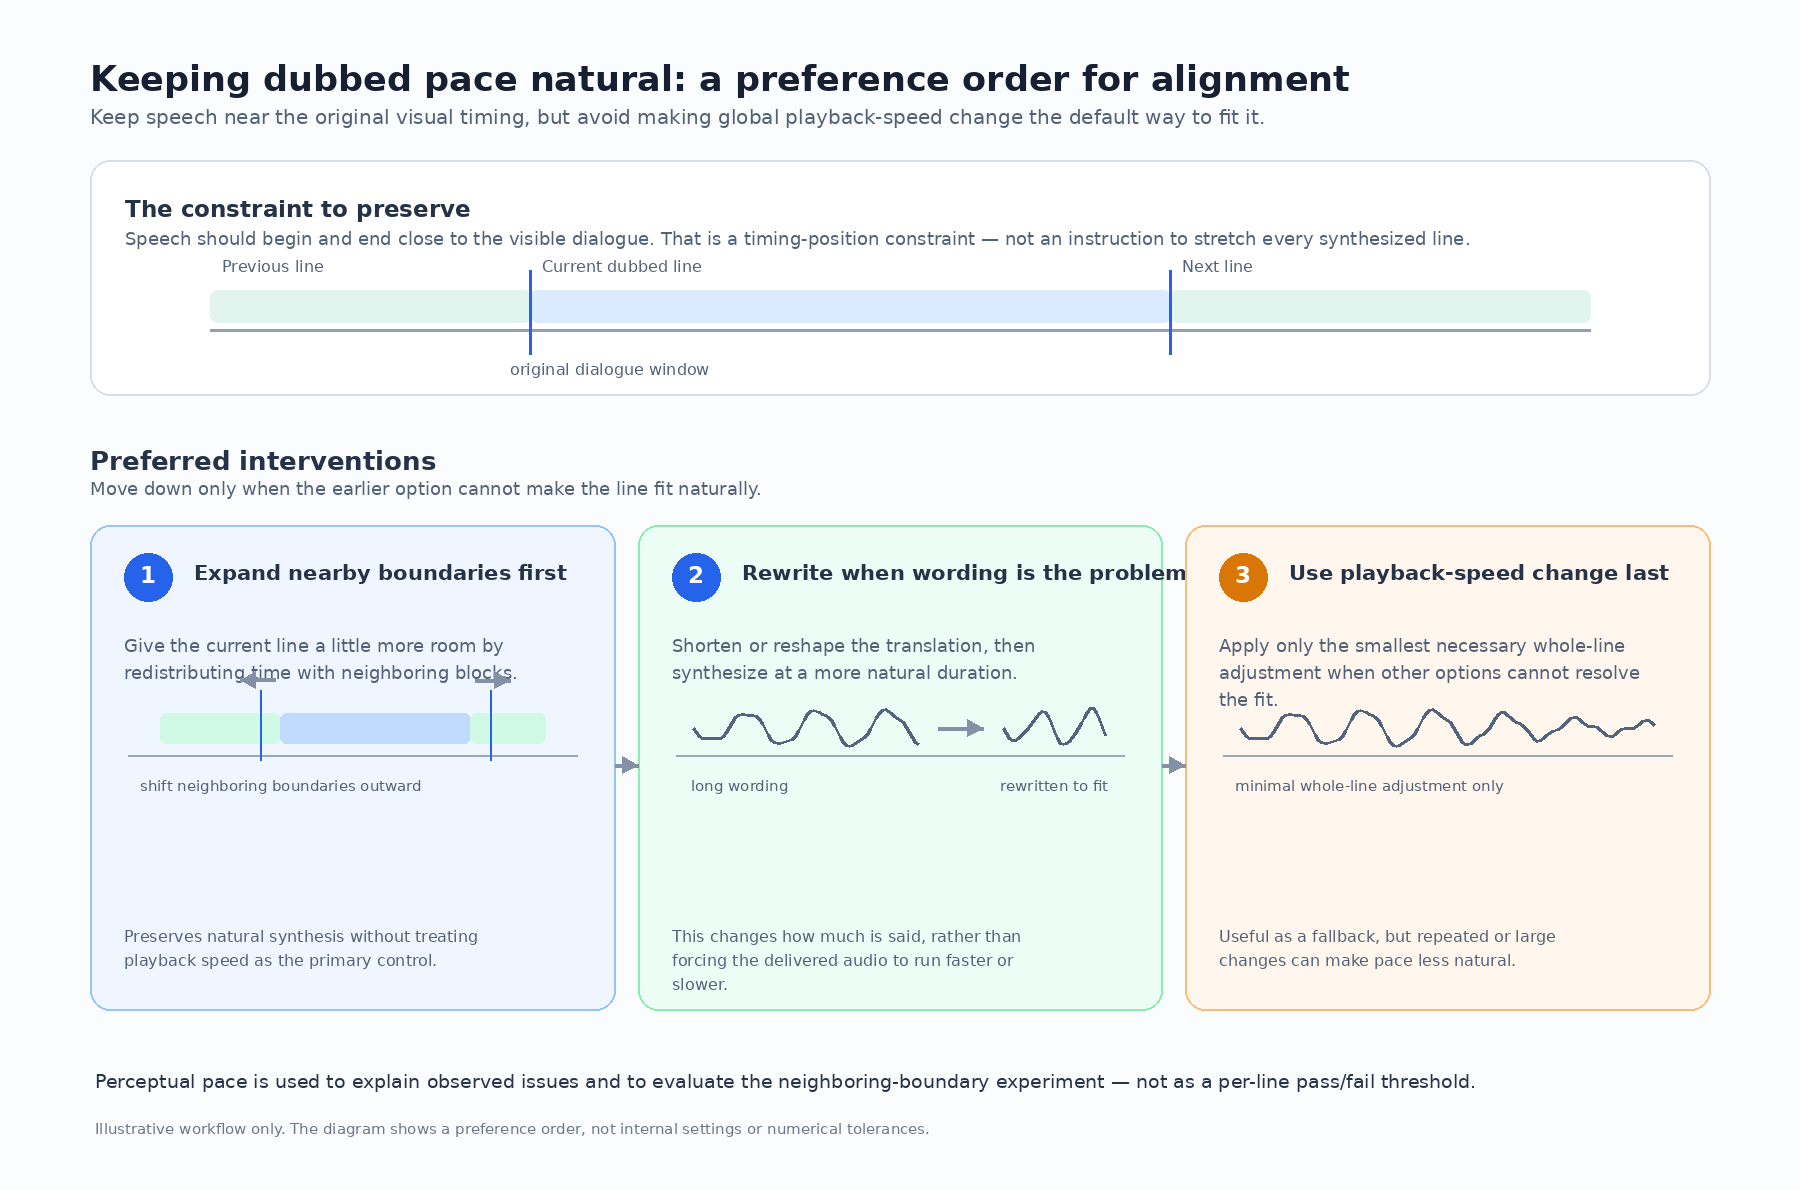
听感语速:配音相对原片的倍速,再按这个语对常见的快慢习惯校正。它问的是落进时间线之后偏快还是偏慢,不是改写前后两版原速谁更快。这 14 句里和耳朵同向;包络、音素、音节密度各有反例。用来解释,以及情况四那种邻句微调实验,不拿来卡每一句。
过快仍然值得拦。过慢如果再设一条必须过的线,我们抽过 50 条听感偏慢的生产句:大多数时间窗已经不能再短,否则容易出现口型仍在继续、声音却已经结束的情况。
展开邻块能少改倍速。改写译文长短,才改得了「说了多少字」,听感和口型可以一起变好,也和 Saboo 把时长约束写进翻译同向。