本系列前几篇文章讨论了对齐,也就是配音音频如何与画面匹配;还讨论了语义,即如何让译文摆脱通用的默认表达。本文关注的是空间问题。添加字幕时,应该在哪里换行?
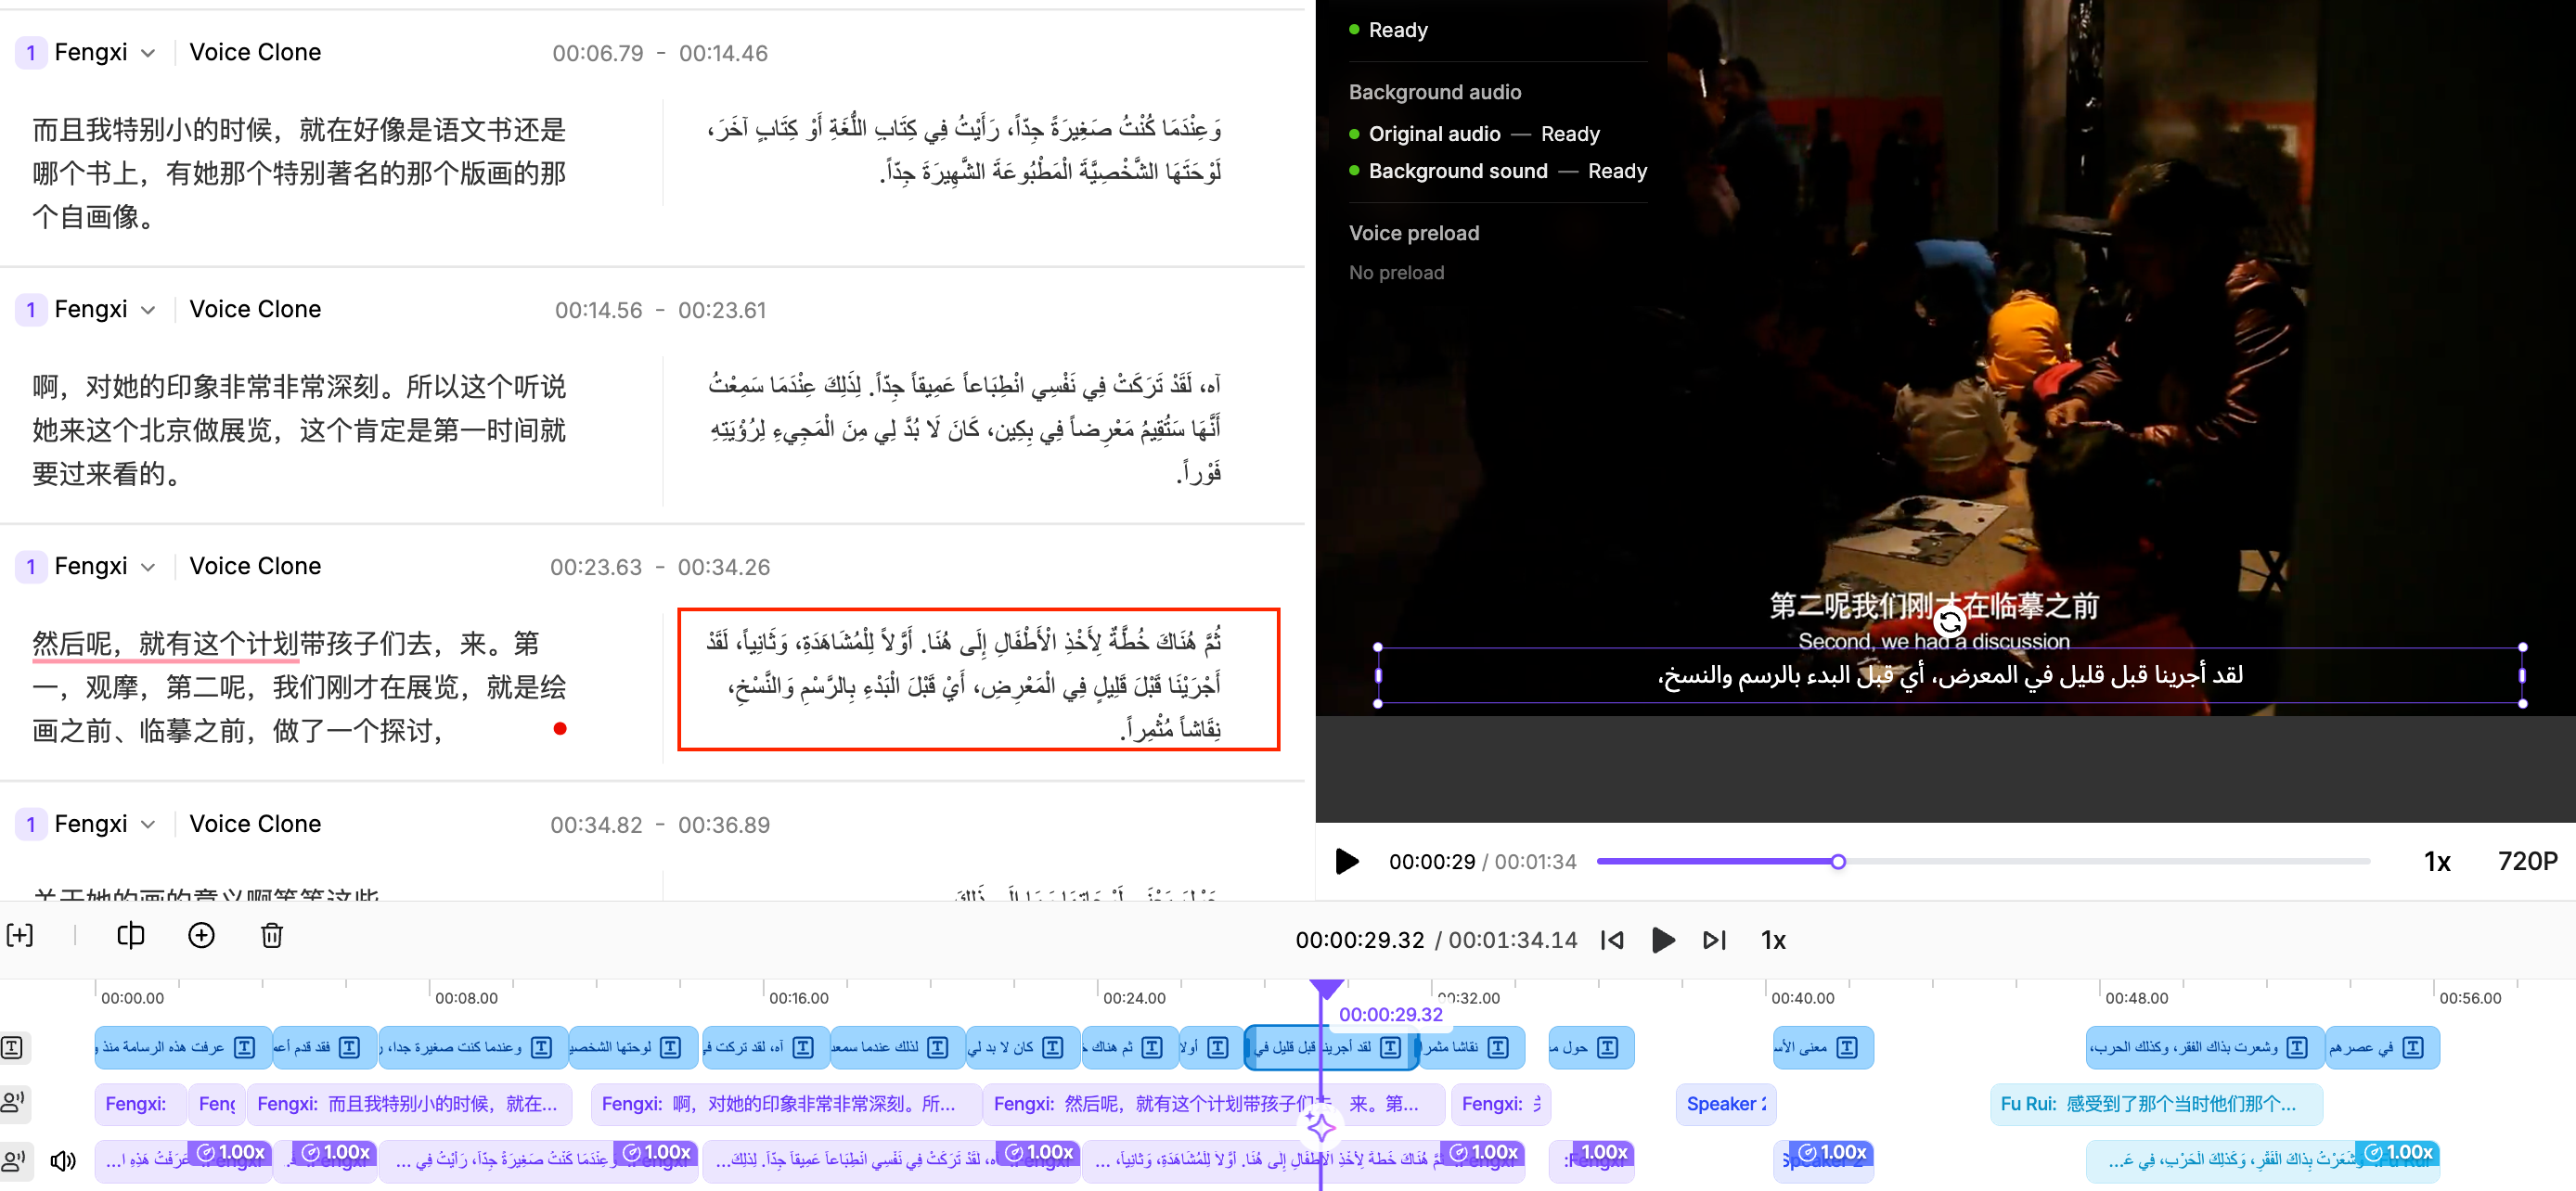
首先需要分清一个很容易混淆的概念:译文会将源文本转换成配音文本,也就是配音演员要朗读的台词。字幕并不是把这句台词直接贴到画面上。它是另一种对象:有时间轴和宽度上限,通常会缩短,有时还需要改写,以便观众在画面运动时迅速读完。现代标准阿拉伯语很直观地体现了这种差异。我们生成的配音文本带有完整的元音符号,以便 AI 朗读器正确发音:
ثُمَّ هُنَاكَ خُطَّةٌ لِأَخْذِ الْأَطْفَالِ إِلَى هُنَا. أَوَّلاً لِلْمُشَاهَدَةِ، وَثَانِياً، لَقَدْ أَجْرَيْنَا قَبْلَ قَلِيلٍ فِي الْمَعْرِضِ، أَيْ قَبْلَ الْبَدْءِ بِالرَّسْمِ وَالنَّسْخِ، نِقَاشاً مُثْمِراً.
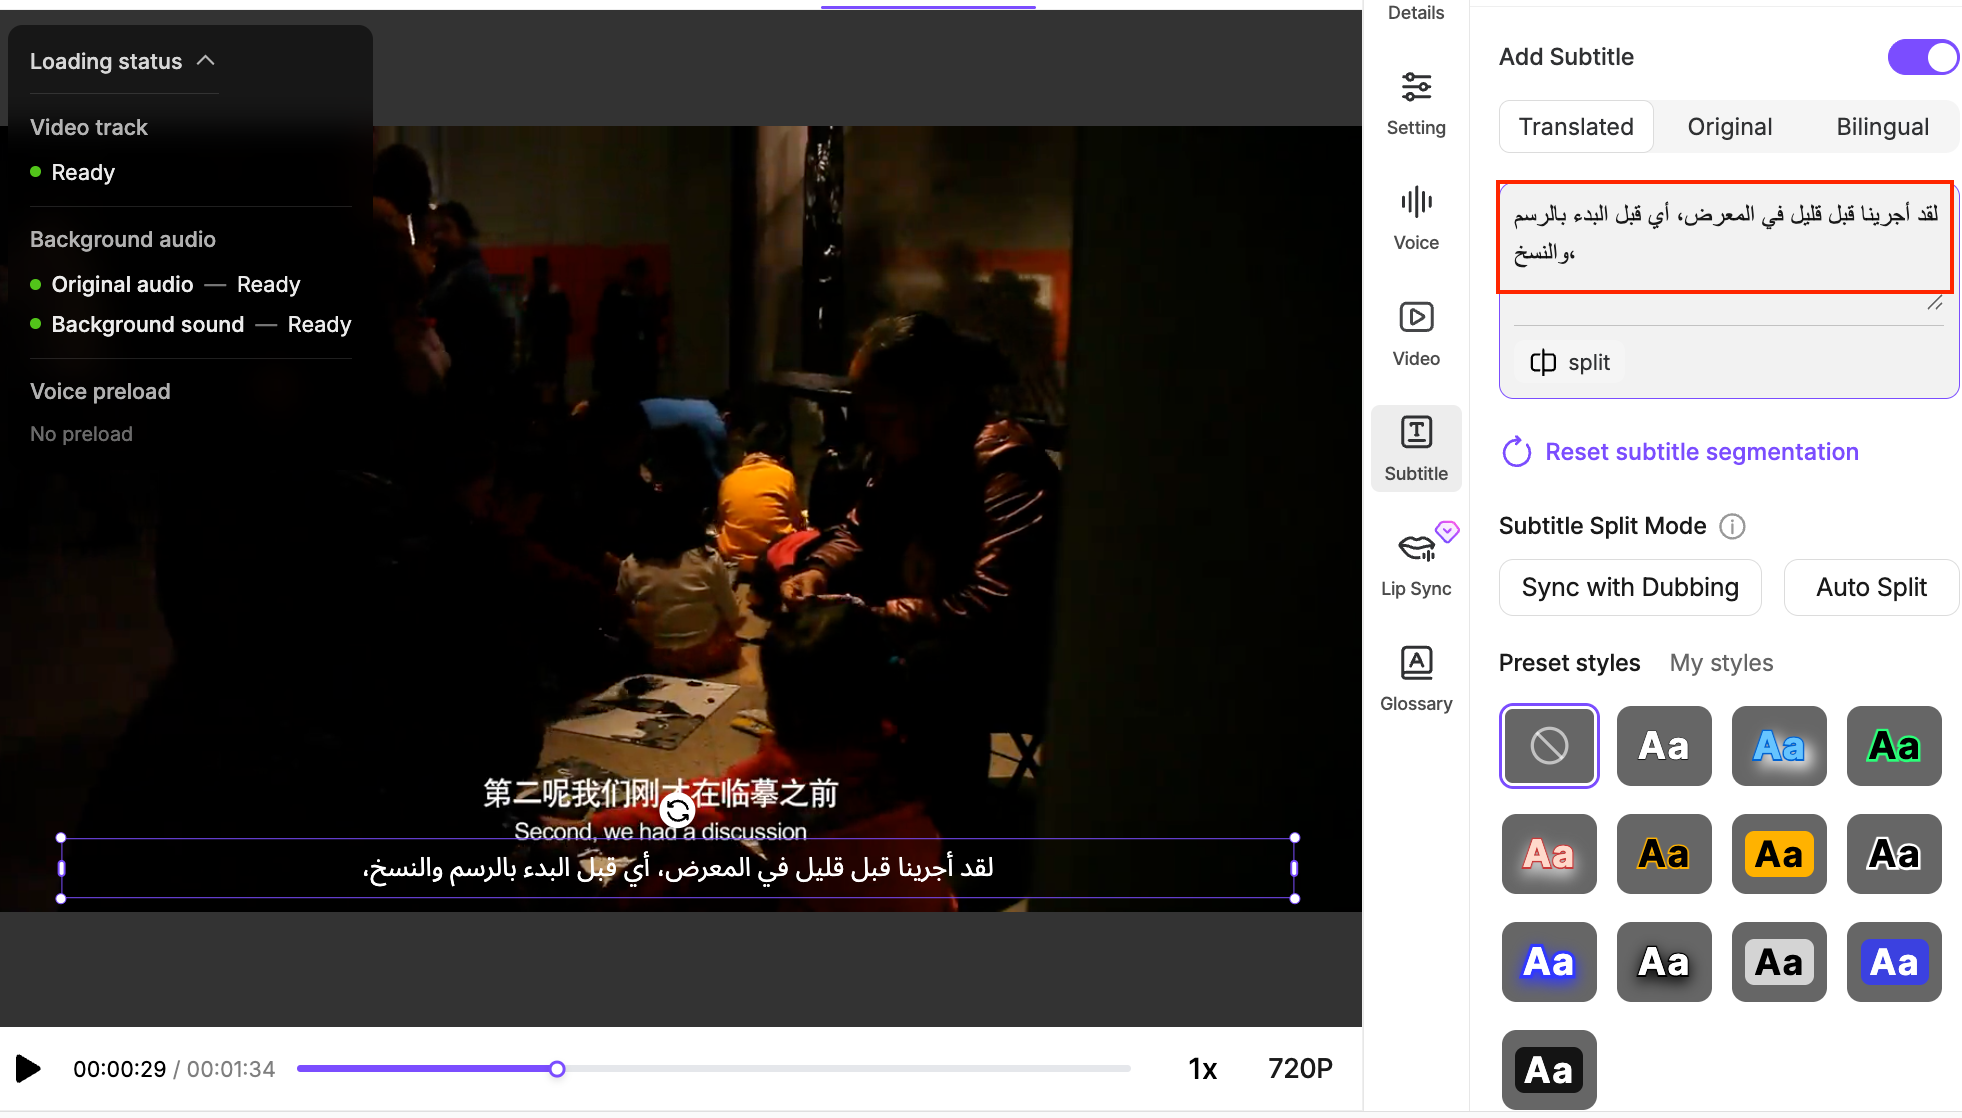
最终显示在屏幕上的字幕已经是另一段文本,只保留一个分句,并去掉语音所需而观众阅读不需要的变音符号:
لقد أجرينا قبل قليل في المعرض، أي قبل البدء بالرسم والنسخ،
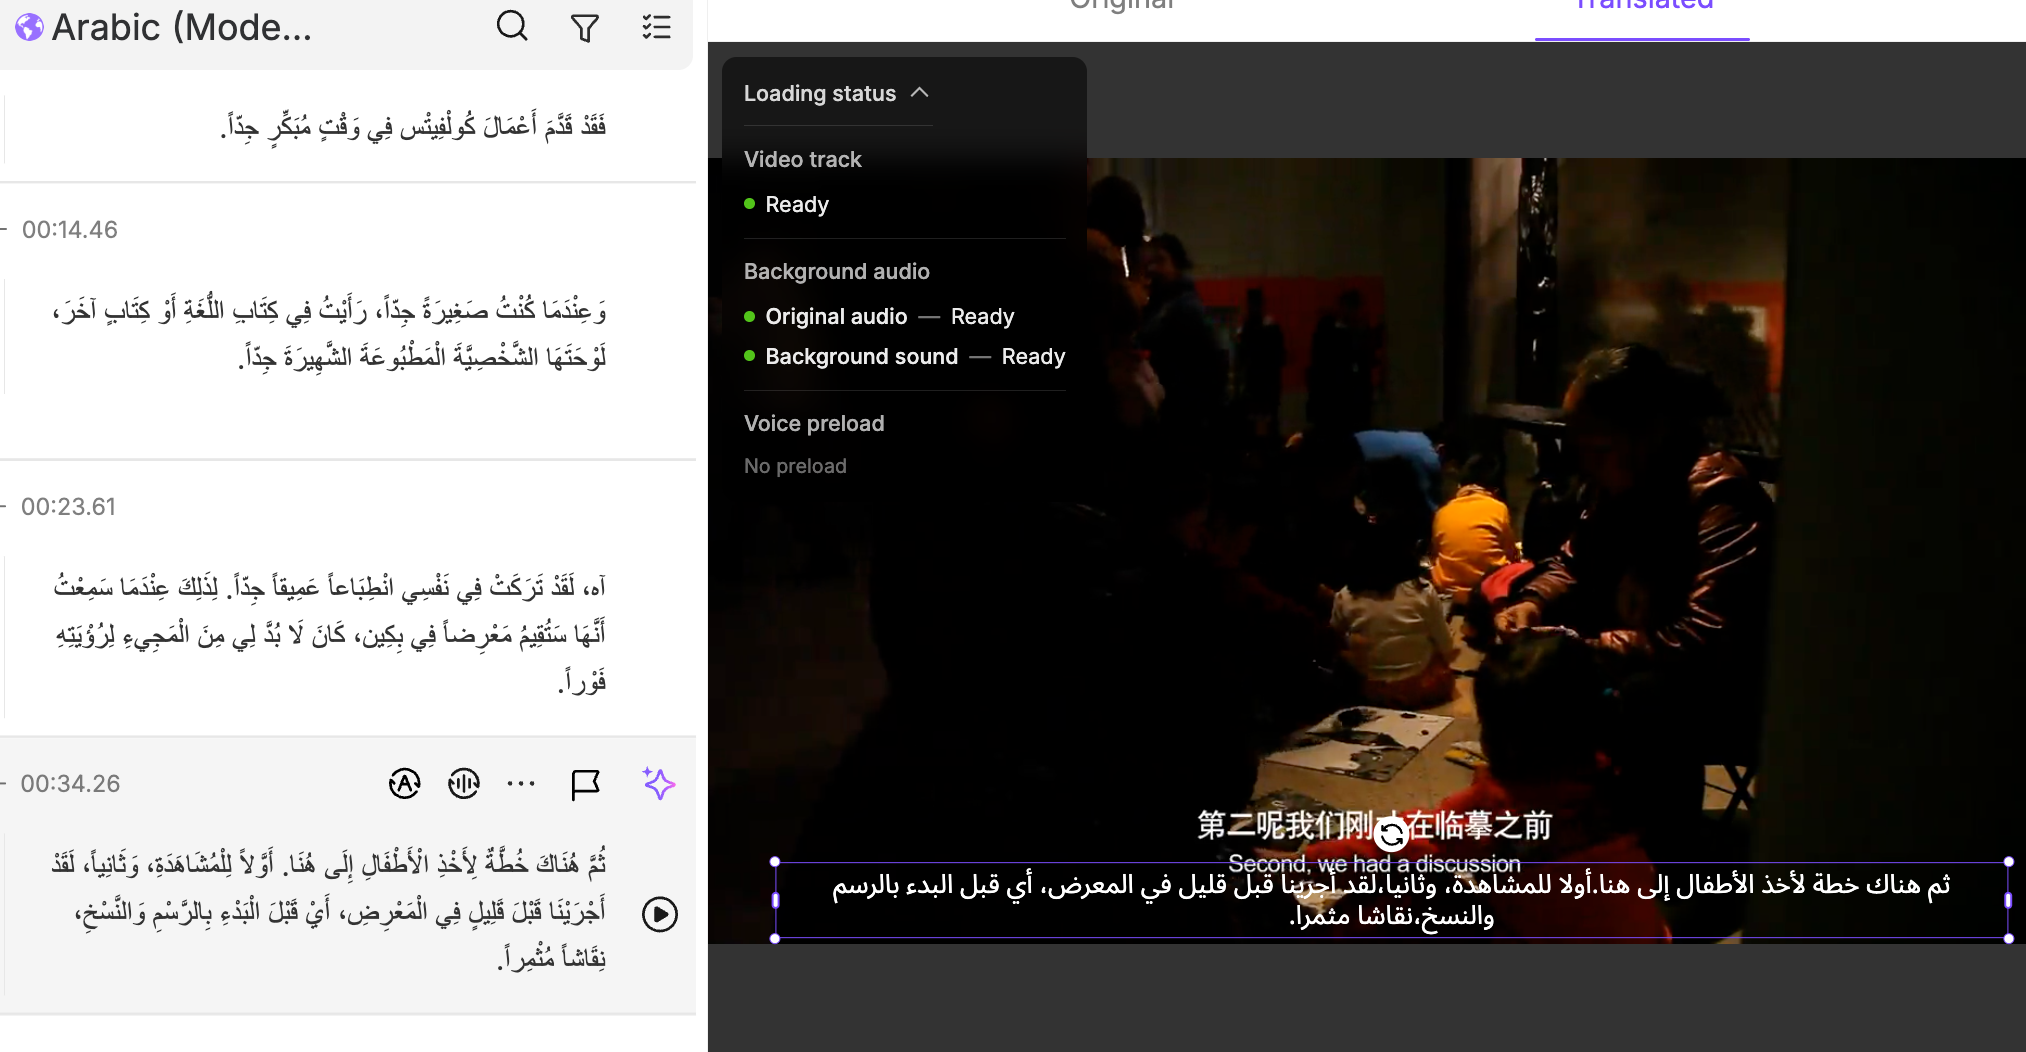
含义相同,语言相同,却不是同一种对象。翻译环节负责配音文本;本文讨论的是字幕,具体来说,就是词句确定之后,应该在哪里换行。
到了 2026 年,人们的第一反应往往是“调用模型”。确实有专门解决这类问题的优秀模型,例如开源句子分割器 [wtpsplit](https://github.com/segment-any-text/wtpsplit)。它的 SaT(“Segment any Text”)模型不依赖标点,就能为 85 种语言确定句子边界。我们用真实字幕,将自己的分割方法与这类神经网络分割器进行了比较。生产字幕的分割流程可以在内部使用模型,但只会用在模型确实能带来价值的环节。很多时候,最终判断仍取决于宽度和布局约束,而不是纯粹的语言边界。
很容易把这个故事讲成“我们的规则胜过了他们的模型”,但事实并非如此。我们用真实字幕测试了两种方法。对于模型真正擅长的问题,也就是判断一段意思在哪里结束、下一段在哪里开始,两者不相上下:有时确定性方案读起来更顺畅,有时 SaT 更好。即使在我们最期待模型胜出的无空格文字场景中,例如泰语,一旦要求每行必须适配画面,两者仍然打成平手。因此,本文不是在为手写规则庆功。我们想讨论的是:当核心对比结果不分高下时,为什么最终上线的仍然是规则,以及这反映了字幕究竟是什么。
一句话里藏着两个问题
当你问字幕应该在哪里换行时,其实是在问两个互不相关的问题:
1. 语义单元在哪里结束?也就是句子和分句的边界。这是语言问题。面对没有标点的 ASR 转写文本等混乱输入时,确实很难处理。
2. 这一行能否放进画面?一行文字有渲染宽度,画面也有宽度。溢出的文字会被裁切或自动缩小。这是几何问题。
神经网络分割器回答的是第一个问题,对第二个问题无能为力。它完全可能给出一个漂亮的句子边界,但对应文本的宽度却是竖屏手机画面的三倍。这两个问题对实际交付产品的重要性也相差很大:换行位置略显生硬,只是观感上的小瑕疵;文字超出屏幕,却是客户会截图反馈的缺陷。模型解决的那一半,恰恰没有另一半重要。
只看边界,确实难分高下
先肯定模型的价值,因为这种价值确实存在。
对于句末标点清晰的语言,确定性方案很容易处理:优先在标点处断开,模型能补充的内容并不多。印地语用 danda(`।`,U+0964)而不是句点结束句子。如果换行标记集合里遗漏了它,天城文就会直接退化成在短语中间硬换行;但只要把 danda 加入集合,“按句末标记切分”基本就能解决问题,SaT 学到的边界位置也大致相同。
按理说,模型应该在缺少标点时拉开差距。泰语、高棉语和缅甸语不使用空格分隔单词,也不会稳定地标记句末。确定性方案会先将其切分为单词,泰语使用词典分词器,再按照宽度预算装入这些词元,并不理解分句在哪里结束。针对这些语言训练的模型则掌握了边界信息。因此,我们实际运行了模型,并用生产流水线中的真实泰语字幕进行对比:神经网络方案先由 SaT 确定句子边界,再使用与生产环境完全相同的宽度适配逻辑。
模型没有领先(真实运行结果,不是模拟示例)
一条泰语字幕会以连续文本的形式进入系统:
วันนี้ผมจะไปตลาดซื้อผักและผลไม้เพื่อทำอาหารเย็น
(“今天我要去市场买蔬菜和水果,准备做晚饭。”)
在竖屏每行 40 个字符的预算下,SaT 将整段文本作为一个单元返回,没有找到可以添加的句子边界。因此,神经网络方案直接进入生产环境已经使用的同一套 pythainlp 宽度适配流程。两者逐字节完全一致,结果都是:
วันนี้ผมจะไปตลาดซื้อผักและผลไม้เพื่อทำ / อาหารเย็น
(第 1 行:“今天我要去市场买蔬菜和水果,准备做” / 第 2 行:“晚饭。”)
需要说明的是,如果第二部分太短,我们确实会采用逻辑对句子进行平均拆分,但泰语中的“晚饭。”似乎还没有短到触发这一逻辑。
换行发生在单词边界,因为词典分词器不能从单词中间切开。这种一致是常态,并非例外:在八条真实泰语字幕中,两种方案有五次完全相同。出现差异时,模型也没有胜出。
最长的连续文本最清楚地体现了这种取舍:
ก็จะมีแบบว่าเกรงใจนิดนึงเพราะว่าเขาเป็นหัวหน้า แล้วเราต้องคอนเซิร์นเกี่ยวกับการใช้จ่ายอะไรอย่างเงี้ยค่ะ
(“只是因为他是老板,我会觉得有点不自在,而且我们还得担心开支之类的问题。”)
我们的方案(3 行):
ก็จะมีแบบว่าเกรงใจนิดนึงเพราะว่าเขาเป็น /
หัวหน้า แล้วเราต้องคอนเซิร์นเกี่ยวกับการ /
ใช้จ่ายอะไรอย่างเงี้ยค่ะ
(第 1 行:“只是因为他是,我会觉得有点不自在” / 第 2 行:“老板,而且我们还得担心” / 第 3 行:“开支之类的问题。”)
SaT 方案(4 行):
ก็จะมีแบบว่าเกรงใจนิดนึงเพราะว่าเขาเป็น /
หัวหน้า /
แล้วเราต้องคอนเซิร์นเกี่ยวกับการใช้จ่าย /
อะไรอย่างเงี้ยค่ะ
(第 1 行:“只是因为他是,我会觉得有点不自在” / 第 2 行:“老板,” / 第 3 行:“而且我们还得担心开支” / 第 4 行:“之类的问题。”)
SaT 遵循了一个被我们的宽度适配逻辑跳过的分句边界,却把 หัวหน้า(“老板”)单独留在了一行。这种额外换行在纸面上读起来没有问题,实际使用时却会占掉完整的一行字幕。
SaT 只有一次给出了读起来更自然的边界,但代价是使用三个半空的行,而我们的方案只用了两行:
เจอกันครั้งแรกเขาเป็น อ่า ฝ่ายบัญชีใช่ไหมคะ ซึ่งเราต้องทำงานกับเขา
(“我们第一次见面时,他是,呃,会计部门的,对吧?我们得和他一起工作。”)
我们的方案(2 行):
เจอกันครั้งแรกเขาเป็น อ่า ฝ่ายบัญชี /
ใช่ไหมคะ ซึ่งเราต้องทำงานกับเขา
(第 1 行:“我们第一次见面时,他是,呃,会计部门的,” / 第 2 行:“对吧?我们得和他一起工作。”)
SaT 方案(3 行):
เจอกันครั้งแรกเขาเป็น /
อ่า ฝ่ายบัญชีใช่ไหมคะ /
ซึ่งเราต้องทำงานกับเขา
(第 1 行:“我们第一次见面时,他是,” / 第 2 行:“呃,会计部门的,对吧?” / 第 3 行:“我们得和他一起工作。”)
SaT 的换行更贴近说话节奏,但多占了一行,而字幕设计通常会尽量避免这种情况。
所以,我们并不是声称自己的分割效果更好。我们的结论是,两者的分割质量大致相当,平局时就要看其他所有因素。下面逐一说明这些因素。
模型无法处理的另一半:适配画面
无论是否使用模型,画面适配问题都必须由我们解决,而且相关逻辑占据了大部分代码。它分为三个部分。
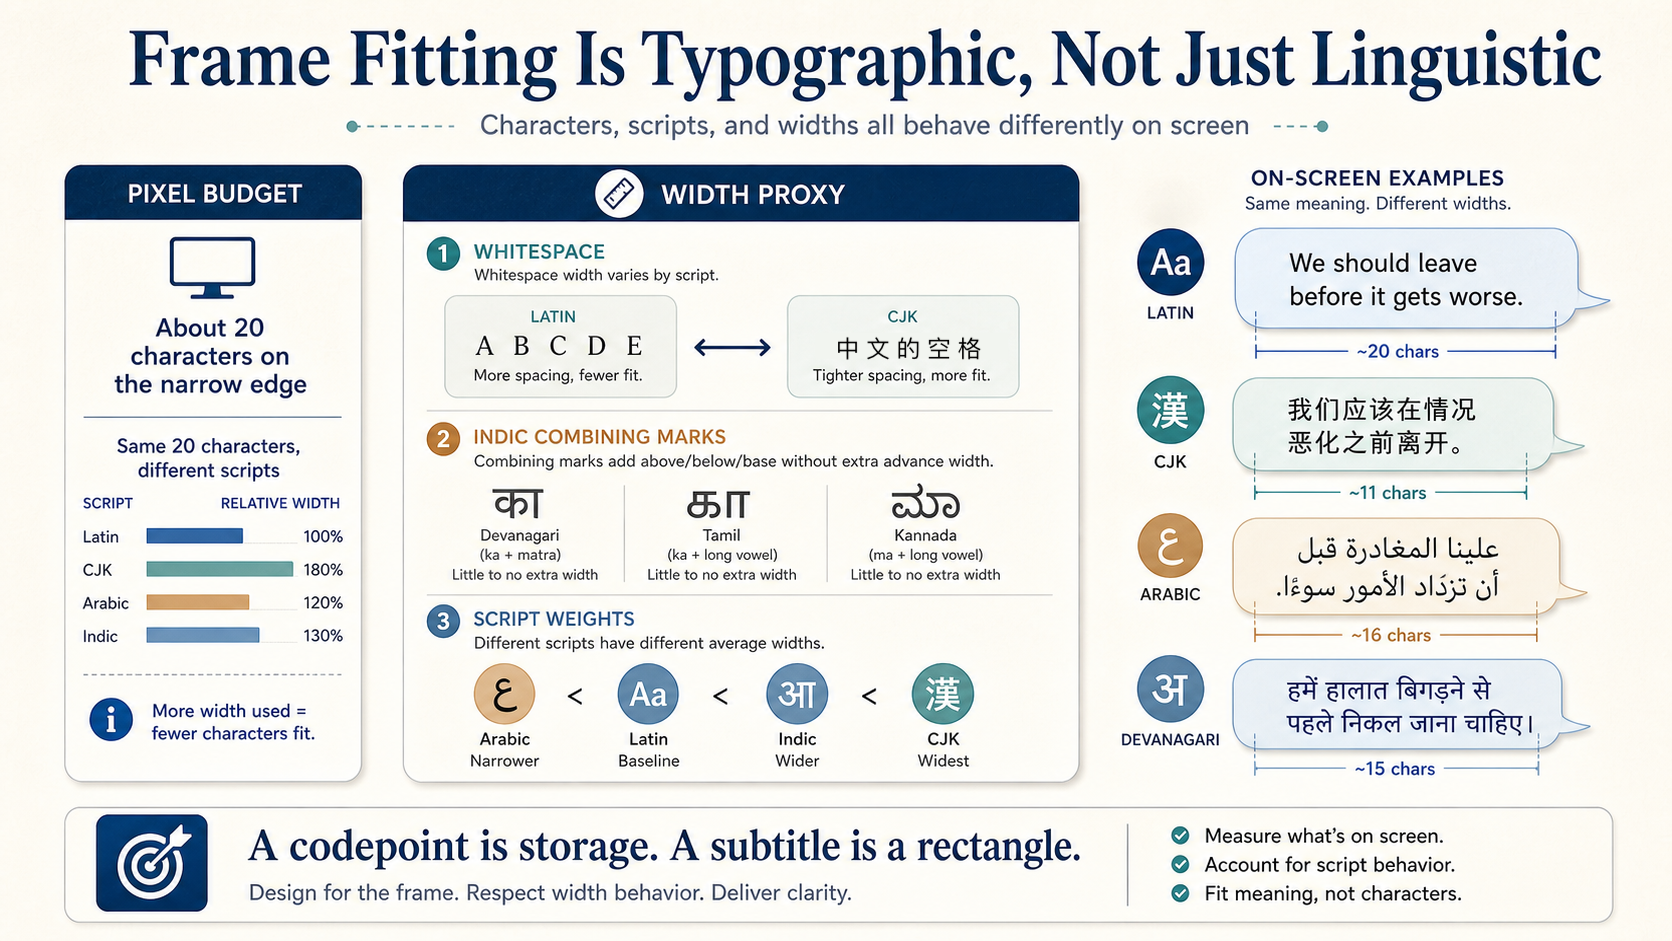
根据像素换算字符预算。粗略来说,画面的短边可以舒适地容纳约二十个字符;横屏可容纳更多,竖屏则更少,具体数量也会随字号变化。实际上有两套预算,因为一个拉丁字符的宽度约为一个中日韩字符的一半,所以拉丁文字每行允许接近两倍的字符数,最终在屏幕上才会达到相近的宽度。这也引出了整个问题的关键:从宽度角度看,什么才算一个“字符”?
使用宽度代理值,因为码位并不是宽度单位。直接计算码位数量会在三个方向上出错,分别对应传统拉丁文字与中日韩文字思维之外的三类文字:
- 空白字符的宽度并不统一。
在拉丁文字中,空格是参与换行计算的实际单位;在中日韩文字中,它大多只是噪声。宽度代理会忽略中日韩文字中的空格,并在其他文字中对其进行归一化。
- 印度文字的组合标记并不都会占用空间。
`मैसेज` 包含五个码位,但在屏幕上并不是五个独立占位的元素。两个元音符号(`ै`、`े`)位于辅音上方,不占用水平前进宽度。Unicode 将它们称为非间距标记(`Mn`)或包围标记(`Me`),因此可以安全地从宽度计数中排除。间距组合标记(`Mc`)则相反:印地语 `का` 的宽度并不是一个字符单元,而是 `क` 加上较宽的 `ा`;泰米尔语 `கா` 中的 `ா` 也是如此。不同文字对这类间距标记的依赖程度,是婆罗米系文字之间最显著的宽度差异。在真实字幕文本中,顺序很清楚:泰米尔文的间距标记最密集,其次是天城文,卡纳达文紧随其后。因此,字符数相同的泰米尔语在屏幕上经常比印地语更宽。如果去掉间距标记,恰恰会抹平这种差异,随后只能为每种文字不断设计手动调优的常量。保留这些标记后,只需使用一个基于天城文校准过的权重,就能同时覆盖所有印度文字。
- 字形宽度取决于文字系统。
阿拉伯文字比拉丁文字宽,印度文字的 akshara 音节单位还要更宽,因此每类文字都需要设置权重。这些不是语言学事实,而是字体排印特征,单靠计算无法确定,最终取决于字体。各项权重会作为可调校参数保留,并以实际渲染画面而不是规范文档为准进行检查。
这些信息都不是句子边界模型能够从文本中掌握或学习的,因为它们描述的是字形如何呈现,而不是字形表达什么含义。
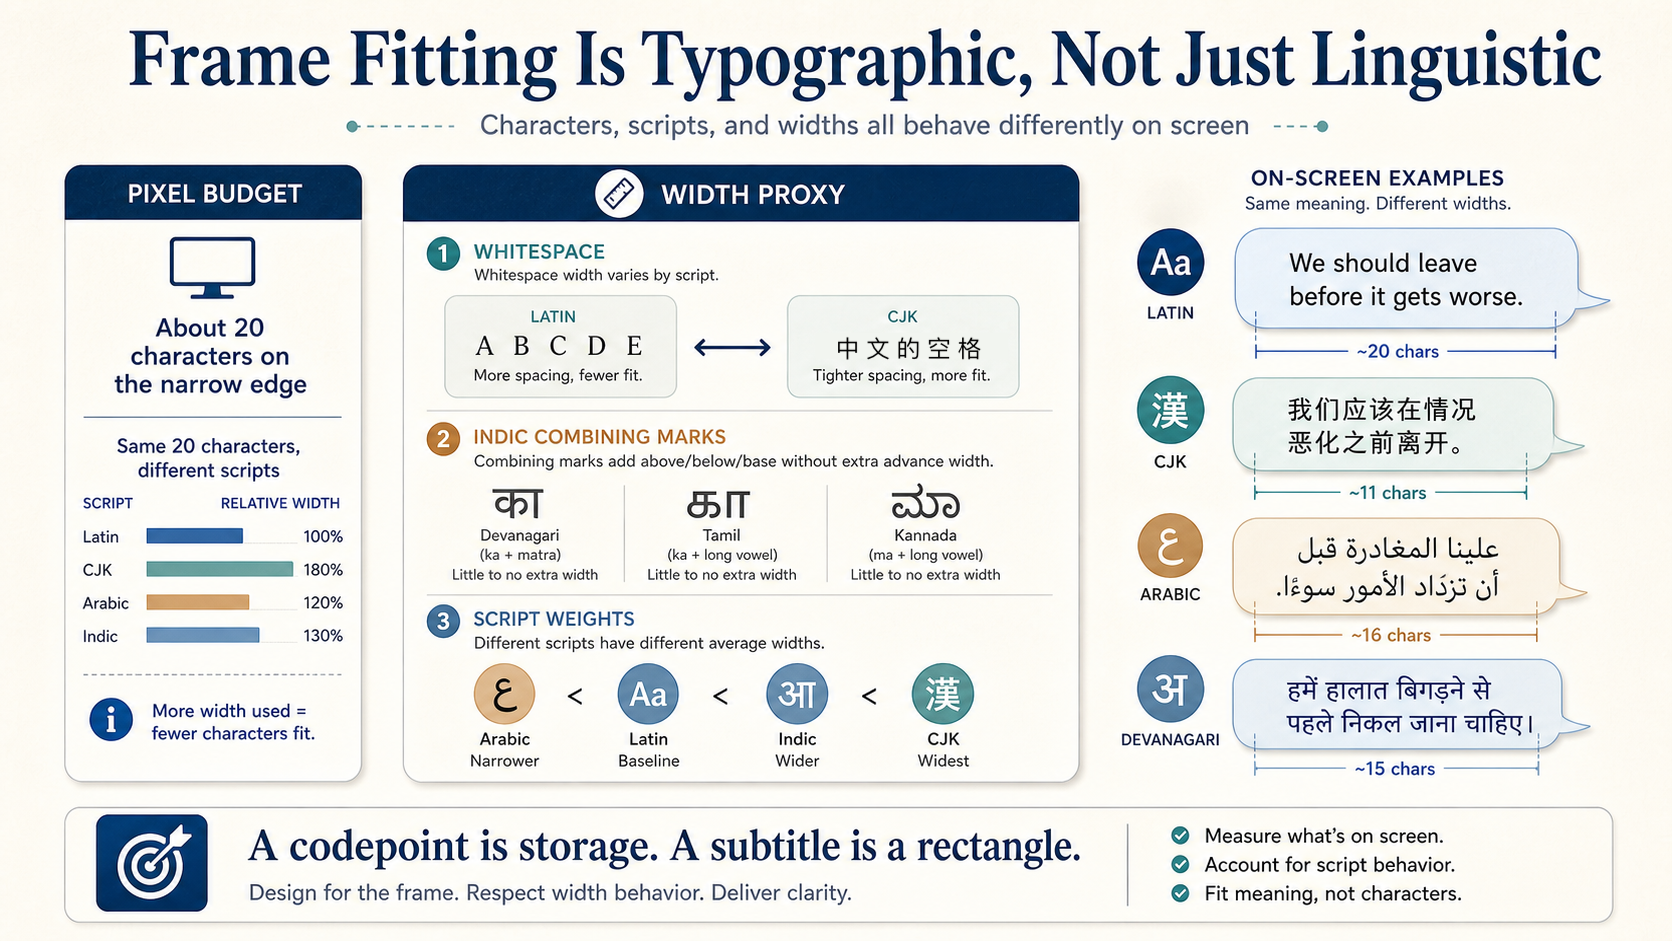
它需要覆盖多少业务量?近期抽样的 4,563 个字幕任务涵盖 98 个目标区域设置和 60 种基础语言:
| 文字系统类别 | 任务占比 |
|---|---|
| 拉丁文字及其他 | 63% |
| 中日韩文字(宽字符) | 22% |
| 阿拉伯文字 | 7% |
| 印度文字(婆罗米系) | 4% |
| 东南亚无空格文字(泰语/高棉语/缅甸语/老挝语) | 3% |
超过三分之一的任务使用“码位 = 宽度”明显不成立的文字系统,而分割器完全看不到这部分信息。它只能识别分句边界,不知道文字渲染出来有多宽。
解决完整问题
以上内容仍然只是问题的一部分。
句子分割器擅长解决一个问题:判断一段意思在哪里结束。VMEG 的生产字幕系统则必须解决完整问题。它要让文字适配画面、对齐双语字幕、支持数十种文字系统,还要在生产环境中高效运行。无论是否使用神经网络模型,这些约束都始终存在。因此,确定性流水线仍是系统的骨干,模型只在确实能创造价值的环节作为可选辅助工具。
一句话总结
码位是存储单位,句子边界是语义单位。字幕需要读起来顺畅,但首先必须放得进画面。